Java SE
变量与运算符 关键字 定义:被Java语言赋予了特殊含义,用做专门用途的字符串或单词 特点:全部关键字都是小写 标识符 Java中变量、方法、类等要素命名时使用的字符序列,称为标识符(也就是需要自己起名字的地方) 标识符的命令规则 由26个英文字母大小写,0 9, 或者 $ 组成 数字不可以开头 不可以使用关键字和保留
变量与运算符
关键字
定义:被Java语言赋予了特殊含义,用做专门用途的字符串或单词
特点:全部关键字都是小写
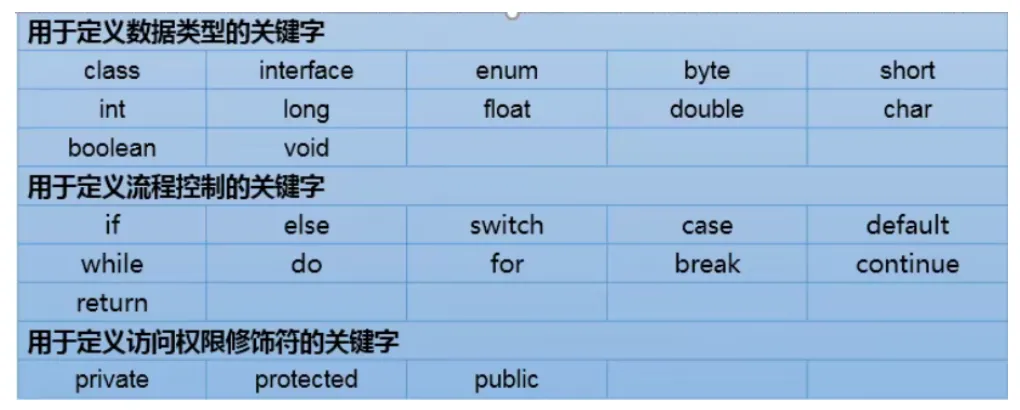
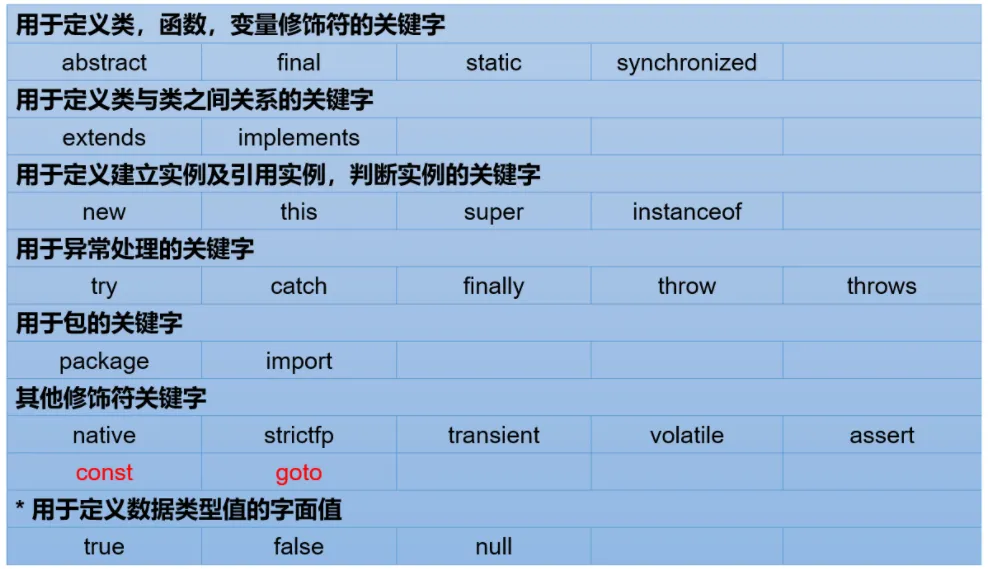
标识符
Java中变量、方法、类等要素命名时使用的字符序列,称为标识符(也就是需要自己起名字的地方)
标识符的命令规则
由26个英文字母大小写,0-9,_ 或者 $ 组成
数字不可以开头
不可以使用关键字和保留字,但能包含关键字和保留字
Java中严格区分大小写,长度无限制
标识符不能包含空格
变量
变量是程序中不可或缺的组成单位,是最基础的存储单元
变量的概念:
-
内存中的一个存储区域,该区域的数据可以在同一类型范围内不断的变化
-
变量构成的三个要素:
数据类型、变量名、存储的值 -
Java中变量声明的格式:
数据类型 变量名 = 变量值
变量的作用:用于在内存中保存数据
数据类型
基本数据类型:
-
整型:byte short int long
-
浮点型:float double
-
字符型:char
-
布尔型:boolean
引用数据类型:
-
类:class
-
数组:array
-
接口:interface
-
枚举:enum
-
注解:annotation
-
记录:record
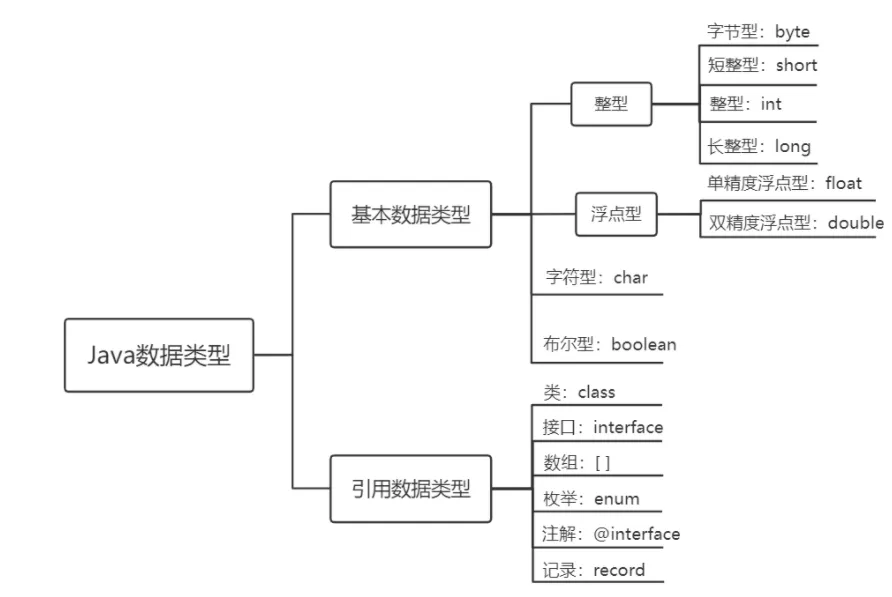
定义变量时,变量名要遵循标识符命名的规则和规范
使用
变量的声明
格式: 数据类型 变量名;//例如:
//存储一个整数类型的年龄
int age;
//存储一个小数类型的体重
double weight;
//存储一个单字符类型的性别
char gender;
//存储一个布尔类型的婚姻状态
boolean marry;
//存储一个字符串类型的姓名
String name;
//声明多个同类型的变量
int a,b,c; //表示a,b,c三个变量都是int类型。注意:变量的数据类型可以是基本数据类型,也可以是引用数据类型
变量赋值
给变量赋值,就是把“值”存到该变量代表的内存空间中。同时,给变量赋的值类型必须与变量声明的类型一致或兼容
变量赋值的语法格式:
变量名 = 值;举例1:可以使用合适类型的常量值给已经声明的变量赋值
age = 18;
weight = 109;
gender = '女';举例2:可以使用其他变量或者表达式给变量赋值
int m = 1;
int n = m;

int x = 1;
int y = 2;
int z = 2 * x + y;3:变量可以反复赋值
//先声明,后初始化
char gender;
gender = '女';

//给变量重新赋值,修改gender变量的值
gender = '男';
System.out.println("gender = " + gender);//gender = 男举例4:也可以将变量的声明和赋值一并执行
boolean isBeauty = true;
String name = "迪丽热巴";内存结构如图:
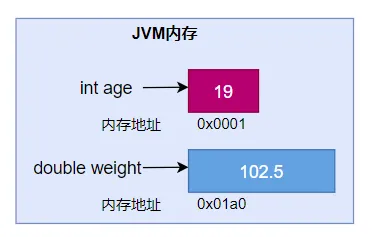
基本数据类型
整数类型
Java各整数类型有固定的表数范围和字段长度,不受具体操作系统的影响,以保证Java程序的可移植性
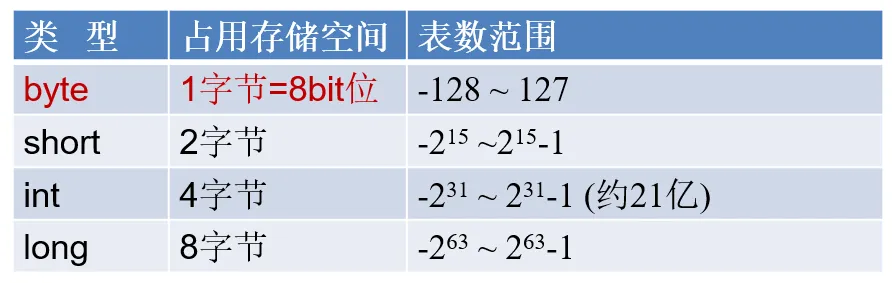
定义long类型的变量,赋值时需要以"l"或"L"作为后缀
Java程序中变量通常声明为int型,除非不足以表示较大的数,才使用long
Java的整型常量默认为 int 型
计算机存储单位
-
**字节(Byte):**是计算机用于计量存储容量的基本单位,一个字节等于8 bit
-
**位(bit):**是数据存储的最小单位。二进制数系统中,每个0或1就是一个位,叫做bit(比特),其中8 bit 就称为一个字节(Byte)
-
转换关系:
-
8 bit = 1 Byte
-
1024 Byte = 1 KB
-
1024 KB = 1 MB
-
1024 MB = 1 GB
-
1024 GB = 1 TB
浮点型
与整数类型类似,Java 浮点类型也有固定的表数范围和字段长度,不受具体操作系统的影响
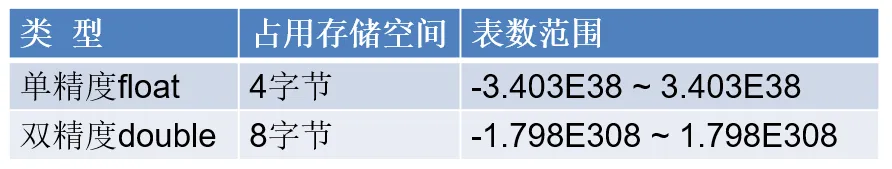
浮点型常量有两种表示形式:
-
十进制数形式。如:5.12 512.0f .512 (必须有小数点)
-
科学计数法形式。如:5.12e2 512E2 100E-2
float:单精度,尾数可以精确到7位有效数字。很多情况下,精度很难满足需求。
double:双精度,精度是float的两倍。通常采用此类型。
定义float类型的变量,赋值时需要以"f"或"F"作为后缀。
Java 的浮点型常量默认为double型。
关于浮点型精度
-
并不是所有的小数都能可以精确的用二进制浮点数表示。二进制浮点数不能精确的表示0.1、0.01、0.001这样10的负次幂
-
浮点类型float、double的数据不适合在不容许舍入误差的金融计算领域。如果需要精确数字计算或保留指定位数的精度,需要使用BigDecimal类
字符型
-
char 型数据用来表示通常意义上“字符”(占2字节)
-
Java中的所有字符都使用Unicode编码,故一个字符可以存储一个字母,一个汉字,或其他书面语的一个字符。
-
字符型变量的三种表现形式:
-
**形式1:**使用单引号(' ')括起来的单个字符。例如:char c1 = 'a'; char c2 = '中'; char c3 = '9';
-
**形式2:**直接使用 Unicode值来表示字符型常量:‘\uXXXX’。其中,XXXX代表一个十六进制整数。例如:\u0023 表示 '#'。
-
**形式3:**Java中还允许使用转义字符‘\’来将其后的字符转变为特殊字符型常量。例如:char c3 = '\n'; // '\n'表示换行符
布尔类型
-
boolean 类型用来判断逻辑条件,一般用于流程控制语句中:
-
if条件控制语句;
-
while循环控制语句;
-
for循环控制语句;
-
do-while循环控制语句;
-
boolean类型数据只有两个值:true、false,无其它
-
不可以使用0或非 0 的整数替代false和true,这点和C语言不同
-
拓展:Java虚拟机中没有任何供boolean值专用的字节码指令,Java语言表达所操作的boolean值,在编译之后都使用java虚拟机中的int数据类型来代替:true用1表示,false用0表示
基本数据类型变量间运算规则
转换的方式有两种:自动类型提升和强制类型转换
自动类型转换
规则:将取值范围小(或容量小)的类型自动提升为取值范围大(或容量大)的类型
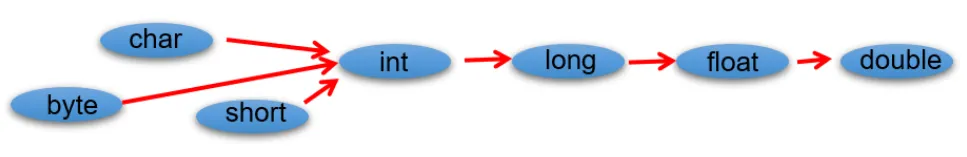
(1)当把存储范围小的值(常量值、变量的值、表达式计算的结果值)赋值给了存储范围大的变量时
(2)当存储范围小的数据类型与存储范围大的数据类型变量一起混合运算时,会按照其中最大的类型运算
(3)当byte,short,char数据类型的变量进行算术运算时,按照int类型处理
强制类型转换
规则:将取值范围大(或容量大)的类型强制转换成取值范围小(或容量小)的类型
转换格式:
数据类型1 变量名 = (数据类型1)被强转数据值; //()中的数据类型必须<=变量值的数据类型
(1)当把存储范围大的值(常量值、变量的值、表达式计算的结果值)强制转换为存储范围小的变量时,可能会损失精度或溢出。
(2)当某个值想要提升数据类型时,也可以使用强制类型转换。这种情况的强制类型转换是没有风险的,通常省略。
(3)声明long类型变量时,可以出现省略后缀的情况。float则不同。
基本数据类型与String 的转换
字符串类型
-
String不是基本数据类型,属于引用数据类型
-
使用一对""来表示一个字符串,内部可以包含0个、1个或多个字符。
-
声明方式与基本数据类型类似
转换规则
1、任意八种基本数据类型的数据与String类型只能进行连接“+”运算,且结果一定也是String类型
System.out.println("" + 1 + 2);//12

int num = 10;
boolean b1 = true;
String s1 = "abc";

String s2 = s1 + num + b1;
System.out.println(s2);//abc10true

//String s3 = num + b1 + s1;//编译不通过,因为int类型不能与boolean运算
String s4 = num + (b1 + s1);//编译通过2、String类型不能通过强制类型()转换,转为其他的类型
String str = "123";
int num = (int)str;//错误的

int num = Integer.parseInt(str);//正确的,后面才能讲到,借助包装类的方法才能转运算符
运算符的分类:
按照功能分为:算术运算符、赋值运算符、比较(或关系)运算符、逻辑运算符、位运算符、条件运算符、Lambda运算符
| 分类 | 运算符 |
|---|---|
| 算术运算符(7个) | +、-、*、/、%、++、-- |
| 赋值运算符(12个) | =、+=、-=、*=、/=、%=、>>=、<<=、>>>=、&=、|=、^=等 |
| 比较(或关系)运算符(6个) | >、>=、<、<=、==、!= |
| 逻辑运算符(6个) | &、|、^、!、&&、|| |
| 位运算符(7个) | &、|、^、~、<<、>>、>>> |
| 条件运算符(1个) | (条件表达式)?结果1:结果2 |
| Lambda运算符(1个) | ->(第18章时讲解) |
按照操作数个数分为:一元运算符(单目运算符)、二元运算符(双目运算符)、三元运算符 (三目运算符)
| 分类 | 运算符 |
|---|---|
| 一元运算符(单目运算符) | 正号(+)、负号(-)、++、--、!、~ |
| 二元运算符(双目运算符) | 除了一元和三元运算符剩下的都是二元运算符 |
| 三元运算符 (三目运算符) | (条件表达式)?结果1:结果2 |
算数运算符
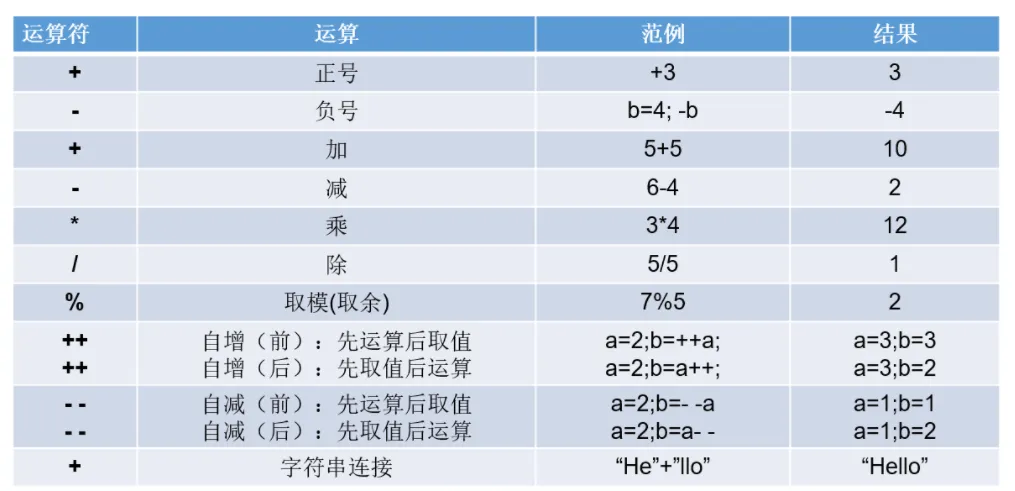
赋值运算符
-
符号:=
-
当“=”两侧数据类型不一致时,可以使用自动类型转换或使用强制类型转换原则进行处理
-
支持连续赋值
-
扩展赋值运算符: +=、 -=、*=、 /=、%=
| 赋值运算符 | 符号解释 |
|---|---|
| += | 将符号左边的值和右边的值进行相加操作,最后将结果赋值给左边的变量 |
| -= | 将符号左边的值和右边的值进行相减操作,最后将结果赋值给左边的变量 |
| *= | 将符号左边的值和右边的值进行相乘操作,最后将结果赋值给左边的变量 |
| /= | 将符号左边的值和右边的值进行相除操作,最后将结果赋值给左边的变量 |
| %= | 将符号左边的值和右边的值进行取余操作,最后将结果赋值给左边的变量 |
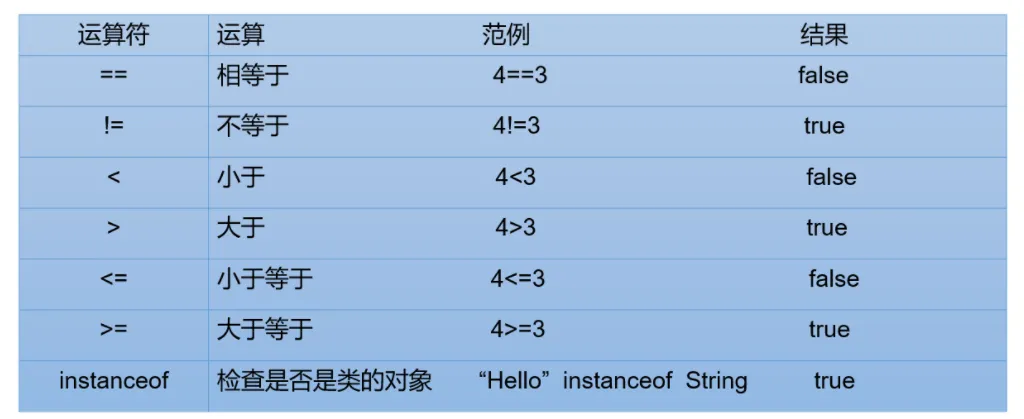
比较(关系)运算符
-
比较运算符的结果都是boolean型,也就是要么是true,要么是false。
-
< >= <= :只适用于基本数据类型(除boolean类型之外)== != :适用于基本数据类型和引用数据类型
-
比较运算符“==”不能误写成“=”
逻辑运算符
-
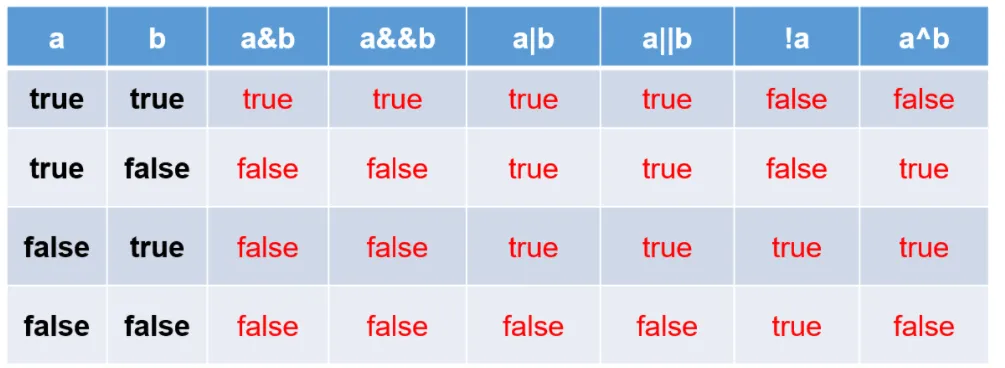
逻辑运算符,操作的都是boolean类型的变量或常量,而且运算得结果也是boolean类型的值。
-
运算符说明:
-
& 和 &&:表示"且"关系,当符号左右两边布尔值都是true时,结果才能为true。否则,为false。
-
| 和 || :表示"或"关系,当符号两边布尔值有一边为true时,结果为true。当两边都为false时,结果为false
-
! :表示"非"关系,当变量布尔值为true时,结果为false。当变量布尔值为false时,结果为true。
-
^ :当符号左右两边布尔值不同时,结果为true。当两边布尔值相同时,结果为false。
-
理解:异或,追求的是“异”!
-
逻辑运算符用于连接布尔型表达式,在Java中不可以写成 3 < x < 6,应该写成x > 3 & x < 6 。
-
区分“&”和“&&”:
-
相同点:如果符号左边是true,则二者都执行符号右边的操作
-
不同点:& : 如果符号左边是false,则继续执行符号右边的操作
-
&& :如果符号左边是false,则不再继续执行符号右边的操作
-
建议:开发中,推荐使用 &&
-
区分“|”和“||”:
-
相同点:如果符号左边是false,则二者都执行符号右边的操作
-
不同点:| : 如果符号左边是true,则继续执行符号右边的操作|| :如果符号左边是true,则不再继续执行符号右边的操作
-
建议:开发中,推荐使用 ||
位运算符
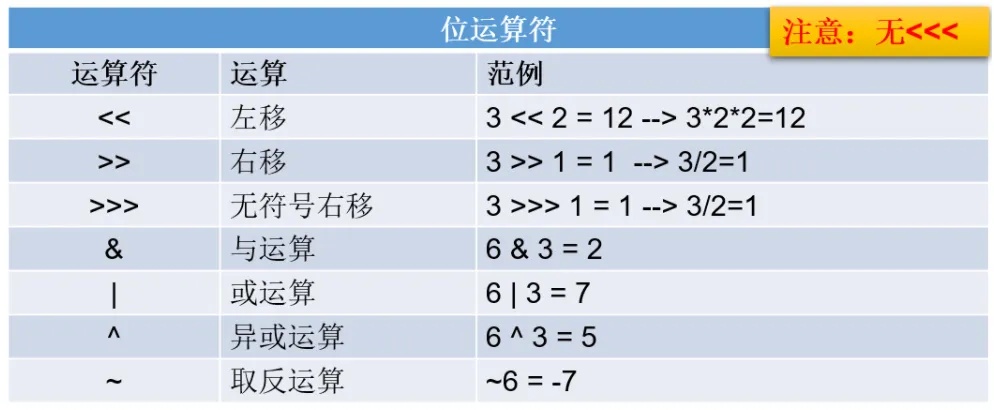
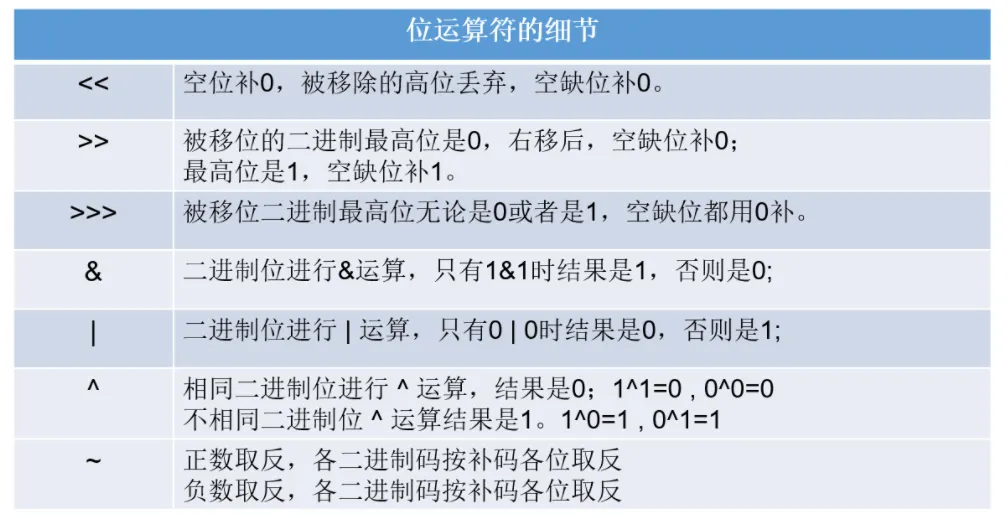
位运算符的运算过程都是基于二进制的补码运算
条件运算符
条件运算符格式:
(条件表达式)? 表达式1:表达式2说明:条件表达式是boolean类型的结果,根据boolean的值选择表达式1或表达式2
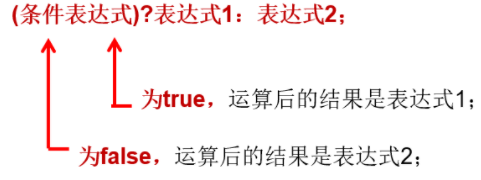
如果运算后的结果赋给新的变量,要求表达式1和表达式2为同种或兼容的类型
流程控制语句
分支语句
if-else
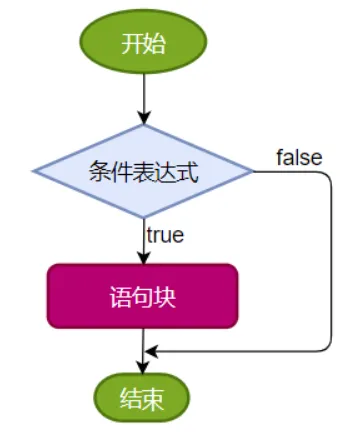
单分支
格式
if(条件表达式){
          语句块;
}说明:条件表达式必须是布尔表达式(关系表达式或逻辑表达式)或 布尔变量
执行流程:
-
首先判断条件表达式看其结果是true还是false
-
如果是true就执行语句块
-
如果是false就不执行语句块
双分支
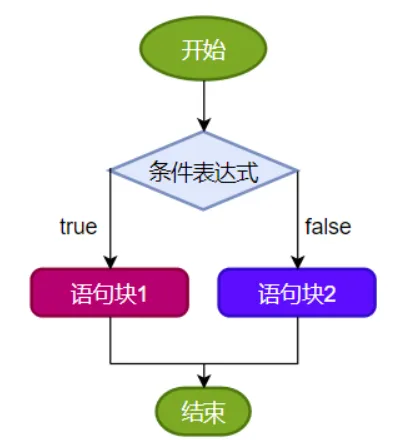
格式:
if(条件表达式) {
     语句块1;
 }else {
     语句块2;
}执行流程:
-
首先判断条件表达式看其结果是true还是false
-
如果是true就执行语句块1
-
如果是false就执行语句块2
多分支条件
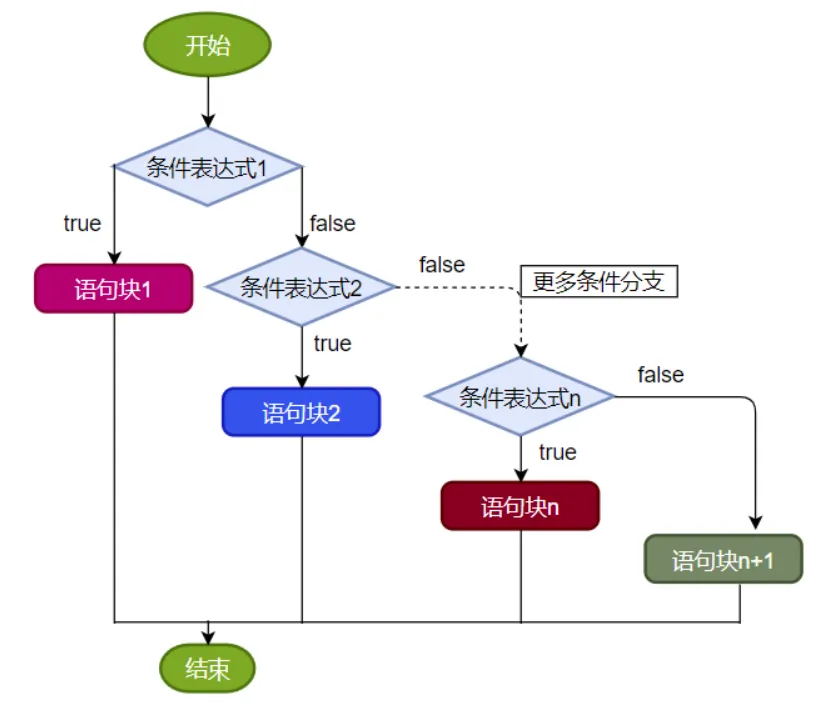
格式:
if (条件表达式1) {
     语句块1;
 } else if (条件表达式2) {
     语句块2;
 }
 ...
 }else if (条件表达式n) {
     语句块n;
 } else {
     语句块n+1;
}说明:一旦条件表达式为true,则进入执行相应的语句块。执行完对应的语句块之后,就跳出当前结构。
执行流程:
-
首先判断关系表达式1看其结果是true还是false
-
如果是true就执行语句块1,然后结束当前多分支
-
如果是false就继续判断关系表达式2看其结果是true还是false
-
如果是true就执行语句块2,然后结束当前多分支
-
如果是false就继续判断关系表达式…看其结果是true还是false
…
n. 如果没有任何关系表达式为true,就执行语句块n+1,然后结束当前多分支
switch-case选择结构
语法格式:
switch(表达式){
     case 常量值1:
         语句块1;
         //break;
     case 常量值2:
         语句块2;
         //break;
     // ...
    [default:
         语句块n+1;
         break;
    ]
}执行流程图:
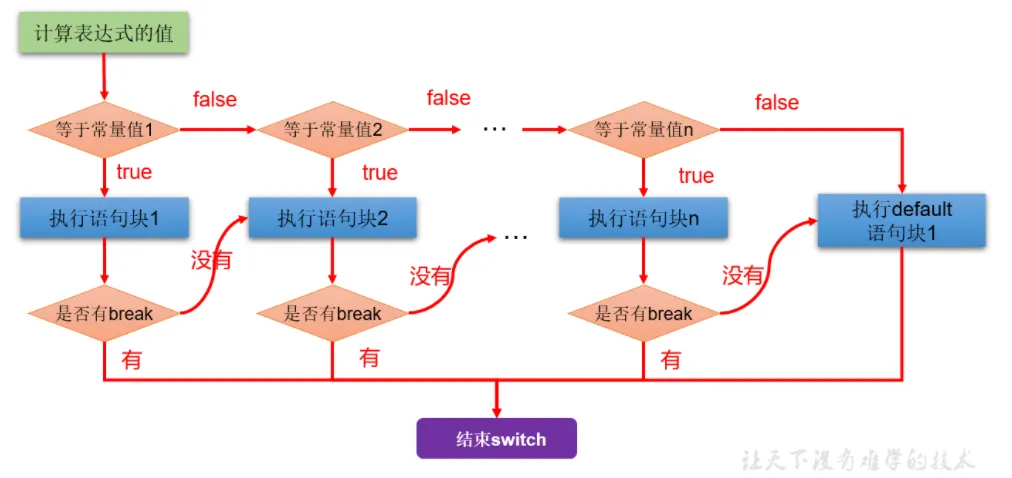
执行过程:
第1步:根据switch中表达式的值,依次匹配各个case。如果表达式的值等于某个case中的常量值,则执行对应case中的执行语句。
第2步:执行完此case的执行语句以后,
情况1:如果遇到break,则执行break并跳出当前的switch-case结构
情况2:如果没有遇到break,则会继续执行当前case之后的其它case中的执行语句。
--->case穿透
...
直到遇到break关键字或执行完所有的case及default的执行语句,跳出当前的switch-case结构
使用注意点:
-
switch(表达式)中表达式的值必须是下述几种类型之一:byte,short,char,int,枚举 (jdk 5.0),String (jdk 7.0);
-
case子句中的值必须是常量,不能是变量名或不确定的表达式值或范围;
-
同一个switch语句,所有case子句中的常量值互不相同;
-
break语句用来在执行完一个case分支后使程序跳出switch语句块;如果没有break,程序会顺序执行到switch结尾;
-
default子句是可选的。同时,位置也是灵活的。当没有匹配的case时,执行default语句。
注意:在switch语句中,如果case的后面不写break,将出现穿透现象,也就是一旦匹配成功,不会在判断下一个case的值,直接向后运行,直到遇到break或者整个switch语句结束,执行终止
循环语句
for 循环
语法格式:
for (①初始化部分; ②循环条件部分; ④迭代部分){
             ③循环体部分;
}**执行过程:**①-②-③-④-②-③-④-②-③-④-.....-②
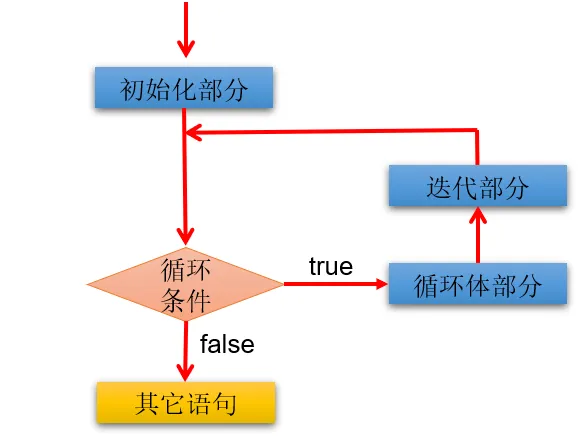
说明:
-
for(;;)中的两个;不能多也不能少
-
①初始化部分可以声明多个变量,但必须是同一个类型,用逗号分隔
-
②循环条件部分为boolean类型表达式,当值为false时,退出循环
-
④可以有多个变量更新,用逗号分隔
while 循环
语法格式:
①初始化部分
 while(②循环条件部分){
     ③循环体部分;
     ④迭代部分;
}**执行过程:**①-②-③-④-②-③-④-②-③-④-...-②
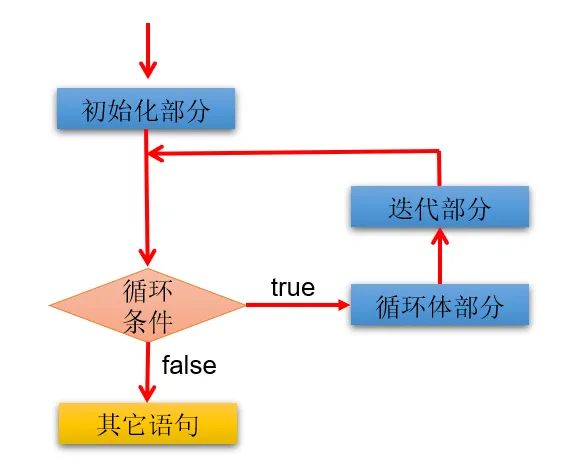
说明:
-
while(循环条件)中循环条件必须是boolean类型
-
注意不要忘记声明④迭代部分。否则,循环将不能结束,变成死循环
-
for循环和while循环可以相互转换。二者没有性能上的差别。实际开发中,根据具体结构的情况,选择哪个格式更合适、美观
-
for循环与while循环的区别:初始化条件部分的作用域不同
do-while 循环
语法格式:
①初始化部分;
 do{
     ③循环体部分
     ④迭代部分
}while(②循环条件部分);**执行过程:**①-③-④-②-③-④-②-③-④-...-②
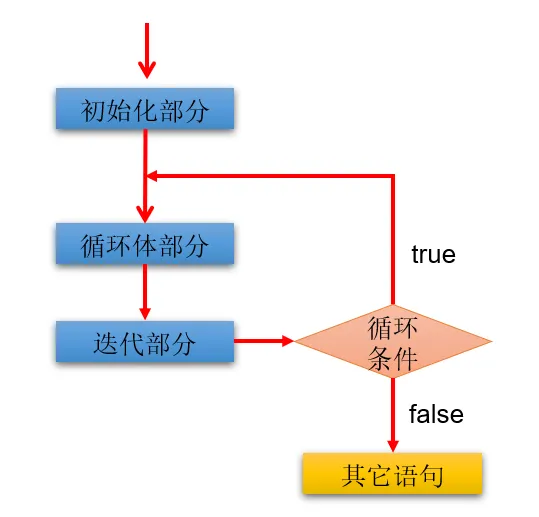
说明:
-
结尾while(循环条件)中循环条件必须是boolean类型
-
do{}while();最后有一个分号
-
do-while结构的循环体语句是至少会执行一次,这个和for和while是不一样的
-
循环的三个结构for、while、do-while三者是可以相互转换的。
无限循环
语法格式:
最简单"无限"循环格式:while(true) , for(;;)
适用场景:
-
开发中,有时并不确定需要循环多少次,需要根据循环体内部某些条件,来控制循环的结束(使用break)
-
如果此循环结构不能终止,则构成了死循环!开发中要避免出现死循环。
数组
概述
概念:
-
数组(Array),是多个相同类型数据按一定顺序排列的集合,并使用一个名字命名,并通过编号的方式对这些数据进行统一管理
-
数组中的概念
-
数组名
-
下标(或索引)
-
元素
-
数组的长度
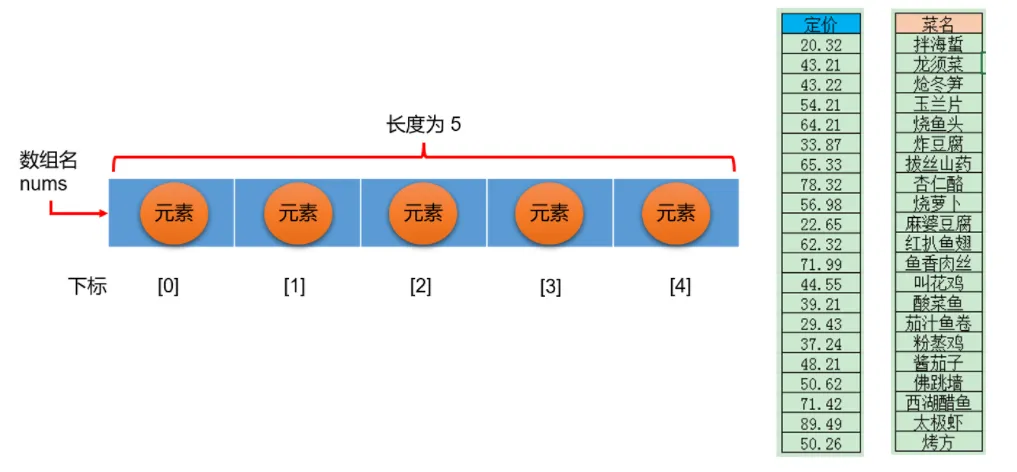
数组的特点:
-
数组本身是引用数据类型,而数组中的元素可以是任何数据类型,包括基本数据类型和引用数据类型
-
创建数组对象会在内存中开辟一整块连续的空间。占据的空间的大小,取决于数组的长度和数组中元素的类型
-
数组中的元素在内存中是依次紧密排列的,有序的
-
数组,一旦初始化完成,其长度就是确定的。数组的长度一旦确定,就不能修改
-
我们可以直接通过下标(或索引)的方式调用指定位置的元素,速度很快
-
数组名中引用的是这块连续空间的首地址
分类:
1、按照元素类型分:
-
基本数据类型元素的数组:每个元素位置存储基本数据类型的值
-
引用数据类型元素的数组:每个元素位置存储对象(本质是存储对象的首地址)(在面向对象部分讲解)
2、按照维度分:
-
一维数组:存储一组数据
-
二维数组:存储多组数据,相当于二维表,一行代表一组数据,只是这里的二维表每一行长度不要求一样
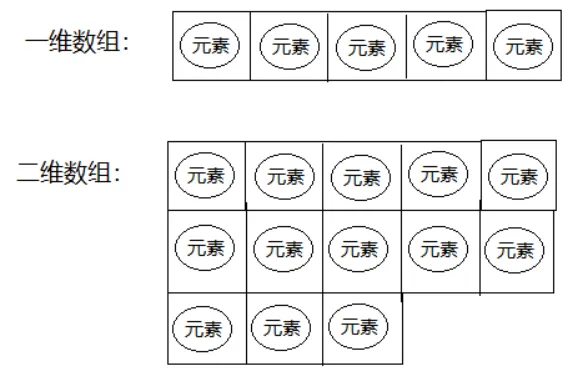
一维数组
声明:
//推荐
 元素的数据类型[] 一维数组的名称;

 //不推荐
元素的数据类型 一维数组名[];例如:
int[] arr;
int arr1[];
double[] arr2;
String[] arr3; //引用类型变量数组数组的声明,需要明确:
(1)数组的维度:在 Java 中数组的符号是[],[]表示一维,[][]表示二维
(2)数组的元素类型:即创建的数组容器可以存储什么数据类型的数据。元素的类型可以是任意的 Java 的数据类型。例如:int、String、Student等
(3)数组名:就是代表某个数组的标识符,数组名其实也是变量名,按照变量的命名规范来命名。数组名是个引用数据类型的变量,因为它代表一组数据
初始化
静态初始化
如果数组变量的初始化和数组元素的赋值操作同时进行,那就称为静态初始化
静态初始化,本质是用静态数据(编译时已知)为数组初始化。此时数组的长度由静态数据的个数决定
一维数组声明和静态初始化格式1:
数据类型[] 数组名 = new 数据类型[]{元素1,元素2,元素3,...};

或

数据类型[] 数组名;
数组名 = new 数据类型[]{元素1,元素2,元素3,...};new:关键字,创建数组使用的关键字。因为数组本身是引用数据类型,所以要用new创建数组实体
例如:
int[] arr = new int[]{1,2,3,4,5};//正确
//或
int[] arr;
arr = new int[]{1,2,3,4,5};//正确一维数组声明和静态初始化格式2:
数据类型[] 数组名 = {元素1,元素2,元素3...};//必须在一个语句中完成,不能分成两个语句写
例如,定义存储1,2,3,4,5整数的数组容器
int[] arr = {1,2,3,4,5};//正确

int[] arr;
arr = {1,2,3,4,5};//错误例子:
public class ArrayTest2 {
     public static void main(String[] args) {
         int[] arr = {1,2,3,4,5};//右边不需要写new int[]

         int[] nums;
         nums = new int[]{10,20,30,40}; //声明和初始化在两个语句完成,就不能使用new int[]

         char[] word = {'h','e','l','l','o'};

         String[] heros = {"袁隆平","邓稼先","钱学森"};

         System.out.println("arr数组:" + arr);//arr数组:[I@1b6d3586
         System.out.println("nums数组:" + nums);//nums数组:[I@4554617c
         System.out.println("word数组:" + word);//word数组:[C@74a14482
         System.out.println("heros数组:" + heros);//heros数组:[Ljava.lang.String;@1540e19d
     }
}动态初始化
数组变量的初始化和数组元素的赋值操作分开进行,即为动态初始化
动态初始化中,只确定了元素的个数(即数组的长度),而元素值此时只是默认值,还并未真正赋自己期望的值。真正期望的数据需要后续单独一个一个赋值
格式:
数组存储的元素的数据类型[] 数组名字 = new 数组存储的元素的数据类型[长度];

或

数组存储的数据类型[] 数组名字;
数组名字 = new 数组存储的数据类型[长度];-
[长度]:数组的长度,表示数组容器中可以最多存储多少个元素
-
**注意:数组有定长特性,长度一旦指定,不可更改。**和水杯道理相同,买了一个2升的水杯,总容量就是2升是固定的
举例1:正确写法
int[] arr = new int[5];

int[] arr;
arr = new int[5];使用
-
数组的元素总个数,即数组的长度
-
每个数组都有一个属性 length 指明它的长度,例如:
arr.length指明数组 arr 的长度(即元素个数) -
每个数组都具有长度,而且一旦初始化,其长度就是确定,且是不可变的
如何表示数组中的一个元素?
每一个存储到数组的元素,都会自动的拥有一个编号,从0开始,这个自动编号称为数组索引(index)或下标,可以通过数组的索引/下标访问到数组中的元素
数组名[索引/下标]
数组的下标范围?
Java 中数组的下标从[0]开始,下标范围是[0, 数组的长度-1],即[0, 数组名.length-1]
默认值
数组是引用类型,当我们使用动态初始化方式创建数组时,元素值只是默认值。例如:
public class ArrayTest6 {
    public static void main(String argv[]){
        int a[]= new int[5];
        System.out.println(a[3]); //a[3]的默认值为0
    }
}对于基本数据类型而言,默认初始化值各有不同
对于引用数据类型而言,默认初始化值为 null(注意与0不同!)
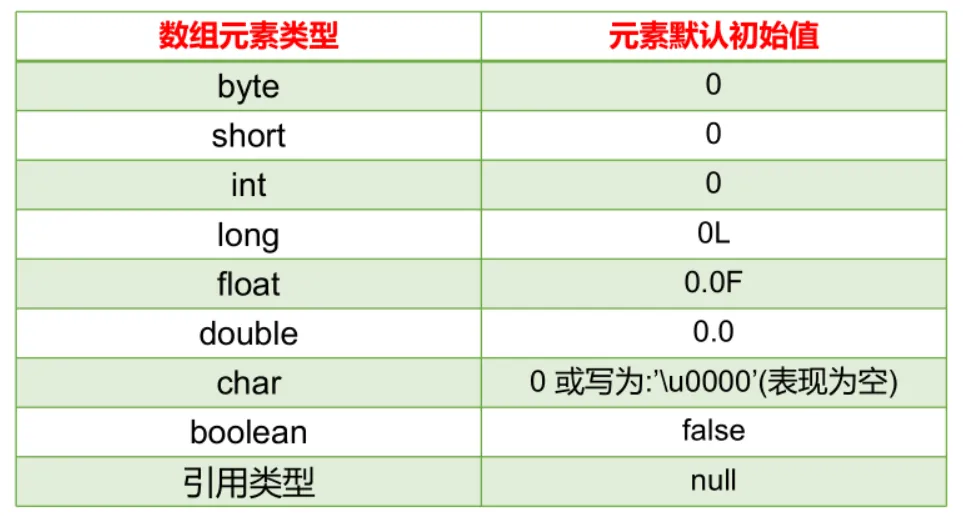
一维数组内存分析
Java 虚拟机的内存划分:
为了提高运算效率,就对空间进行了不同区域的划分,因为每一片区域都有特定的处理数据方式和内存管理方式
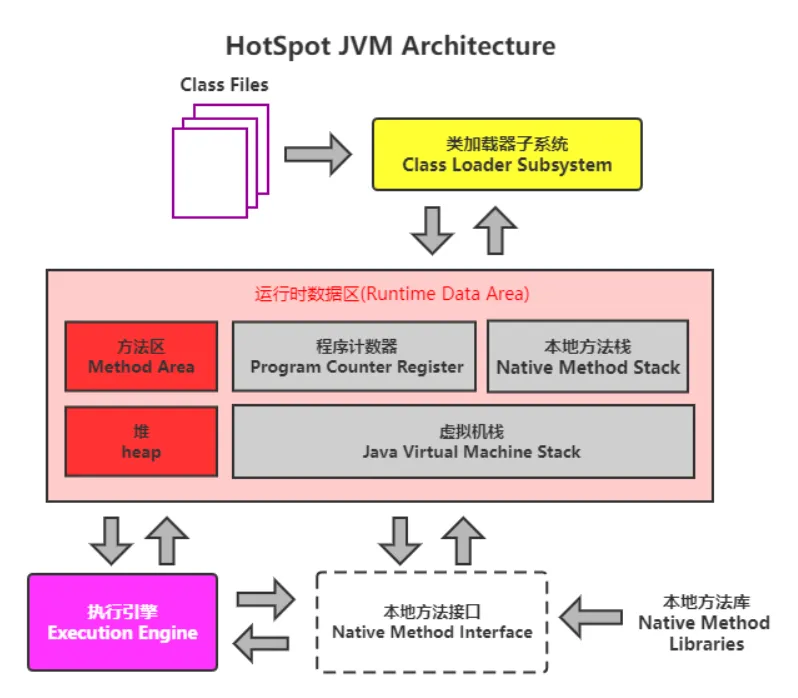
| 区域名称 | 作用 |
|---|---|
| 虚拟机栈 | 用于存储正在执行的每个Java方法的局部变量表等。局部变量表存放了编译期可知长度的各种基本数据类型、对象引用,方法执行完,自动释放。 |
| 堆内存 | 存储对象(包括数组对象),new来创建的,都存储在堆内存。 |
| 方法区 | 存储已被虚拟机加载的类信息、常量、(静态变量)、即时编译器编译后的代码等数据。 |
| 本地方法栈 | 当程序中调用了native的本地方法时,本地方法执行期间的内存区域 |
| 程序计数器 | 程序计数器是CPU中的寄存器,它包含每一个线程下一条要执行的指令的地址 |
一维数组在内存中的存储
一个一维数组内存图
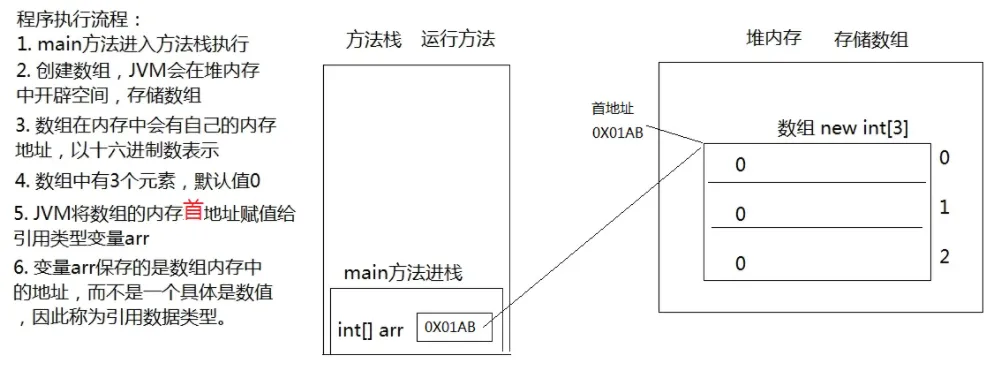
数组下标为什么是从 0 开始的?因为第一个元素距离数组首地址间隔0个单元格
两个一维数组内存图
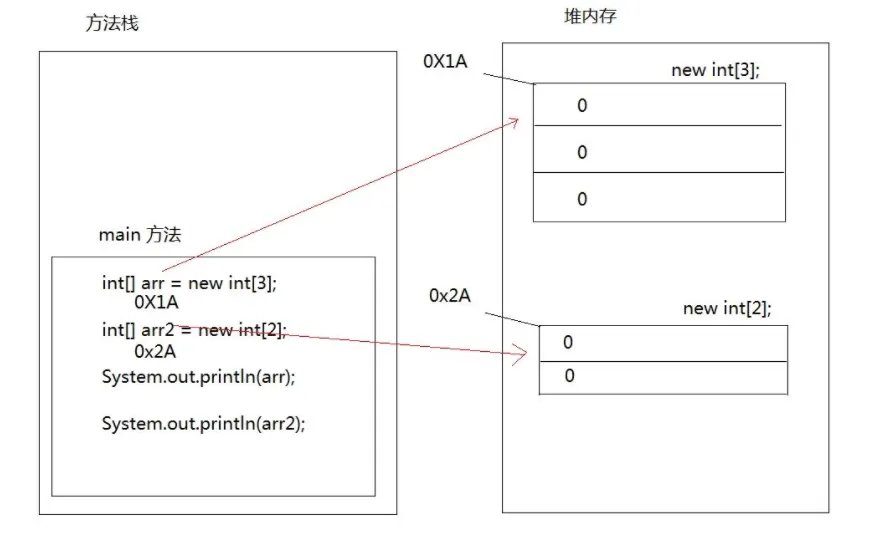
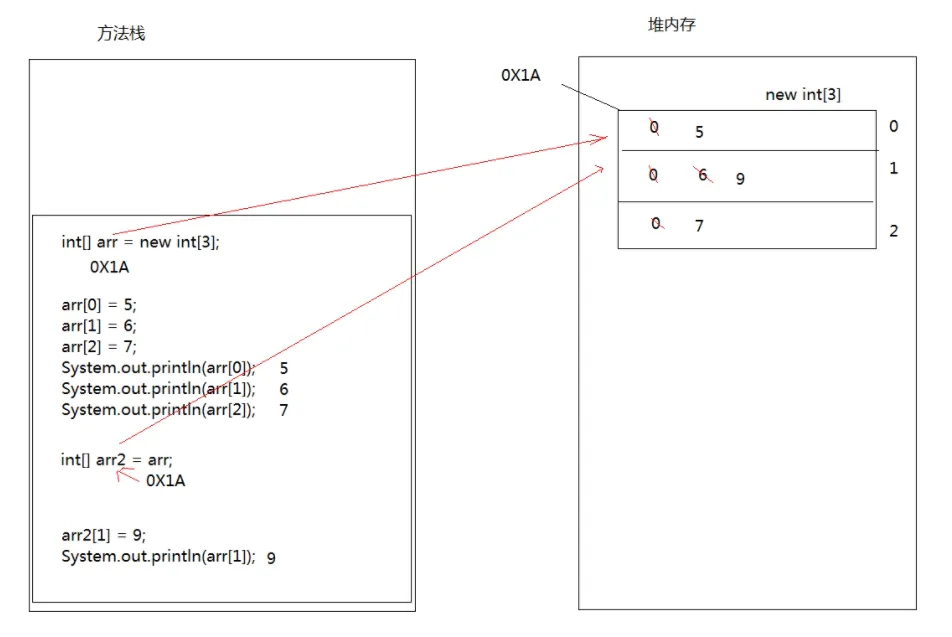
如果两个变量指向同一个一维数组?
两个数组变量本质上代表同一个数组
public static void main(String[] args) {
    // 定义数组,存储3个元素
    int[] arr = new int[3];
    //数组索引进行赋值
    arr[0] = 5;
    arr[1] = 6;
    arr[2] = 7;
    //输出3个索引上的元素值
    System.out.println(arr[0]);
    System.out.println(arr[1]);
    System.out.println(arr[2]);
    //定义数组变量arr2,将arr的地址赋值给arr2
    int[] arr2 = arr;
    arr2[1] = 9;
    System.out.println(arr[1]);
}
多维数组
Java 语言里提供了支持多维数组的语法
二维数组声明的语法格式:
//推荐
 元素的数据类型[][] 二维数组的名称;

//不推荐
元素的数据类型  二维数组名[][];
//不推荐
元素的数据类型[] 二维数组名[];例如:
public class Test20TwoDimensionalArrayDefine {
    public static void main(String[] args) {
        //存储多组成绩
        int[][] grades;

        //存储多组姓名
        String[][] names;
    }
}初始化
静态初始化
格式:
int[][] arr = new int[][]{{3,8,2},{2,7},{9,0,1,6}};
定义一个名称为 arr 的二维数组,二维数组中有三个一维数组
-
每一个一维数组中具体元素也都已初始化
-
第一个一维数组
arr[0] = {3,8,2}; -
第二个一维数组
arr[1] = {2,7}; -
第三个一维数组
arr[2] = {9,0,1,6}; -
第三个一维数组的长度表示方式:
arr[2].length;
注意特殊写法情况:
int[] x,y[];x是一维数组,y是二维数组
动态初始化
如果二维数组的每一个数据,甚至是每一行的列数,需要后期单独确定,那么就只能使用动态初始化方式了。动态初始化方式分为两种格式:
格式1:规则二维表:每一行的列数是相同的
//(1)确定行数和列数
元素的数据类型[][] 二维数组名 = new 元素的数据类型[m][n];
 //其中,m:表示这个二维数组有多少个一维数组。或者说一共二维表有几行
 //其中,n:表示每一个一维数组的元素有多少个。或者说每一行共有一个单元格

//此时创建完数组,行数、列数确定,而且元素也都有默认值

//(2)再为元素赋新值
二维数组名[行下标][列下标] = 值;举例:
int[][] arr = new int[3][2];
-
定义了名称为 arr 的二维数组
-
二维数组中有3个一维数组
-
每一个一维数组中有2个元素
-
一维数组的名称分别为
arr[0], arr[1], arr[2] -
给第一个一维数组1脚标位赋值为78写法是:
arr[0][1] = 78;
格式2:不规则:每一行的列数不一样
//(1)先确定总行数
 元素的数据类型[][] 二维数组名 = new 元素的数据类型[总行数][];

 //此时只是确定了总行数,每一行里面现在是null

 //(2)再确定每一行的列数,创建每一行的一维数组
 二维数组名[行下标] = new 元素的数据类型[该行的总列数];

 //此时已经new完的行的元素就有默认值了,没有new的行还是null

 //(3)再为元素赋值
二维数组名[行下标][列下标] = 值;举例:
int[][] arr = new int[3][];
-
二维数组中有3个一维数组
-
每个一维数组都是默认初始化值 null (注意:区别于格式1)
-
可以对这个三个一维数组分别进行初始化:
arr[0] = new int[3]; arr[1] = new int[1]; arr[2] = new int[2]; -
注:
int[][]arr = new int[][3]; //非法
数组长度与角标:
-
二维数组的长度/行数:
二维数组名.length -
二维数组的某一行:
二维数组名[行下标],此时相当于获取其中一组数据。它本质上是一个一维数组。行下标的范围:[0, 二维数组名.length-1]。此时把二维数组看成一维数组的话,元素是行对象 -
某一行的列数:
二维数组名[行下标].length,因为二维数组的每一行是一个一维数组 -
某一个元素:
二维数组名[行下标][列下标],即先确定行/组,再确定列
二维数组的遍历:
for(int i=0; i<二维数组名.length; i++){ //二维数组对象.length
    for(int j=0; j<二维数组名[i].length; j++){//二维数组行对象.length
        System.out.print(二维数组名[i][j]);
    }
    System.out.println();
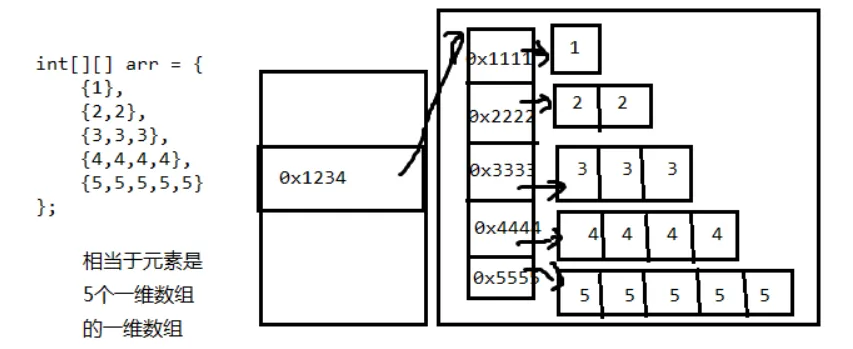
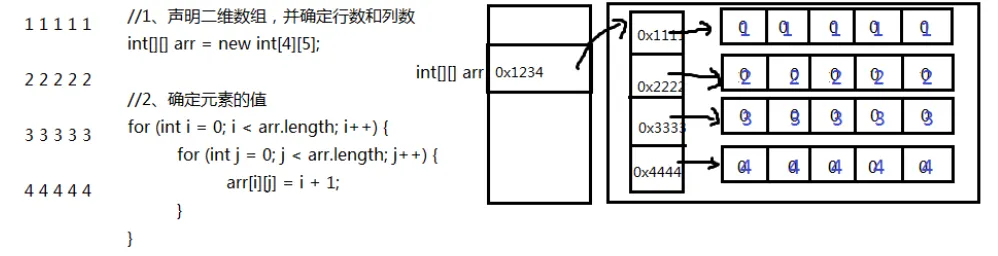
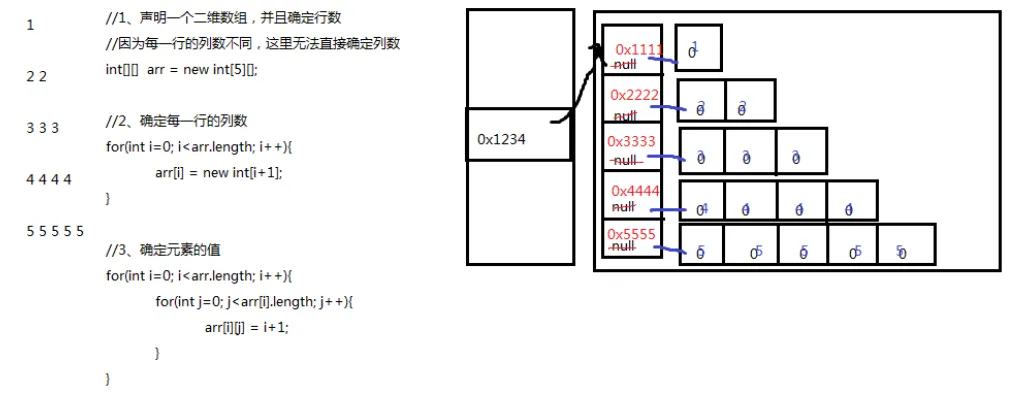
}内存解析:
二维数组本质上是元素类型是一维数组的一维数组
int[][] arr = {
    {1},
    {2,2},
    {3,3,3},
    {4,4,4,4},
    {5,5,5,5,5}
};
//1、声明二维数组,并确定行数和列数
int[][] arr = new int[4][5];

//2、确定元素的值
for (int i = 0; i < arr.length; i++) {
    for (int j = 0; j < arr.length; j++) {
        arr[i][j] = i + 1;
    }
}
//1、声明一个二维数组,并且确定行数
//因为每一行的列数不同,这里无法直接确定列数
int[][]  arr = new int[5][];

//2、确定每一行的列数
for(int i=0; i<arr.length; i++){
    /*
                        arr[0] 的列数是1
                        arr[1] 的列数是2
                        arr[2] 的列数是3
                        arr[3] 的列数是4
                        arr[4] 的列数是5
                        */
    arr[i] = new int[i+1];
}

//3、确定元素的值
for(int i=0; i<arr.length; i++){
    for(int j=0; j<arr[i].length; j++){
        arr[i][j] = i+1;
    }
}
数组常见算法
数组元素的反转
实现思路:数组对称位置的元素互换
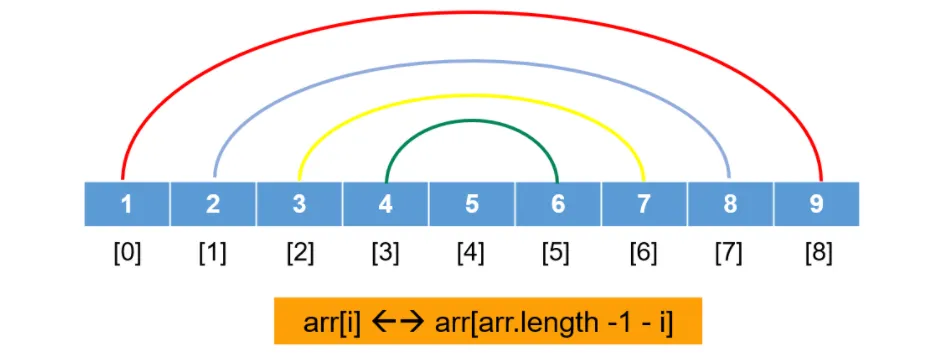
public class TestArrayReverse1 {
    public static void main(String[] args) {
        int[] arr = {1,2,3,4,5};
        System.out.println("反转之前:");
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }

        //反转
         /*
        思路:首尾对应位置的元素交换
        (1)确定交换几次
           次数 = 数组.length / 2
        (2)谁和谁交换
        for(int i=0; i<次数; i++){
             int temp = arr[i];
             arr[i] = arr[arr.length-1-i];
             arr[arr.length-1-i] = temp;
        }
         */
        for(int i=0; i<arr.length/2; i++){
            int temp = arr[i];
            arr[i] = arr[arr.length-1-i];
            arr[arr.length-1-i] = temp;
        }

        System.out.println("反转之后:");
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }
    }

}数组的扩容与缩容
题目:现有数组 int[] arr = new int[]{1,2,3,4,5};,现将数组长度扩容1倍,并将10,20,30三个数据添加到arr数组中,如何操作?
public class ArrTest1 {
    public static void main(String[] args) {

        int[] arr = new int[]{1,2,3,4,5};
        int[] newArr = new int[arr.length << 1];

        for(int i = 0;i < arr.length;i++){
            newArr[i] = arr[i];
        }

        newArr[arr.length] = 10;
        newArr[arr.length + 1] = 20;
        newArr[arr.length + 2] = 30;

        arr = newArr;

        //遍历arr
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }
    }
}题目:现有数组 int[] arr={1,2,3,4,5,6,7}。现需删除数组中索引为4的元素
public class ArrTest2 {
    public static void main(String[] args) {

        int[] arr = {1, 2, 3, 4, 5, 6, 7};
        //删除数组中索引为4的元素
        int delIndex = 4;
        //方案1:
        /*//创建新数组
        int[] newArr = new int[arr.length - 1];

        for (int i = 0; i < delIndex; i++) {
            newArr[i] = arr[i];
        }
        for (int i = delIndex + 1; i < arr.length; i++) {
            newArr[i - 1] = arr[i];
        }

        arr = newArr;
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }*/

        //方案2:
        for (int i = delIndex; i < arr.length - 1; i++) {
            arr[i] = arr[i + 1];
        }
        arr[arr.length - 1] = 0;

        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }
    }
}数组元素的查找
顺序查找
public class TestArrayOrderSearch {
    //查找value第一次在数组中出现的index
    public static void main(String[] args){
        int[] arr = {4,5,6,1,9};
        int value = 1;
        int index = -1;

        for(int i=0; i<arr.length; i++){
            if(arr[i] == value){
                index = i;
                break;
            }
        }

        if(index==-1){
            System.out.println(value + "不存在");
        }else{
            System.out.println(value + "的下标是" + index);
        }
    }
}二分查找
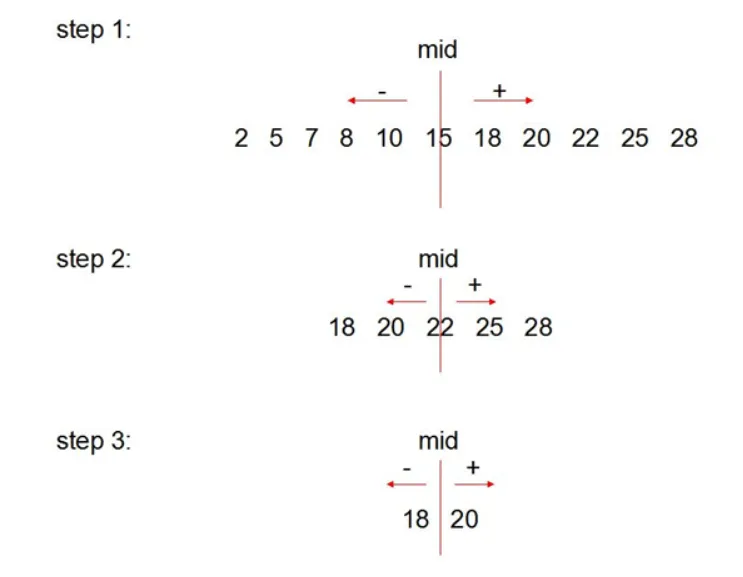
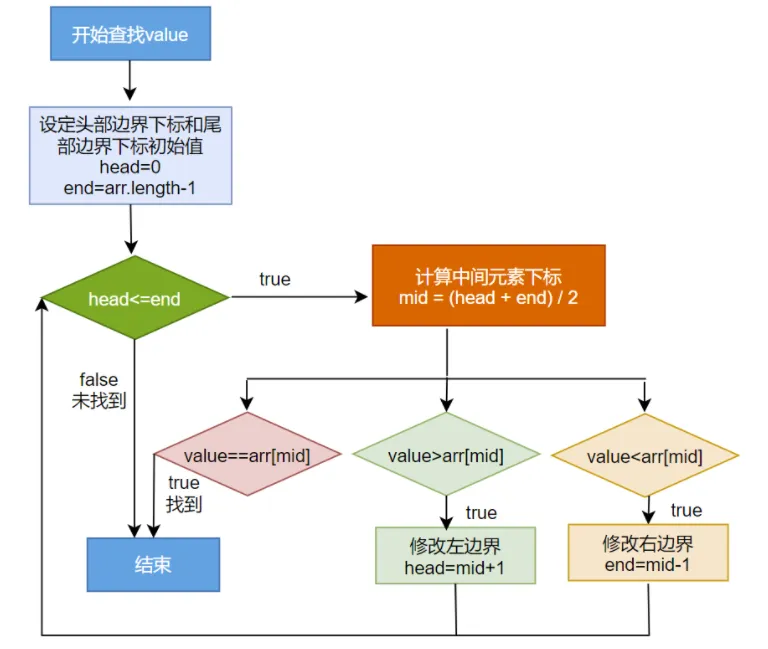
//二分法查找:要求此数组必须是有序的。
int[] arr3 = new int[]{-99,-54,-2,0,2,33,43,256,999};
boolean isFlag = true;
int value = 256;
//int value = 25;
int head = 0;//首索引位置
int end = arr3.length - 1;//尾索引位置
while(head <= end){
    int middle = (head + end) / 2;
    if(arr3[middle] == value){
        System.out.println("找到指定的元素,索引为:" + middle);
        isFlag = false;
        break;
    }else if(arr3[middle] > value){
        end = middle - 1;
    }else{//arr3[middle] < value
        head = middle + 1;
    }
}

if(isFlag){
    System.out.println("未找打指定的元素");
}数组元素排序
冒泡排序
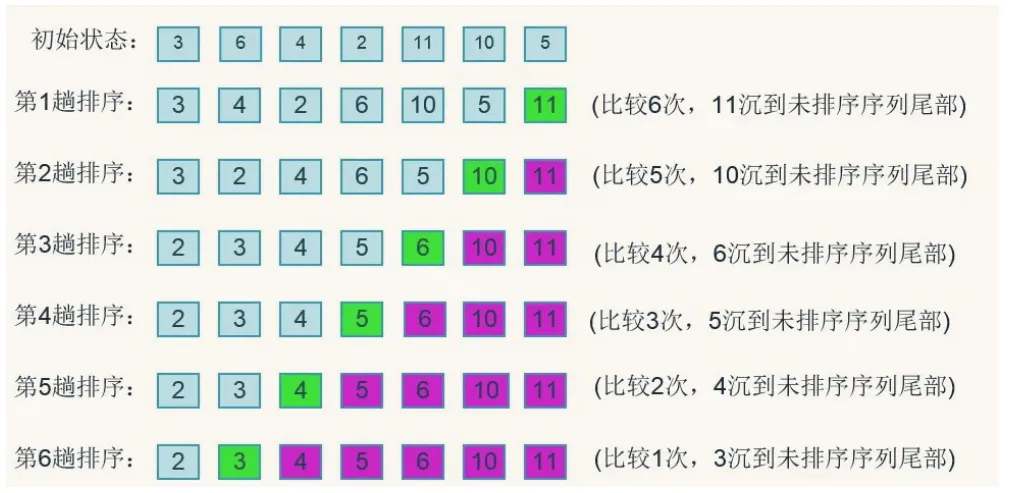
排序思想:
-
比较相邻的元素。如果第一个比第二个大(升序),就交换他们两个
-
对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对。这步做完后,最后的元素会是最大的数
-
针对所有的元素重复以上的步骤,除了最后一个
-
持续每次对越来越少的元素重复上面的步骤,直到没有任何一对数字需要比较为止
/*
1、冒泡排序(最经典)
思想:每一次比较“相邻(位置相邻)”元素,如果它们不符合目标顺序(例如:从小到大),
     就交换它们,经过多轮比较,最终实现排序。
         (例如:从小到大)         每一轮可以把最大的沉底,或最小的冒顶。

过程:arr{6,9,2,9,1}  目标:从小到大

第一轮:
        第1次,arr[0]与arr[1],6>9不成立,满足目标要求,不交换
        第2次,arr[1]与arr[2],9>2成立,不满足目标要求,交换arr[1]与arr[2] {6,2,9,9,1}
        第3次,arr[2]与arr[3],9>9不成立,满足目标要求,不交换
        第4次,arr[3]与arr[4],9>1成立,不满足目标要求,交换arr[3]与arr[4] {6,2,9,1,9}
        第一轮所有元素{6,9,2,9,1}已经都参与了比较,结束。
        第一轮的结果:第“一”最大值9沉底(本次是后面的9沉底),即到{6,2,9,1,9}元素的最右边

第二轮:
        第1次,arr[0]与arr[1],6>2成立,不满足目标要求,交换arr[0]与arr[1] {2,6,9,1,9}
        第2次,arr[1]与arr[2],6>9不成立,满足目标要求,不交换
        第3次:arr[2]与arr[3],9>1成立,不满足目标要求,交换arr[2]与arr[3] {2,6,1,9,9}
        第二轮未排序的所有元素 {6,2,9,1}已经都参与了比较,结束。
        第二轮的结果:第“二”最大值9沉底(本次是前面的9沉底),即到{2,6,1,9}元素的最右边
第三轮:
        第1次,arr[0]与arr[1],2>6不成立,满足目标要求,不交换
        第2次,arr[1]与arr[2],6>1成立,不满足目标要求,交换arr[1]与arr[2] {2,1,6,9,9}
        第三轮未排序的所有元素{2,6,1}已经都参与了比较,结束。
        第三轮的结果:第三最大值6沉底,即到 {2,1,6}元素的最右边
第四轮:
        第1次,arr[0]与arr[1],2>1成立,不满足目标要求,交换arr[0]与arr[1] {1,2,6,9,9}
        第四轮未排序的所有元素{2,1}已经都参与了比较,结束。
        第四轮的结果:第四最大值2沉底,即到{1,2}元素的最右边

*/
public class Test19BubbleSort{
    public static void main(String[] args){
        int[] arr = {6,9,2,9,1};

        //目标:从小到大
        //冒泡排序的轮数 = 元素的总个数 - 1
        //轮数是多轮,每一轮比较的次数是多次,需要用到双重循环,即循环嵌套
        //外循环控制 轮数,内循环控制每一轮的比较次数和过程
        for(int i=1; i<arr.length; i++){ //循环次数是arr.length-1次/轮
                        /*
                        假设arr.length=5
                        i=1,第1轮,比较4次
                                arr[0]与arr[1]
                                arr[1]与arr[2]
                                arr[2]与arr[3]
                                arr[3]与arr[4]

                                arr[j]与arr[j+1],int j=0;j<4; j++

                        i=2,第2轮,比较3次
                                arr[0]与arr[1]
                                arr[1]与arr[2]
                                arr[2]与arr[3]

                                arr[j]与arr[j+1],int j=0;j<3; j++

                        i=3,第3轮,比较2次
                                arr[0]与arr[1]
                                arr[1]与arr[2]

                                arr[j]与arr[j+1],int j=0;j<2; j++
                        i=4,第4轮,比较1次
                                arr[0]与arr[1]

                                arr[j]与arr[j+1],int j=0;j<1; j++

                                int j=0; j<arr.length-i; j++
                        */
            for(int j=0; j<arr.length-i; j++){
                //希望的是arr[j] < arr[j+1]
                if(arr[j] > arr[j+1]){
                    //交换arr[j]与arr[j+1]
                    int temp = arr[j];
                    arr[j] = arr[j+1];
                    arr[j+1] = temp;
                }
            }
        }

        //完成排序,遍历结果
        for(int i=0; i<arr.length; i++){
            System.out.print(arr[i]+"  ");
        }
    }
}快速排序
快速排序(Quick Sort)由图灵奖获得者Tony Hoare发明,被列为20世纪十大算法之一,是迄今为止所有内排序算法中速度最快的一种,快速排序的时间复杂度为O(nlog(n))
快速排序通常明显比同为O(nlogn)的其他算法更快,因此常被采用,而且快排采用了分治法的思想,所以在很多笔试面试中能经常看到快排的影子
排序思想:
-
从数列中挑出一个元素,称为"基准"(pivot)
-
重新排序数列,所有元素比基准值小的摆放在基准前面,所有元素比基准值大的摆在基准的后面(相同的数可以到任一边)。在这个分区结束之后,该基准就处于数列的中间位置。这个称为分区(partition)操作
-
递归地(recursive)把小于基准值元素的子数列和大于基准值元素的子数列排序
-
递归的最底部情形,是数列的大小是零或一,也就是永远都已经被排序好了。虽然一直递归下去,但是这个算法总会结束,因为在每次的迭代(iteration)中,它至少会把一个元素摆到它最后的位置去
Arrays工具类的使用
java.util.Arrays 类即为操作数组的工具类,包含了用来操作数组(比如排序和搜索)的各种方法。 比如:
-
数组元素拼接
-
static String toString(int[] a):字符串表示形式由数组的元素列表组成,括在方括号("[]")中。相邻元素用字符 ", "(逗号加空格)分隔。形式为:[元素1,元素2,元素3...] -
static String toString(Object[] a):字符串表示形式由数组的元素列表组成,括在方括号("[]")中。相邻元素用字符 ", "(逗号加空格)分隔。元素将自动调用自己从 Object 继承的 toString 方法将对象转为字符串进行拼接,如果没有重写,则返回类型@hash值,如果重写则按重写返回的字符串进行拼接。 -
数组排序
-
static void sort(int[] a):将a数组按照从小到大进行排序 -
static void sort(int[] a, int fromIndex, int toIndex):将a数组的[fromIndex, toIndex)部分按照升序排列 -
static void sort(Object[] a):根据元素的自然顺序对指定对象数组按升序进行排序。 -
static <T> void sort(T[] a, Comparator<? super T> c):根据指定比较器产生的顺序对指定对象数组进行排序。 -
数组元素的二分查找
-
static int binarySearch(int[] a, int key)、static int binarySearch(Object[] a, Object key):要求数组有序,在数组中查找 key 是否存在,如果存在返回第一次找到的下标,不存在返回负数。 -
数组的复制
-
static int[] copyOf(int[] original, int newLength):根据 original 原数组复制一个长度为 newLength 的新数组,并返回新数组 -
static <T> T[] copyOf(T[] original,int newLength):根据 original 原数组复制一个长度为 newLength 的新数组,并返回新数组 -
static int[] copyOfRange(int[] original, int from, int to):复制 original 原数组的[from,to)构成新数组,并返回新数组 -
static <T> T[] copyOfRange(T[] original,int from,int to):复制 original 原数组的[from,to)构成新数组,并返回新数组 -
比较两个数组是否相等
-
static boolean equals(int[] a, int[] a2):比较两个数组的长度、元素是否完全相同 -
static boolean equals(Object[] a,Object[] a2):比较两个数组的长度、元素是否完全相同 -
填充数组
-
static void fill(int[] a, int val):用 val 值填充整个 a 数组 -
static void fill(Object[] a,Object val):用 val 对象填充整个 a 数组 -
static void fill(int[] a, int fromIndex, int toIndex, int val):将 a 数组[fromIndex,toIndex)部分填充为val值 -
static void fill(Object[] a, int fromIndex, int toIndex, Object val):将 a 数组[fromIndex,toIndex)部分填充为val对象
举例:java.util.Arrays类的sort()方法提供了数组元素排序功能:
import java.util.Arrays;
public class SortTest {
    public static void main(String[] args) {
        int[] arr = {3, 2, 5, 1, 6};
        System.out.println("排序前" + Arrays.toString(arr));
        Arrays.sort(arr);
        System.out.println("排序后" + Arrays.toString(arr));
    }
}面向对象
面向对象和面向过程
什么是面向过程?
面向过程,其实就是面向着具体的每一个步骤和过程,把每一个步骤和过程完成,然后由这些功能方法相互调用,完成需求
什么是面向对象?
面向对象思想就是不断的创建对象,使用对象,指挥对象做事情。(如果有对象,直接用对象,对我们直接提供服务)
类
类和对象
类:是一组相关的属性和行为的集合(我们班所有的同学都具备相同的属性和行为,比如:姓名,年龄,学习,这样就把所有的学生成为学生类)
对象:是该类事物的具体体现(说某个同学时,他都具备自己特有的属性和行为)
类:学生 对象:具体的张三李四就是对象
类:车 对象:具体的开的奔驰、宝马,就是对象
类的定义
定义学生类:
定义成员变量和成员方法,其中成员变量和普通变量的区别是,成员变量是定义类的特征,在类内定义,成员变量是有默认值的(整型: 0, 浮点型: 0.0 ,布尔型: false,字符型: '\0' '\u000', 引用数据类型: null)
public class Student {

  //特征:表现为属性,属性有默认值,整型: 0,浮点型: 0.0,布尔型: false
  //字符型: '\0'  '\u000',引用数据类型: null
        //成员变量
        //姓名
        String name;
        //年龄
        int age;


        //行为:表现出的是方法
        //成员方法
        public void study() {
                System.out.println("好好学习,天天向上");
        }

        public void eat() {
                System.out.println("吃饱了才有力气减肥");
        }
}类的使用:
public class StudentTest {
        public static void main(String[] args) {
    //创建对象
                //类名  对象名  = new 类名();
                Student s = new Student();

                //使用成员变量
                System.out.println("姓名:"+s.name);//null
                System.out.println("年龄:"+s.age);//0
                System.out.println("----------");

                //给成员变量赋值
                s.name = "孙俪";
                s.age = 30;
                //再次使用成员变量
                System.out.println("姓名:"+s.name);//孙俪
                System.out.println("年龄:"+s.age);//30
                System.out.println("----------");

                //调用成员方法
                s.study();
                s.eat();
        }
}注意:
-
类名是一个标识符, 遵循大驼峰命名法
-
一个 Java 文件中可以写多个类, 但是只有和文件名相同的那个类名可以修饰为 public
-
在程序编译的时候, 每一个类都会生成一个
.class字节码文件, 而且.class文件的名字和类名相同 -
在程序中, 是先有类, 然后再从这个类中实例化一个对象
关键字
static:用关键字static修饰的成员, 叫做静态成员,没有用关键字static修饰的成员, 叫做非静态成员
静态成员:
静态成员是属于类的, 在访问的时候, 需要用类来访问
静态成员开辟空间, 是在这个类第一次被加载到内存中的时候开辟的
非静态成员:
非静态成员是属于对象的, 在访问的时候, 需要用对象来访问
非静态成员开辟空间, 是在这个对象被实例化的时候开辟的
注意:
-
静态方法中, 不能直接访问非静态成员
-
在非静态的方法中, 可以直接访问静态的成员
class Person {
    String name;
    static int a;

    void eat() {}
    static void sleep() {}
}
class Program {
    public static void main(String[] args) {
        Person xiaomin = new Person();
        // 访问非静态成员
        xiaomin.name = "xiaomin";
        xiaomin.eat();
        // 访问静态成员
        Person.a = 10;
        Person.sleep();
        // 注:
        // 访问静态的成员, 也可以使用对象来访问, 但是会有警告
        // 推荐使用类来访问静态成员
    }
}private:private 是一个权限修饰符,可以修饰成员(成员变量和成员方法),被 private 修饰的成员只在本类中才能访问
public class Student {
        private String name;
        private int age;

        public void setName(String n) {
                name = n;
        }

        public String getName() {
                return name;
        }

        public void setAge(int a) {
                age = a;
        }

        public int getAge() {
                return age;
        }
}

/*
 * 测试类
 */
public class StudentTest {
        public static void main(String[] args) {
                //创建对象
                Student s = new Student();
                System.out.println(s.getName()+"***"+s.getAge());

                //给成员变量赋值
                s.setName("杨幂");
                s.setAge(30);
                System.out.println(s.getName()+"***"+s.getAge());
        }
}this:代表所在类的对象引用,方法被哪个对象调用,this 就代表那个对象
使用场景:用于解决成员变量被隐藏的问题,也就是局部变量和成员变量重名
public class Student {
        private String name;
        private int age;

        public void setName(String name) {
                //name = name;
                this.name = name;
        }

        public String getName() {
                return name;
                //return this.name;
        }

        public void setAge(int age) {
                this.age = age;
        }

        public int getAge() {
                return age;
        }
}

public class StudentTest {
        public static void main(String[] args) {
                // 创建对象
                Student s = new Student();
                System.out.println(s.getName() + "---" + s.getAge());

                s.setName("孙俪");
                s.setAge(30);
                System.out.println(s.getName() + "---" + s.getAge());
        }
}构造方法
作用:创建一个类的对象,并给对象的数据进行初始化
格式:方法名与类名相同
没有返回值类型,连void都没有,没有具体的返回值
public class Student {
        public Student() {
                System.out.println("这是构造方法");
        }
}

public class StudentDemo {
        public static void main(String[] args) {
                //如何调用构造方法呢?
                //通过new关键字调用
                //格式:类名 对象名 = new 构造方法(...);
                Student s = new Student();
        }
}**注意:**如果不提供构造方法,系统会给出默认构造方法,如果提供了构造方法,系统将不再提供,构造方法也是可以重载的,重载条件和普通方法相同
public class Student {
        private String name;
        private int age;

        public Student() {}

        public Student(String name) {
                this.name = name;
        }

        public Student(int age) {
                this.age = age;
        }

        public Student(String name,int age) {
                this.name = name;
                this.age = age;
        }

        public void show() {
                System.out.println(name+"---"+age);
        }
}


public class StudentTest {
        public static void main(String[] args) {
                //如何调用构造方法呢?
                //其实通过new关键字就可以
                //格式:类名 对象名 = new 构造方法名(...);
                Student s = new Student();
                s.show();

                //public Student(String name)
                Student s2 = new Student("孙俪");
                s2.show();

                //public Student(int age)
                Student s3 = new Student(30);
                s3.show();

                //public Student(String name,int age)
                Student s4 = new Student("孙俪",30);
                s4.show();
        }
}面向对象三大特征
封装
封装是面向对象三大特征之一,是面向对象编程语言对客观世界的模拟,客观世界里成员变量都是隐藏在对象内部的,外界无法直接操作和修改
封装原则:将不需要对外提供的内容都隐藏起来,把属性隐藏,提供公共方法对其访问,成员变量 private,提供对应的getXxx()/setXxx()方法
封装的好处:通过方法来控制成员变量的操作,提高了代码的安全性,把代码用方法进行封装,提高了代码的复用性
继承
如果有多个类中有相同的特征和行为(属性和方法),并且这多个类之间从逻辑上讲是有一定的关联的。那么此时,我们可以将这些共同的部分单独写到一个类中
-
Monkey: name, age, gender, walk(), sleep(), eat() -
Tiger: name, age, gender, walk(), sleep(), eat() -
Elephants: name, age, gender, walk(), sleep(), eat()
可以将上述三种类中,共同的部分提取出来
Animal: name, age, gender, walk(), sleep(), eat()
此时,被提取出的这个类,称作是--父类,基类,超类
具有相同特征的那些类,称作是--子类,派生类
从A类派生出B类:A是B的父类,B是A的子类
他们之间的关系,是继承:子类继承自父类
为什么使用继承:代码复用+功能拓展
继承的实现:通过 extends 关键字可以实现类与类的继承
格式:public class 子类名 extends 父类名{}
public class Person {
        private String name;
        private int age;

        public Person() {}

        public String getName() {
                return name;
        }

        public void setName(String name) {
                this.name = name;
        }

        public int getAge() {
                return age;
        }

        public void setAge(int age) {
                this.age = age;
        }

}

public class Student extends Person {
        public void study() {
                System.out.println("学生要学到");
        }
}


public class Teacher extends Person {
        public void teach() {
                System.out.println("老师要讲到");
        }
}优点:
-
提高了代码的复用性: 多个类相同的成员可以放到同一个类中
-
提高了代码的维护性:如果功能的代码需要修改,修改一处即可
-
让类与类之间产生了关系,是多态的前提
缺点
-
好处的第三点同时也是继承的弊端,类与类之间产生了关系,让类的耦合性增强了
-
设计原则:高内聚低耦合
Java继承中成员变量的特点
-
成员变量名称不一样,使用的时候非常简单
-
成员变量名称一样的情况:
-
在子类中访问变量:(就近原则)
-
在方法的局部范围找,如果有就使用
-
在子类的成员范围找,如果有就使用
-
在父类的成员范围找,如果有就使用
-
如果还找不到 就报错
public class Father {
        //为了演示案,这里使用public修饰了成员变量,实际开发中用private
        //年龄
        public int age = 45;
}


public class Son extends Father {
        //身高
        public int height = 170;
        //年龄
        public int age = 20;

        public void show() {
                System.out.println(height);
                System.out.println(age);
        }

        public void printAge() {
                int age = 10;
                System.out.println(age);
        }
}


public class ExtendsTest {
        public static void main(String[] args) {
                Son s = new Son();
                //s.show();
                s.printAge();
        }
}super 关键字
super 含义:this 代表本类对象的引用,super 代表父类存储空间的标识(可以理解为父类对象引用)
用法(this 和 super 均可如下使用) :
-
访问成员变量:
this.成员变量super.成员变量 -
访问构造方法
this(…) super(…) -
访问成员方法
this.成员方法()super.成员方法()
public class Father {
        public int age = 45;
}

public class Son extends Father {
        public int age = 20;
        public void printAge() {
            int age = 10;
            System.out.println(age);
            //我要访问子类成员范围的age
            System.out.println(this.age);
            //我要访问父类成员范围的age
            System.out.println(super.age);
        }

}

public class ExtendsTest {
    public static void main(String[] args) {
        Son s = new Son();
        s.printAge();
    }
}继承中构造方法
一个对象在实例化的时候,需要先去实例化从父类继承到的成员,因为子类继承父类,会继承父类的非私有成员。
而子类在初始化的时候,可能会使用父类的数据,如果父类数据没有先初始化,子类就不能使用这些数据,所以,在子类初始化之前,一定要先完成父类数据的初始化。
在实例化父类部分的时候,默认使用父类中的无参构造
问题:如果父类中没有无参构造,或者父类中的无参构造子类无法访问(使用private修饰无参构造),则此时子类对象无法完成实例化。
解决:
-
给父类中添加一个子类能够访问到的无参构造方法
-
在子类的构造方法中,手动调用父类中能够访问到的构造方法,来实例化父类部分
public class Father {

        public Father() {
                System.out.println("Father无参构造方法");
        }


        public Father(String name) {
                System.out.println("Father带参构造方法");
                System.out.println(name);
        }
}

public class Son extends Father {
        public Son() {
                //super();
                super("杨幂");
                System.out.println("Son无参构造方法");
        }

        public Son(String name) {
                //super();
                super("杨幂");
                System.out.println("Son带参构造方法");
                System.out.println(name);
        }
}

public class ExtendsTest {
        public static void main(String[] args) {
                Son s = new Son();
                System.out.println("---------");
                Son s2 = new Son("小幂");
        }
}继承中的成员方法
通过子类对象去访问一个方法
-
首先在子类中找
-
然后在父类中找
-
如果还是没有就会报错
public class Father {
        public void show() {
                System.out.println("Father show");
        }
}
/*
 * Java继承中成员方法的访问特点:
 *                 A:子类中方法和父类中方法的声明不一样,这个太简单
 *                 B:子类中方法和父类中方法的声明一样,调用的到底是谁的呢?
 *                         执行的是子类中的方法。
 */
public class Son extends Father {
        public void method() {
                System.out.println("Son method");
        }

        public void show() {
                System.out.println("Son show");
        }
}

public class ExtendsTest {
        public static void main(String[] args) {
                Son s = new Son();
                s.method();
                s.show();
                //s.function();
        }
}方法重写
用子类的方法实现覆盖掉父类的实现
方法重写:子类中出现了和父类中一模一样的方法声明
应用:当子类需要父类的功能,而功能主体子类有自己特有的内容时,可以重写父类中的方法,这样,即沿袭了父类的功能,又定义了子类特有的内容
注意:@Override:
是一个注解,常用在方法的重写中。表示在进行方法重写之前,进行一个验证。验证这个方法,到底是不是在重写父类中的方法。这个注解,可以添加,也可以不添加。但是,一般情况下,都是要加上去的
-
表明该方法的重写父类的方法
-
方法重写的注意事项
-
父类中私有方法不能被重写
-
子类重写父类方法时,访问权限不能更低
-
子类重写父类方法时,建议访问权限一摸一样
注意
-
访问权限问题: 子类方法的访问权限不能比父类方法中的访问权限低,要大于等于父类方法的访问权限
public > protected > default > private -
关于返回值类型:在重写的时候,要求方法名和参数必须和父类中方法相同 子类方法的返回值类型可以和父类方法中返回值类型相同。也可以是父类方法中返回值类型的子类型。 重载和重写
public class Phone {
        public void call(String name) {
                System.out.println("给"+name+"打电话");
        }
}

public class NewPhone extends Phone {

        public void call(String name) {
                System.out.println("开启视频功能");
                super.call(name);
        }
}
/*
 * 方法重写:子类中出现了和父类中一模一样的方法声明的情况。
 *
 * 方法重写的应用:
 *                 当子类需要父类的功能,而功能主体子类又有自己的特有内容的时候,就考虑使用方法重写,
 *                 这样即保证了父类的功能,还添加了子类的特有内容。
 */
public class PhoneTest {
        public static void main(String[] args) {
                Phone p = new Phone();
                p.call("孙俪");
                System.out.println("-----------");
                NewPhone np = new NewPhone();
                np.call("孙俪");
        }
}继承的特点
-
Java语言是单继承的,一个类只能有一个父类,一个类可以有多个子类 在某些语言中是支持多继承的。例如:C++、python... 但是在多继承中,会有一个问题:二义性。 虽然很多语言都抛弃了多继承,但是还是会用其他的方式来间接的实现类似多继承。 例如:在java中是用接口实现的。
-
Java中所有的类都直接或者简介的继承自 Object 类
-
子类可以访问到父类中能看的见的成员:被public或者protected修饰的
-
构造方法不能继承。
抽象类和抽象方法
抽象类:
abstract class 类名 {
}用关键字abstract修饰的类,就是抽象类
-
抽象类使用abstract来修饰,抽象类不能实例化对象。
-
抽象类中是可以写非静态的成员的,这时候这些非静态成员是可以继承给子类的。
-
抽象类中是可以包含构造方法的。
抽象方法:
用关键字abstract修饰的方法,就是抽象方法,抽象方法,只能够写在抽象类中
public abstract 返回值类型 方法名(参数);特点:抽象方法使用abstract来修饰,只有声明,没有实现。
结合抽象类和抽象方法:非抽象子类在继承一个抽象父类时,要实现父类中所有的抽象方法
//研发工程师
abstract class Developer {
        public abstract void work();//抽象函数。需要abstract修饰,并分号;结束
}

//JavaEE工程师
class JavaEE extends Developer{
        public void work() {
                System.out.println("正在研发淘宝网站");
        }
}

//移动端工程师
class Android extends Developer {
        public void work() {
                System.out.println("正在研发某款app");
        }
}抽象类的特点:
-
抽象类与抽象方法都必须使用 abstract来修饰
-
抽象类不能直接创建对象
-
抽象类中可以有抽象方法,也可以没有抽象方法
-
抽象类的子类:实现了抽象方法的具体类或者抽象类
接口
接口是功能的集合,同样可看做是一种数据类型,是比抽象类更为抽象的”类”
接口只描述所应该具备的方法,并没有具体实现,具体的实现由接口的实现类来完成。这样将功能的定义与实现分离,优化了程序设计。
记住:一切事物均有功能,即一切事物均有接口
接口的特点
-
接口是隐式抽象的,当声明一个接口的时候,不必使用abstract关键字
-
接口中每一个方法也是隐式抽象的,声明时同样不需要abstract关键字
-
接口中的方法都是公有的
接口与类的相似点
-
一个接口可以有多个方法
-
接口文件保存在 .java 结尾的文件中,文件名使用接口名
-
接口的字节码文件保存在 .class 结尾的文件中
-
接口相应的字节码文件必须在与包名称相匹配的目录结构中
接口与类的区别
-
接口不能用于实例化对象。
-
接口没有构造方法。
-
接口中所有的方法必须是抽象方法。
-
接口不能包含成员变量,除了 static 和 final 变量。
-
接口不是被类继承了,而是要被类实现。
-
接口支持多继承。
抽象类与接口的区别
-
抽象类中的方法可以有方法体,就是能实现方法的具体功能,但是接口中的方法不行
-
抽象类中的成员变量可以是各种类型的,而接口中的成员变量只能是 public static final 类型的
-
接口中不能含有静态代码块以及静态方法(用 static 修饰的方法),而抽象类是可以有静态代码块和静态方法
-
一个类只能继承一个抽象类,而一个类却可以实现多个接口
-
注:JDK 1.8 以后,接口里可以有静态方法和方法体了
访问权限修饰符 interface 接口名 {
    抽象方法1;
    抽象方法2;
    抽象方法3;
}访问权限修饰符:和类一样,只能有 public 和默认的default权限。
-
接口不是类,不能实例化对象。
-
接口,暂时和类写成平级的关系。
-
接口名字是一个标识符,遵循大驼峰命名法
接口中成员的定义:
-
属性:接口中的属性,默认的修饰符是 public static final
-
构造方法:接口中不能写构造方法
-
方法: 接口中的方法都是抽象方法 接口中的方法访问权限修饰符都是 public
实现
接口不能实例化
按照多态的方式,由具体的实现类实例化。其实这也是多态的一种,接口多态。
接口的实现类,要么是抽象类,要么重写接口中的所有抽象方法
public class XX extends YY implements ZZ {
    // XXX
}-
一个非抽象类在实现接口后,需要实现接口中所有的抽象方法。
-
一个类在继承自一个父类后,还可以再去实现接口。 如果同时有父类和接口,那么继承父类在前,实现接口在后
-
一个类可以实现多个接口 如果一个类实现的多个接口中有相同的方法,这个方法在实现类中只需要实现一次即可。
-
接口之间是有继承关系的,而且接口之间的继承是多继承。
接口用关键字interface表示,格式:public interface 接口名 {}
类实现接口用implements表示,格式:public class 类名 implements 接口名 {}
public class InterfaceDemo {
        public static void main(String[] args) {
                Cat cat = new Cat();
                cat.clumb()
        }
}

public class Cat implements Clumbing {

        @Override
        public void clumb() {
                System.out.println("猫会爬树");
        }

}

//定义了一个爬树的接口
public interface Clumbing {
        //抽象方法
        public abstract void clumb();
}类、抽象类、接口
三者比较: 类与类:继承关系,只能单继承,但是可以多层继承(生物-》动物=》猫类) 类与接口:实现关系,可以单实现,也可以多实现。还可以在继承一个类的同时实现多个接口 接口与接口:继承关系,可以单继承,也可以多继承 三者区别
-
成员区别:
-
抽象类:变量,常量,有抽象方法,非抽象方法
-
接口:常量,抽象方法
-
关系区别:
-
类与类:继承,单继承
-
类与接口 实现,单实现,多实现
-
接口与接口 继承,单继承,多继承
-
设计理念区别:
-
抽象类:被继承体现的是:”is a”的关系。共性功能
-
接口:被实现体现的是:”like a”的关系。扩展功能
interface 缉毒{
        public abstract void 缉毒();
}
//定义犬科的共性功能
abstract class 犬科{
    public abstract void 吃饭();
    public abstract void 吼叫();
}
// 缉毒犬属于犬科一种,让其继承犬科,获取犬科的特性,
//由于缉毒犬具有缉毒功能,那么它只要实现缉毒接口即可,这样即保证缉毒犬具备犬科的特性,也拥有了缉毒的功能
class 缉毒犬 extends 犬科 implements 缉毒{

        public void 缉毒() {
        }
        void 吃饭() {
        }
        void 吼叫() {
        }
}
class 缉毒猪 implements 缉毒{
        public void 缉毒() {
        }
}多态
某一个事物,在不同时刻表现出来的不同状态
public class TestDemo {
        public static void main(String[] args) {
                //多态
                Animal a = new Cat();

                a.eat();
        }
}

public class Cat extends Animal {
        public int age = 20;
        public int weight = 10;

        public void eat() {
                System.out.println("猫吃鱼");
        }

        public void playGame() {
                System.out.println("猫捉迷藏");
        }
}

public class Animal {
        public int age = 40;

        public void eat() {
                System.out.println("吃东西");
        }
}优缺点:
-
优点:提高了程序的扩展性
-
缺点:不能访问子类特有功能
/*
 * 多态的好处:提高了程序的扩展性
 *                 具体体现:定义方法的时候,使用父类型作为参数,将来在使用的时候,使用具体的子类型参与操作。
 * 多态的弊端:不能使用子类的特有功能
 */
public class TestDemo {
        public static void main(String[] args) {
                AnimalOperator ao = new AnimalOperator();
                Cat c = new Cat();
                ao.useAnimal(c);

                Dog d = new Dog();
                ao.useAnimal(d);

                Pig p = new Pig();
                ao.useAnimal(p);
        }
}

public class AnimalOperator {
        /*
        public void useAnimal(Cat c) { //Cat c = new Cat();
                c.eat();
        }

        public void useAnimal(Dog d) { //Dog d = new Dog();
                d.eat();
        }
        */

        public void useAnimal(Animal a) { //Animal a = new Cat();
                a.eat();
        }
}

public class Cat extends Animal {
        public void eat() {
                System.out.println("猫吃鱼");
        }
}

public class Dog extends Animal {
        public void eat() {
                System.out.println("狗啃骨头");
        }

        public void lookDoor() {
                System.out.println("狗看门");
        }
}

public class Pig extends Animal {
        public void eat() {
                System.out.println("猪拱白菜");
        }
}多态中的转型
体现:
-
父类的引用可以指向子类的对象
-
接口的引用可以指向实现类的对象
转型:
-
向上转型:
-
由子类类型转型为父类类型,或者由实现类类型转型为接口类型
-
向上转型一定会成功,是一个隐式转换
-
向上转型后的对象,将只能访问父类或者接口中的成员
-
向下转型
-
由父类类型转型为子类类型,或者由接口类型转型为实现类类型
-
向下转型可能会失败,是一个显式转换
-
向下转型后的对象,将可以访问子类或者实现类中特有的成员
/*
*        向上转型
*                从子到父
*                父类引用指向子类对象
*        向下转型
*                从父到子
*                父类引用转为子类对象
*/
public class TestDemo {
        public static void main(String[] args) {
                //多态
                Animal a = new Cat(); //向上转型
                a.eat();

                //a.playGame();
                //多态的弊端:无法访问子类特有方法
                //现在我就想使用子类特有方法,怎么办呢?
                //创建子类对象就可以了
                /*
                Cat c = new Cat();
                c.eat();
                c.playGame();
                */
                //现在的代码虽然可以访问子类的特有功能,但是不合理
                //因为我们发现内存中有两个猫类的对象
                //这个时候,我们得想办法把多态中的猫对象还原
                //这个时候,就要使用多态中的转型了
                //父类引用转为子类对象
                Cat c = (Cat)a;
                c.eat();
                c.playGame();
        }
}

public class Cat extends Animal {
        public void eat() {
                System.out.println("猫吃鱼");
        }

        public void playGame() {
                System.out.println("猫捉迷藏");
        }
}

public class Animal {
        public void eat() {
                System.out.println("吃东西");
        }
}instanceof 关键字
针对于向下转型的,如果向下转型不成功,会怎样?会有一个异常 ClassCastException
如何避免这种情况?在向下转型之前,先判断一下这个对象是不是要转型的类型
Animal animal = new Dog();
if (animal instanceof Dog) {
    // 说明animal的确是一个Dog
}如果一个类中重写了父类的某一个方法。
此时:如果用这个类的对象来调用这个方法,最终执行的是子类的实现。如果用向上转型后的对象来调用这个方法,执行的依然是子类的实现。向上转型后的对象,归根到底还是子类对象。
public class TestDemo {
        public static void main(String[] args) {
                //多态
                Animal a = new Cat(); //向下转型
    Cat c = new Cat();
    if(a instanceof Cat)
    c = a
                c.eat();
                c.playGame();
        }
}

public class Cat extends Animal {
        public void eat() {
                System.out.println("猫吃鱼");
        }

        public void playGame() {
                System.out.println("猫捉迷藏");
        }
}

public class Animal {
        public void eat() {
                System.out.println("吃东西");
        }
}包
Java 的包,类似电脑系统中的文件夹,包里存放的是类文件。 当类文件很多的时候,通常会采用多个包进行存放管理,这种方式称为分包管理。 在项目中,我们将相同功能的类放到一个包中,方便管理。并且日常项目的分工也是以包作为边界。 类中声明的包必须与实际class文件所在的文件夹情况相一致,即类声明在a包下,则生成的.class文件必须在a文件夹下,否则,程序运行时会找不到类。
声明格式:
通常使用公司网址反写,可以有多层包,包名采用全部小写字母,多层包之间用.连接
类中包的声明格式:package 包名.包名.包名…;
注意:声明包的语句,必须写在程序有效代码的第一行(注释不算)
package xyz.kbws;
import java.util.Scanner;
import java.util.Random;**包的访问:**在访问类时,为了能够找到该类,必须使用含有包名的类全名,如:包名.包名….类名
java.util.Scanner
//带有包的类,创建对象格式:包名.类名 变量名 = new包名.类名();
java.util.Scanner scan = new java.util.Scanner(System.in);类的简化访问
-
要使用一个类,这个类与当前程序在同一个包中(即同一个文件夹中),或者这个类是
java.lang包中的类时通常可以省略掉包名,直接使用该类 -
要使用的类,与当前程序不在同一个包中(即不同文件夹中),要访问的类必须用
public修饰才可访问
**包的导入:**每次使用类时,都需要写很长的包名。很麻烦,可以通过import导包的方式来简化。
可以通过导包的方式使用该类,可以避免使用全类名编写(即,包类.类名)。
导包的格式:import 包名.类名;
当程序导入指定的包后,使用类时,就可以简化了
//导入包前的方式
//创建对象
java.util.Random r1 = new java.util.Random();
java.util.Random r2 = new java.util.Random();
java.util.Scanner sc1 = new java.util.Scanner(System.in);
java.util.Scanner sc2 = new java.util.Scanner(System.in);

//导入包后的方式
import java.util.Random;
import java.util.Scanner;
//创建对象
Random r1 = new Random();
Random r2 = new Random();
Scanner sc1 = new Scanner(System.in);
Scanner sc2 = new Scanner(System.in);import 导包代码书写的位置:在声明包 package 后,定义所有类 class 前,使用导包 import包名.包名.类名;
访问权限修饰符
用来描述一个类、方法、属性、接口、枚举...能够被访问到的一个范围
访问权限一共有四种:公开(public)/保护(protected)/包(default / package)/私有(private)
public > protected > default > private
对应的访问权限修饰符一共有三个:public/protected/private
注:包权限没有访问权限修饰符,如果一个方法、属性、类...没有使用任意的访问权限修饰符来修饰,那么他的访问权限就是包权限
| 访问权限 | 可以修饰什么 | 可以访问的范围 |
|---|---|---|
| private | 类成员 | 只能在当前的类中访问 |
| default | 类成员、类 | 只能在当前的包中进行访问 |
| protected | 类成员 | 可以在当前的包中访问,也可以在跨包的子类中访问 |
| public | 类成员、类 | 可以在项目中任意的位置进行访问 |
| public | protected | default | private | |
|---|---|---|---|---|
| 同一类中 | √ | √ | √ | √ |
| 同一包中(子类与无关类) | √ | √ | √ | |
| 不同包的子类 | √ | √ | ||
| 不同包中的无关类 | √ |
Final 关键字
| 修饰 | 意义 |
|---|---|
| 变量 | 这个变量的值不能改变,就是常量 |
| 类 | 表示是一个最终类,这个类无法被继承 |
| 方法 | 表示是一个最终方法,这个方法无法被重写 |
继承的出现提高了代码的复用性,并方便开发。但随之也有问题,有些类在描述完之后,不想被继承,或者有些类中的部分方法功能是固定的,不想让子类重写。
要解决上述的这些问题,需要使用到一个关键字final,final的意思为最终,不可变。final是个修饰符,它可以用来修饰类,类的成员,以及局部变量。
final使用: final修饰类不可以被继承,但是可以继承其他类
class XX {}
final class YY extends XX{} //可以继承XX类
class ZZ extends YY{} //不能继承Fu类final修饰的方法不可以被覆盖,但父类中没有被final修饰方法,子类覆盖后可以加final
class Father {
        // final修饰的方法,不可以被覆盖,但可以继承使用
    public final void method1(){}
    public void method2(){}
}
class Son extends Father {
        //重写method2方法
        public final void method2(){}
}final修饰的变量称为常量,这些变量只能赋值一次
final int i = 20;
i = 30; //赋值报错,final修饰的变量只能赋值一次引用类型的变量值为对象地址值,地址值不能更改,但是地址内的对象属性值可以修改
final Person s = new Person();
Person p2 = new Person();
p = p2; //final修饰的变量p,所记录的地址值不能改变
p.name = "小明";//可以更改p对象中name属性值修饰成员变量,需要在创建对象前赋值,否则报错。(当没有显式赋值时,多个构造方法的均需要为其赋值
class Demo {
        //直接赋值
        final int m = 100;

        //final修饰的成员变量,需要在创建对象前赋值,否则报错。
        final int n;
        public Demo(){
                //可以在创建对象时所调用的构造方法中,为变量n赋值
                n = 2020;
        }
}注意:
-
抽象类可以用final来修饰吗?不能!因为final表示这个类无法被继承。但是对于抽象类来说,如果无法被继承,则这个抽象类没有任何意义。
-
抽象方法可以用final修饰吗?不能!因为final修饰的方法无法被重写。但是抽象方法又只能写在抽象类中。如果一个抽象方法用final来修饰了,此时这个方法将无法被非抽象子类重写,那这个子类就会有问题
内部类
内部类概念:将类写在其他类的内部,可以写在其他类的成员位置和局部位置,这时写在其他类内部的类就称为内部类。其他类也称为外部类。 使用时机:在描述事物时,若一个事物内部还包含其他可能包含的事物,比如在描述汽车时,汽车中还包含这发动机,这时发动机就可以使用内部类来描述。
class 汽车 { //外部类
        class 发动机 { //内部类
        }
}成员内部类
成员内部类,定义在外部类中的成员位置。与类中的成员变量相似,可通过外部类对象进行访问。
定义格式
class 外部类 {
        修饰符 class 内部类 {
                //其他代码
        }
}访问方式
外部类名.内部类名 变量名 = new 外部类名().new 内部类名();例子:
public class InnerClass {
    //访问内部类
    public static void main(String[] args) {
        //创建内部类对象
        Body.Heart bh = new Body().new Heart();
        //调用内部类中的方法
        bh.jump();
    }
}

class Body {//外部类,身体
    private boolean life= true; //生命状态
    public class Heart { //内部类,心脏
        public void jump() {
            System.out.println("心脏在跳动");
            System.out.println("生命状态" + life); //访问外部类成员变量
        }
    }
}局部内部类
定义在外部类方法中的局部位置。与访问方法中的局部变量相似,可通过调用方法进行访问。
定义格式
class 外部类 {
        修饰符 返回值类型 方法名(参数) {
                class 内部类 {
                        //其他代码
                }
        }
}访问方式:在外部类方法中,创建内部类对象,进行访问
class Party {//外部类,聚会
        public void puffBall(){// 吹气球方法
                class Ball {// 内部类,气球
              public void puff(){
                                     System.out.println("气球膨胀了");
                          }
                }
        //创建内部类对象,调用puff方法
        new Ball().puff();

        }
}
public class InnerClass {
        //访问内部类
        public static void main(String[] args) {
                //创建外部类对象
                Party p = new Party();
                //调用外部类中的puffBall方法
                p.puffBall();
        }
}匿名内部类
定义的匿名内部类有两个含义:
-
临时定义某一指定类型的子类
-
定义后即刻创建刚刚定义的这个子类的对象
new 父类或接口(){
        //进行方法重写
};//已经存在的父类:
public abstract class Person{
public abstract void eat();
}
//定义并创建该父类的子类对象,并用多态的方式赋值给父类引用变量
Person p = new Person(){
public void eat() {
System.out.println(“eating.......”);
}
};
//调用eat方法
p.eat();使用匿名对象的方式,将定义子类与创建子类对象两个步骤一次完成。
匿名内部类如果不定义变量引用,则也是匿名对象。
new Pers
   on(){
        public void eat() {
                System.out.println(“eating.......”);
        }
}.eat();异常处理
什么是异常
异常 :指的是程序在执行过程中,出现的非正常情况,如果不处理最终会导致JVM的非正常停止
异常指的并不是语法错误和逻辑错误。语法错了,编译不通过,不会产生字节码文件,根本不能运行。
代码逻辑错误,只是没有得到想要的结果,例如:求a与b的和,写成了a-b
异常的抛出机制
Java 中把不同的异常用不同的类表示,一旦发生某种异常,就创建该异常类型的对象 ,并且抛出(throw)。然后程序员可以捕获(catch)到这个异常对象,并处理;如果没有捕获(catch)这个异常对象,那么这个异常对象将会导致程序终止
如何处理异常
对于程序出现的异常,一般有两种解决方法:一是遇到错误就终止程序的运行。另一种方法是程序员在编写程序时,就充分考虑到各种可能发生的异常和错误,极力预防和避免。实在无法避免的,要编写相应的代码进行异常的检测、以及异常的处理,保证代码的健壮性。
Java 的异常体系
Throwable
java.lang.Throwable 类是Java程序执行过程中发生的异常事件对应的类的根父类。
Throwable中的常用方法:
-
public void printStackTrace():打印异常的详细信息。 包含了异常的类型、异常的原因、异常出现的位置、在开发和调试阶段都得使用printStackTrace。 -
public String getMessage():获取发生异常的原因。
Error 和 Exception
Throwable可分为两类:Error和Exception。分别对应着java.lang.Error与java.lang.Exception两个类。
**Error:**Java虚拟机无法解决的严重问题。如:JVM系统内部错误、资源耗尽等严重情况。一般不编写针对性的代码进行处理。
- 例如:StackOverflowError(栈内存溢出)和OutOfMemoryError(堆内存溢出,简称OOM)。
Exception: 其它因编程错误或偶然的外在因素导致的一般性问题,需要使用针对性的代码进行处理,使程序继续运行。否则一旦发生异常,程序也会挂掉。例如:
-
空指针访问
-
试图读取不存在的文件
-
网络连接中断
-
数组角标越界
编译时异常和运行时异常
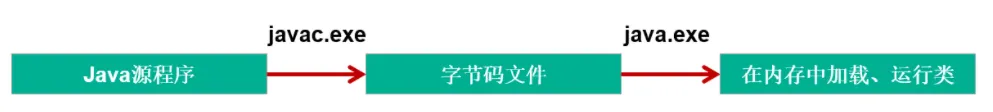
Java程序的执行分为编译时过程和运行时过程。有的错误只有在运行时才会发生。比如:除数为0,数组下标越界等。
因此,根据异常可能出现的阶段,可以将异常分为:
-
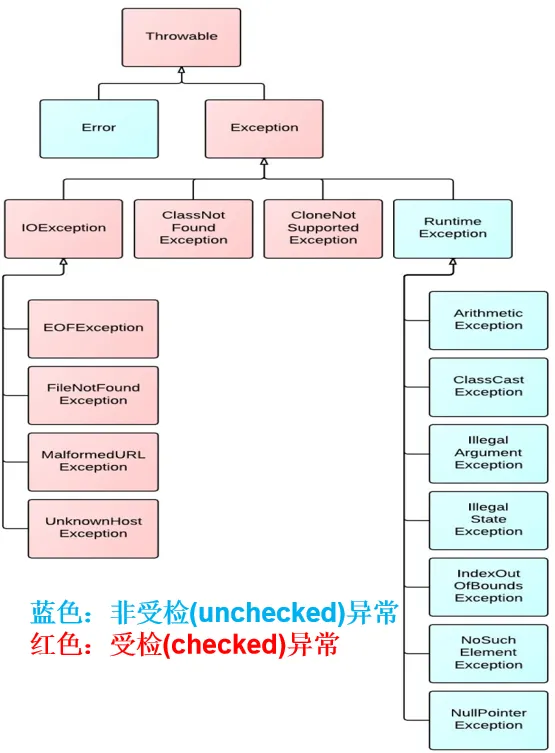
编译时期异常(即checked异常、受检异常):在代码编译阶段,编译器就能明确警示当前代码可能发生(不是一定发生)xx异常,并明确督促程序员提前编写处理它的代码。如果程序员没有编写对应的异常处理代码,则编译器就会直接判定编译失败,从而不能生成字节码文件。通常,这类异常的发生不是由程序员的代码引起的,或者不是靠加简单判断就可以避免的,例如:FileNotFoundException(文件找不到异常)。
-
运行时期异常(即runtime异常、unchecked异常、非受检异常):在代码编译阶段,编译器完全不做任何检查,无论该异常是否会发生,编译器都不给出任何提示。只有等代码运行起来并确实发生了xx异常,它才能被发现。通常,这类异常是由程序员的代码编写不当引起的,只要稍加判断,或者细心检查就可以避免。
-
java.lang.RuntimeException类及它的子类都是运行时异常。比如:ArrayIndexOutOfBoundsException数组下标越界异常,ClassCastException类型转换异常。
常见错误和异常
Error
最常见的就是VirtualMachineError,它有两个经典的子类:StackOverflowError、OutOfMemoryError。
package com.atguigu.exception;

import org.junit.Test;

public class TestStackOverflowError {
    @Test
    public void test01(){
        //StackOverflowError
        recursion();
    }

    public void recursion(){ //递归方法
        recursion();
    }
}package com.atguigu.exception;
import org.junit.Test;
public class TestOutOfMemoryError {
@Test
public void test02(){
//OutOfMemoryError
//方式一:
int[] arr = new int[Integer.MAX_VALUE];
}
@Test
public void test03(){
//OutOfMemoryError
//方式二:
StringBuilder s = new StringBuilder();
while(true){
s.append("atguigu");
}
}
}运行时异常
package com.atguigu.exception;

import org.junit.Test;

import java.util.Scanner;

public class TestRuntimeException {
    @Test
    public void test01(){
        //NullPointerException
        int[][] arr = new int[3][];
        System.out.println(arr[0].length);
    }

    @Test
    public void test02(){
        //ClassCastException
        Object obj = 15;
        String str = (String) obj;
    }

    @Test
    public void test03(){
        //ArrayIndexOutOfBoundsException
        int[] arr = new int[5];
        for (int i = 1; i <= 5; i++) {
            System.out.println(arr[i]);
        }
    }

    @Test
    public void test04(){
        //InputMismatchException
        Scanner input = new Scanner(System.in);
        System.out.print("请输入一个整数:");//输入非整数
        int num = input.nextInt();
        input.close();
    }

    @Test
    public void test05(){
        int a = 1;
        int b = 0;
        //ArithmeticException
        System.out.println(a/b);
    }
}编译时异常
package com.atguigu.exception;

import org.junit.Test;

import java.io.FileInputStream;
import java.io.FileNotFoundException;
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;

public class TestCheckedException {
    @Test
    public void test06() {
        Thread.sleep(1000);//休眠1秒  InterruptedException
    }

    @Test
    public void test07(){
        Class c = Class.forName("java.lang.String");//ClassNotFoundException
    }

    @Test
    public void test08() {
        Connection conn = DriverManager.getConnection("....");  //SQLException
    }
    @Test
    public void test09()  {
        FileInputStream fis = new FileInputStream("尚硅谷Java秘籍.txt"); //FileNotFoundException
    }
    @Test
    public void test10() {
        File file = new File("尚硅谷Java秘籍.txt");
                FileInputStream fis = new FileInputStream(file);//FileNotFoundException
                int b = fis.read();//IOException
                while(b != -1){
                        System.out.print((char)b);
                        b = fis.read();//IOException
                }

                fis.close();//IOException
    }
}异常的处理
概述
在编写程序时,经常要在可能出现错误的地方加上检测的代码,如进行x/y运算时,要检测分母为0,数据为空,输入的不是数据而是字符等。过多的if-else分支会导致程序的代码加长、臃肿,可读性差,程序员需要花很大的精力“堵漏洞”。因此采用异常处理机制。
Java异常处理
Java采用的异常处理机制,是将异常处理的程序代码集中在一起,与正常的程序代码分开,使得程序简洁、优雅,并易于维护。
Java异常处理的方式:
-
Try-catch-finally
-
throws + 异常类型
捕获异常
Java提供了异常处理的抓抛模型。
-
前面提到,Java程序的执行过程中如出现异常,会生成一个异常类对象,该异常对象将被提交给Java运行时系统,这个过程称为
抛出(throw)异常。 -
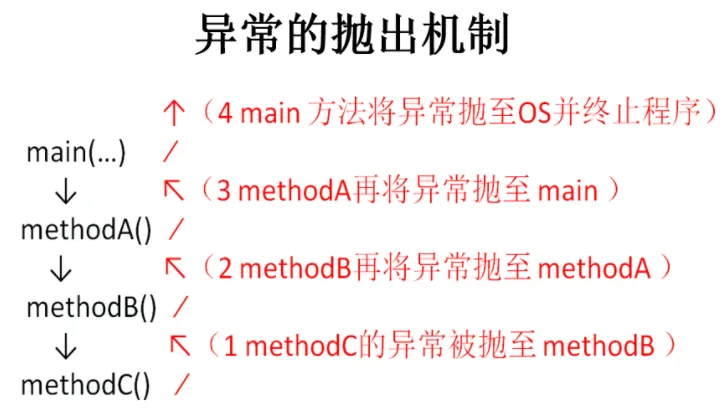
如果一个方法内抛出异常,该异常对象会被抛给调用者方法中处理。如果异常没有在调用者方法中处理,它继续被抛给这个调用方法的上层方法。这个过程将一直继续下去,直到异常被处理。这一过程称为
捕获(catch)异常。 -
如果一个异常回到main()方法,并且main()也不处理,则程序运行终止。
捕获异常语法如下:
try{
        ......        //可能产生异常的代码
}
catch( 异常类型1 e ){
        ......        //当产生异常类型1型异常时的处置措施
}
catch( 异常类型2 e ){
        ......         //当产生异常类型2型异常时的处置措施
}
finally{
        ...... //无论是否发生异常,都无条件执行的语句
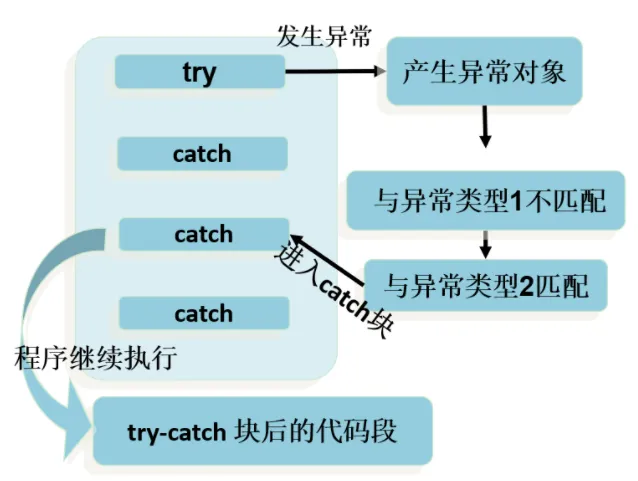
}1、整体执行过程:
当某段代码可能发生异常,不管这个异常是编译时异常(受检异常)还是运行时异常(非受检异常),我们都可以使用try块将它括起来,并在try块下面编写catch分支尝试捕获对应的异常对象。
-
如果在程序运行时,try块中的代码没有发生异常,那么catch所有的分支都不执行。
-
如果在程序运行时,try块中的代码发生了异常,根据异常对象的类型,将从上到下选择第一个匹配的catch分支执行。此时try中发生异常的语句下面的代码将不执行,而整个try...catch之后的代码可以继续运行。
-
如果在程序运行时,try块中的代码发生了异常,但是所有catch分支都无法匹配(捕获)这个异常,那么JVM将会终止当前方法的执行,并把异常对象“抛”给调用者。如果调用者不处理,程序就挂了。
2、try
- 捕获异常的第一步是用
try{…}语句块选定捕获异常的范围,将可能出现异常的业务逻辑代码放在try语句块中。
3、catch (Exceptiontype e)
-
catch分支,分为两个部分,catch()中编写异常类型和异常参数名,{}中编写如果发生了这个异常,要做什么处理的代码。
-
如果明确知道产生的是何种异常,可以用该异常类作为catch的参数;也可以用其父类作为catch的参数。 比如:可以用ArithmeticException类作为参数的地方,就可以用RuntimeException类作为参数,或者用所有异常的父类Exception类作为参数。但不能是与ArithmeticException类无关的异常,如NullPointerException(catch中的语句将不会执行)。
-
每个try语句块可以伴随一个或多个catch语句,用于处理可能产生的不同类型的异常对象。
-
如果有多个catch分支,并且多个异常类型有父子类关系,必须保证小的子异常类型在上,大的父异常类型在下。否则,报错。
-
catch中常用异常处理的方式
-
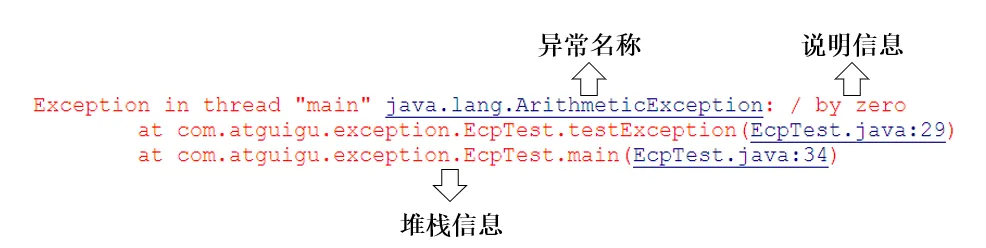
public String getMessage():获取异常的描述信息,返回字符串 -
public void printStackTrace():打印异常的跟踪栈信息并输出到控制台。包含了异常的类型、异常的原因、还包括异常出现的位置,在开发和调试阶段,都得使用printStackTrace()。
finally 使用及举例
-
因为异常会引发程序跳转,从而会导致有些语句执行不到。而程序中有一些特定的代码无论异常是否发生,都
需要执行。例如,数据库连接、输入流输出流、Socket连接、Lock锁的关闭等,这样的代码通常就会放到finally块中。所以,我们通常将一定要被执行的代码声明在finally中。 -
唯一的例外,使用 System.exit(0) 来终止当前正在运行的 Java 虚拟机。
-
不论在try代码块中是否发生了异常事件,catch语句是否执行,catch语句是否有异常,catch语句中是否有return,finally块中的语句都会被执行。
-
finally语句和catch语句是可选的,但finally不能单独使用。
try{

}finally{

}举例:确保资源关闭
package com.atguigu.keyword;

import java.util.InputMismatchException;
import java.util.Scanner;

public class TestFinally {
    public static void main(String[] args) {
        Scanner input = new Scanner(System.in);
        try {
            System.out.print("请输入第一个整数:");
            int a = input.nextInt();
            System.out.print("请输入第二个整数:");
            int b = input.nextInt();
            int result = a/b;
            System.out.println(a + "/" + b +"=" + result);
        } catch (InputMismatchException e) {
            System.out.println("数字格式不正确,请输入两个整数");
        }catch (ArithmeticException e){
            System.out.println("第二个整数不能为0");
        } finally {
            System.out.println("程序结束,释放资源");
            input.close();
        }
    }

    @Test
    public void test1(){
        FileInputStream fis = null;
        try{
            File file = new File("hello1.txt");
            fis = new FileInputStream(file);//FileNotFoundException
            int b = fis.read();//IOException
            while(b != -1){
                System.out.print((char)b);
                b = fis.read();//IOException
            }

        }catch(IOException e){
            e.printStackTrace();
        }finally{
            try {
                if(fis != null)
                    fis.close();//IOException
            } catch (IOException e) {
                e.printStackTrace();
            }
        }
    }
}-
前面使用的异常都是
RuntimeException类或是它的子类,这些类的异常的特点是:即使没有使用try和catch捕获,Java自己也能捕获,并且编译通过 ( 但运行时会发生异常使得程序运行终止 )。所以,对于这类异常,可以不作处理,因为这类异常很普遍,若全处理可能会对程序的可读性和运行效率产生影响。 -
如果抛出的异常是IOException等类型的
非运行时异常,则必须捕获,否则编译错误。也就是说,我们必须处理编译时异常,将异常进行捕捉,转化为运行时异常。
声明抛出异常类型
如果在编写方法体的代码时,某句代码可能发生某个编译时异常,不处理编译不通过,但是在当前方法体中可能不适合处理或无法给出合理的处理方式,则此方法应显示地声明抛出异常,表明该方法将不对这些异常进行处理,而由该方法的调用者负责处理。
具体方式:在方法声明中用throws语句可以声明抛出异常的列表,throws后面的异常类型可以是方法中产生的异常类型,也可以是它的父类。
声明抛出异常格式:
修饰符 返回值类型 方法名(参数) throws 异常类名1,异常类名2…{ }在throws后面可以写多个异常类型,用逗号隔开
举例:
public void readFile(String file)  throws FileNotFoundException,IOException {
        ...
        // 读文件的操作可能产生FileNotFoundException或IOException类型的异常
        FileInputStream fis = new FileInputStream(file);
    //...
}针对于编译时异常
package com.atguigu.keyword;

public class TestThrowsCheckedException {
    public static void main(String[] args) {
        System.out.println("上课.....");
        try {
            afterClass();//换到这里处理异常
        } catch (InterruptedException e) {
            e.printStackTrace();
            System.out.println("准备提前上课");
        }
        System.out.println("上课.....");
    }

    public static void afterClass() throws InterruptedException {
        for(int i=10; i>=1; i--){
            Thread.sleep(1000);//本来应该在这里处理异常
            System.out.println("距离上课还有:" + i + "分钟");
        }
    }
}方法重写时,对于方法签名是有严格要求的
(1)方法名必须相同
(2)形参列表必须相同
(3)返回值类型
        - 基本数据类型和void:必须相同
        - 引用数据类型:<=
(4)权限修饰符:>=,而且要求父类被重写方法在子类中是可见的
(5)不能是static,final修饰的方法此外,对于throws异常列表要求:
-
如果父类被重写方法的方法签名后面没有 “throws 编译时异常类型”,那么重写方法时,方法签名后面也不能出现“throws 编译时异常类型”。
-
如果父类被重写方法的方法签名后面有 “
throws 编译时异常类型”,那么重写方法时,throws的编译时异常类型必须 <= 被重写方法throws的编译时异常类型,或者不throws编译时异常。 -
方法重写,对于“
throws 运行时异常类型”没有要求。
package com.atguigu.keyword;

import java.io.IOException;

class Father{
    public void method()throws Exception{
        System.out.println("Father.method");
    }
}
class Son extends Father{
    @Override
    public void method() throws IOException,ClassCastException {
        System.out.println("Son.method");
    }
}两种异常处理方式的选择:
前提:对于异常,使用相应的处理方式。此时的异常,主要指的是编译时异常。
-
如果程序代码中,涉及到资源的调用(流、数据库连接、网络连接等),则必须考虑使用try-catch-finally来处理,保证不出现内存泄漏。
-
如果父类被重写的方法没有throws异常类型,则子类重写的方法中如果出现异常,只能考虑使用try-catch-finally进行处理,不能throws。
-
开发中,方法a中依次调用了方法b,c,d等方法,方法b,c,d之间是递进关系。此时,如果方法b,c,d中有异常,我们通常选择使用throws,而方法a中通常选择使用try-catch-finally。
Java 中异常对象的生成有两种方式:
-
由虚拟机自动生成:程序运行过程中,虚拟机检测到程序发生了问题,那么针对当前代码,就会在后台自动创建一个对应异常类的实例对象并抛出。
-
由开发人员手动创建:
new 异常类型([实参列表]);,如果创建好的异常对象不抛出对程序没有任何影响,和创建一个普通对象一样,但是一旦throw抛出,就会对程序运行产生影响了。
throw语句抛出的异常对象,和JVM自动创建和抛出的异常对象一样。
-
如果是编译时异常类型的对象,同样需要使用throws或者try...catch处理,否则编译不通过。
-
如果是运行时异常类型的对象,编译器不提示。
-
可以抛出的异常必须是Throwable或其子类的实例。下面的语句在编译时将会产生语法错误:
使用注意点:
无论是编译时异常类型的对象,还是运行时异常类型的对象,如果没有被try..catch合理的处理,都会导致程序崩溃。
throw语句会导致程序执行流程被改变,throw语句是明确抛出一个异常对象,因此它下面的代码将不会执行。
如果当前方法没有try...catch处理这个异常对象,throw语句就会代替return语句提前终止当前方法的执行,并返回一个异常对象给调用者。
public class TestThrow {
    public static void main(String[] args) {
        try {
            System.out.println(max(4,2,31,1));
        } catch (Exception e) {
            e.printStackTrace();
        }
        try {
            System.out.println(max(4));
        } catch (Exception e) {
            e.printStackTrace();
        }
        try {
            System.out.println(max());
        } catch (Exception e) {
            e.printStackTrace();
        }
    }

    public static int max(int... nums){
        if(nums == null || nums.length==0){
            throw new IllegalArgumentException("没有传入任何整数,无法获取最大值");
        }
        int max = nums[0];
        for (int i = 1; i < nums.length; i++) {
            if(nums[i] > max){
                max = nums[i];
            }
        }
        return max;
    }
}自定义异常
为什么需要自定义异常:Java中不同的异常类,分别表示着某一种具体的异常情况。那么在开发中总是有些异常情况是核心类库中没有定义好的,此时我们需要根据自己业务的异常情况来定义异常类。例如年龄负数问题,考试成绩负数问题,某员工已在团队中等。
如何自定义异常类:
-
要继承一个异常类型
-
自定义一个编译时异常类型:自定义类继承
java.lang.Exception。 -
自定义一个运行时异常类型:自定义类继承
java.lang.RuntimeException。 -
建议大家提供至少两个构造器,一个是无参构造,一个是(String message)构造器。
-
自定义异常需要提供
serialVersionUID
注意点:
-
自定义的异常只能通过throw抛出。
-
自定义异常最重要的是异常类的名字和message属性。当异常出现时,可以根据名字判断异常类型。比如:
TeamException("成员已满,无法添加");、TeamException("该员工已是某团队成员"); -
自定义异常对象只能手动抛出。抛出后由try..catch处理,也可以甩锅throws给调用者处理。
多线程
相关概念
程序、进程与线程
-
程序(program):为完成特定任务,用某种语言编写的
一组指令的集合。即指一段静态的代码,静态对象。 -
进程(process):程序的一次执行过程,或是正在内存中运行的应用程序。如:运行中的QQ,运行中的网易音乐播放器。
-
每个进程都有一个独立的内存空间,系统运行一个程序即是一个进程从创建、运行到消亡的过程。(生命周期)
-
程序是静态的,进程是动态的
-
进程作为
操作系统调度和分配资源的最小单位(亦是系统运行程序的基本单位),系统在运行时会为每个进程分配不同的内存区域。 -
线程(thread):进程可进一步细化为线程,是程序内部的
一条执行路径。一个进程中至少有一个线程。 -
一个进程同一时间若
并行执行多个线程,就是支持多线程的 -
线程作为
CPU调度和执行的最小单位 -
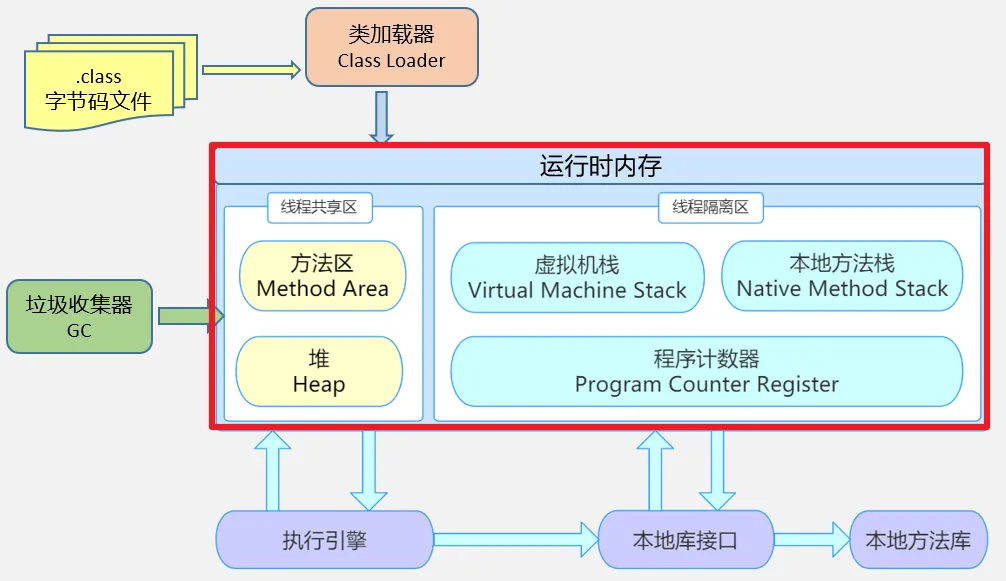
一个进程中的多个线程共享相同的内存单元,它们从同一个堆中分配对象,可以访问相同的变量和对象。这就使得线程间通信更简便、高效。但多个线程操作共享的系统资源可能就会带来
安全的隐患。 -
下图中,红框的蓝色区域为线程独享,黄色区域为线程共享。
注意:
不同的进程之间是不共享内存的。
进程之间的数据交换和通信的成本很高。
线程调度
-
分时调度:所有线程
轮流使用CPU 的使用权,并且平均分配每个线程占用 CPU 的时间。 -
抢占式调度:让
优先级高的线程以较大的概率优先使用 CPU。如果线程的优先级相同,那么会随机选择一个(线程随机性),Java使用的为抢占式调度。
多线程程序的优点
背景:以单核CPU为例,只使用单个线程先后完成多个任务(调用多个方法),肯定比用多个线程来完成用的时间更短,为何仍需多线程呢?
多线程程序的优点:
-
提高应用程序的响应。对图形化界面更有意义,可增强用户体验。
-
提高计算机系统CPU的利用率
-
改善程序结构。将既长又复杂的进程分为多个线程,独立运行,利于理解和修改
单核CPU和多核CPU
单核CPU,在一个时间单元内,只能执行一个线程的任务
这时候想要提升系统性能,只有两个办法,要么提升CPU性能,要么多加几个CPU,即为多核的CPU。
问题:多核的效率是单核的倍数吗?譬如4核A53的cpu,性能是单核A53的4倍吗?理论上是,但是实际不可能,至少有两方面的损耗。
-
一个是多个核心的其他共用资源限制。譬如,4核CPU对应的内存、cache、寄存器并没有同步扩充4倍。这就好像医院一样,1个医生换4个医生,但是做B超检查的还是一台机器,性能瓶颈就从医生转到B超检查了。 -
另一个是多核CPU之间的协调管理损耗。譬如多个核心同时运行两个相关的任务,需要考虑任务同步,这也需要消耗额外性能。好比公司工作,一个人的时候至少不用开会浪费时间,自己跟自己商量就行了。两个人就要开会同步工作,协调分配,所以工作效率绝对不可能达到2倍
并行与并发
-
并行(parallel):指两个或多个事件在
同一时刻发生(同时发生)。指在同一时刻,有多条指令在多个CPU上同时执行。比如:多个人同时做不同的事。 -
并发(concurrency):指两个或多个事件在
同一个时间段内发生。即在一段时间内,有多条指令在单个CPU上快速轮换、交替执行,使得在宏观上具有多个进程同时执行的效果。
在操作系统中,启动了多个程序,并发指的是在一段时间内宏观上有多个程序同时运行,这在单核 CPU 系统中,每一时刻只能有一个程序执行,即微观上这些程序是分时的交替运行,只不过是给人的感觉是同时运行,那是因为分时交替运行的时间是非常短的。
而在多核 CPU 系统中,则这些可以并发执行的程序便可以分配到多个CPU上,实现多任务并行执行,即利用每个处理器来处理一个可以并发执行的程序,这样多个程序便可以同时执行。目前电脑市场上说的多核 CPU,便是多核处理器,核越多,并行处理的程序越多,能大大的提高电脑运行的效率。
创建和启动线程
Java语言的JVM允许程序运行多个线程,使用java.lang.Thread类代表线程,所有的线程对象都必须是Thread类或其子类的实例。
Thread类的特性
-
每个线程都是通过某个特定Thread对象的run()方法来完成操作的,因此把
run()方法体称为线程执行体。 -
通过该Thread对象的start()方法来启动这个线程,而非直接调用
run() -
要想实现多线程,必须在主线程中创建新的线程对象。
Java通过继承Thread类来创建并启动多线程的步骤如下:
-
定义Thread类的子类,并重写该类的run()方法,该run()方法的方法体就代表了线程需要完成的任务
-
创建Thread子类的实例,即创建了线程对象
-
调用线程对象的start()方法来启动该线程
1. 继承Thread 类
//自定义线程类
public class MyThread extends Thread {
    //定义指定线程名称的构造方法
    public MyThread(String name) {
        //调用父类的String参数的构造方法,指定线程的名称
        super(name);
    }
    /**
     * 重写run方法,完成该线程执行的逻辑
     */
    @Override
    public void run() {
        for (int i = 0; i < 10; i++) {
            System.out.println(getName()+":正在执行!"+i);
        }
    }
}测试类:
public class TestMyThread {
    public static void main(String[] args) {
        //创建自定义线程对象1
        MyThread mt1 = new MyThread("子线程1");
        //开启子线程1
        mt1.start();

        //创建自定义线程对象2
        MyThread mt2 = new MyThread("子线程2");
        //开启子线程2
        mt2.start();

        //在主方法中执行for循环
        for (int i = 0; i < 10; i++) {
            System.out.println("main线程!"+i);
        }
    }
}注意:
如果自己手动调用run()方法,那么就只是普通方法,没有启动多线程模式。
run()方法由JVM调用,什么时候调用,执行的过程控制都有操作系统的CPU调度决定。
想要启动多线程,必须调用start方法。
一个线程对象只能调用一次start()方法启动,如果重复调用了,则将抛出以上的异常“
IllegalThreadStateException”。
2. 实现 Runnable 接口
Java有单继承的限制,当无法继承Thread类时,那么该如何做呢?在核心类库中提供了Runnable接口,我们可以实现Runnable接口,重写run()方法,然后再通过Thread类的对象代理启动和执行我们的线程体run()方法
步骤如下:
-
定义Runnable接口的实现类,并重写该接口的run()方法,该run()方法的方法体同样是该线程的线程执行体。
-
创建Runnable实现类的实例,并以此实例作为Thread的target参数来创建Thread对象,该Thread对象才是真正 的线程对象。
-
调用线程对象的start()方法,启动线程。调用Runnable接口实现类的run方法。
代码如下:
public class MyRunnable implements Runnable {
    @Override
    public void run() {
        for (int i = 0; i < 20; i++) {
            System.out.println(Thread.currentThread().getName() + " " + i);
        }
    }
}测试类:
public class TestMyRunnable {
    public static void main(String[] args) {
        //创建自定义类对象  线程任务对象
        MyRunnable mr = new MyRunnable();
        //创建线程对象
        Thread t = new Thread(mr, "长江");
        t.start();
        for (int i = 0; i < 20; i++) {
            System.out.println("黄河 " + i);
        }
    }
}通过实现Runnable接口,使得该类有了多线程类的特征。所有的分线程要执行的代码都在run方法里面。
在启动的多线程的时候,需要先通过Thread类的构造方法Thread(Runnable target) 构造出对象,然后调用Thread对象的start()方法来运行多线程代码。
实际上,所有的多线程代码都是通过运行Thread的start()方法来运行的。因此,不管是继承Thread类还是实现 Runnable 接口来实现多线程,最终还是通过 Thread 的对象的 API 来控制线程的,熟悉 Thread 类的API是进行多线程编程的基础。
说明:Runnable对象仅仅作为Thread对象的target,Runnable实现类里包含的run()方法仅作为线程执行体。
而实际的线程对象依然是Thread实例,只是该Thread线程负责执行其target的run()方法
3. 变形写法
使用匿名内部类对象来实现线程的创建和启动
new Thread("新的线程!"){
        @Override
        public void run() {
                for (int i = 0; i < 10; i++) {
                        System.out.println(getName()+":正在执行!"+i);
                }
        }
}.start();new Thread(new Runnable(){
@Override
public void run() {
for (int i = 0; i < 10; i++) {
System.out.println(Thread.currentThread().getName()+":" + i);
}
}
}).start();对比上面两种方式:
Thread类实际上也是实现了Runnable接口的类:
public class Thread extends Object implements Runnable区别
-
继承Thread:线程代码存放Thread子类run方法中。
-
实现Runnable:线程代码存在接口的子类的run方法。
实现Runnable接口比继承Thread类所具有的优势
-
避免了单继承的局限性
-
多个线程可以共享同一个接口实现类的对象,非常适合多个相同线程来处理同一份资源。
-
增加程序的健壮性,实现解耦操作,代码可以被多个线程共享,代码和线程独立。
Thread 类的常用结构
构造器
-
public Thread() :分配一个新的线程对象。
-
public Thread(String name) :分配一个指定名字的新的线程对象。
-
public Thread(Runnable target) :指定创建线程的目标对象,它实现了Runnable接口中的run方法
-
public Thread(Runnable target,String name) :分配一个带有指定目标新的线程对象并指定名字。
常用方法系列:
-
public void run() :此线程要执行的任务在此处定义代码。
-
public void start() :导致此线程开始执行; Java虚拟机调用此线程的run方法。
-
public String getName() :获取当前线程名称。
-
public void setName(String name):设置该线程名称。
-
public static Thread currentThread() :返回对当前正在执行的线程对象的引用。在Thread子类中就是this,通常用于主线程和Runnable实现类
-
public static void sleep(long millis) :使当前正在执行的线程以指定的毫秒数暂停(暂时停止执行)。
-
public static void yield():yield只是让当前线程暂停一下,让系统的线程调度器重新调度一次,希望优先级与当前线程相同或更高的其他线程能够获得执行机会,但是这个不能保证,完全有可能的情况是,当某个线程调用了yield方法暂停之后,线程调度器又将其调度出来重新执行。
-
public final boolean isAlive():测试线程是否处于活动状态。如果线程已经启动且尚未终止,则为活动状态。
-
void join() :等待该线程终止。
-
void join(long millis) :等待该线程终止的时间最长为 millis 毫秒。如果millis时间到,将不再等待。 void join(long millis, int nanos) :等待该线程终止的时间最长为 millis 毫秒 + nanos 纳秒。
-
public final void stop():
已过时,不建议使用。强行结束一个线程的执行,直接进入死亡状态。run()即刻停止,可能会导致一些清理性的工作得不到完成,如文件,数据库等的关闭。同时,会立即释放该线程所持有的所有的锁,导致数据得不到同步的处理,出现数据不一致的问题。 -
void suspend() / void resume() : 这两个操作就好比播放器的暂停和恢复。二者必须成对出现,否则非常容易发生死锁。suspend()调用会导致线程暂停,但不会释放任何锁资源,导致其它线程都无法访问被它占用的锁,直到调用
-
resume()。
已过时,不建议使用。
每个线程都有一定的优先级,同优先级线程组成先进先出队列(先到先服务),使用分时调度策略。优先级高的线程采用抢占式策略,获得较多的执行机会。每个线程默认的优先级都与创建它的父线程具有相同的优先级。
-
Thread类的三个优先级常量:
-
MAX_PRIORITY(10):最高优先级
-
MIN _PRIORITY (1):最低优先级
-
NORM_PRIORITY (5):普通优先级,默认情况下main线程具有普通优先级。
-
public final int getPriority() :返回线程优先级
-
public final void setPriority(int newPriority) :改变线程的优先级,范围在[1,10]之间。
练习:获取main线程对象的名称和优先级。
声明一个匿名内部类继承Thread类,重写run方法,在run方法中获取线程名称和优先级。设置该线程优先级为最高优先级并启动该线程。
public static void main(String[] args) {
    Thread t = new Thread(){
        public void run(){
            System.out.println(getName() + "的优先级:" + getPriority());
        }
    };
    t.setPriority(Thread.MAX_PRIORITY);
    t.start();

    System.out.println(Thread.currentThread().getName() +"的优先级:" + Thread.currentThread().getPriority());
}案例:
-
声明一个匿名内部类继承Thread类,重写run方法,实现打印[1,100]之间的偶数,要求每隔1秒打印1个偶数。
-
声明一个匿名内部类继承Thread类,重写run方法,实现打印[1,100]之间的奇数,
-
当打印到5时,让奇数线程暂停一下,再继续。
-
当打印到5时,让奇数线程停下来,让偶数线程执行完再打印。
public class TestThreadStateChange {
    public static void main(String[] args) {
        Thread te = new Thread() {
            @Override
            public void run() {
                for (int i = 2; i <= 100; i += 2) {
                    System.out.println("偶数线程:" + i);
                    try {
                        Thread.sleep(1000);
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                }
            }
        };
        te.start();

        Thread to = new Thread() {
            @Override
            public void run() {
                for (int i = 1; i <= 100; i += 2) {
                    System.out.println("奇数线程:" + i);
                    if (i == 5) {
//                        Thread.yield();
                        try {
                            te.join();
                        } catch (InterruptedException e) {
                            e.printStackTrace();
                        }
                    }

                }
            }
        };
        to.start();
    }
}守护线程
有一种线程,它是在后台运行的,它的任务是为其他线程提供服务的,这种线程被称为“守护线程”。JVM的垃圾回收线程就是典型的守护线程
守护线程有个特点,就是如果所有非守护线程都死亡,那么守护线程自动死亡。形象理解:兔死狗烹,鸟尽弓藏
调用setDaemon(true)方法可将指定线程设置为守护线程。必须在线程启动之前设置,否则会报IllegalThreadStateException异常。
调用isDaemon()可以判断线程是否是守护线程。
public class TestThread {
        public static void main(String[] args) {
                MyDaemon m = new MyDaemon();
                m.setDaemon(true);
                m.start();

                for (int i = 1; i <= 100; i++) {
                        System.out.println("main:" + i);
                }
        }
}

class MyDaemon extends Thread {
        public void run() {
                while (true) {
                        System.out.println("我一直守护...");
                        try {
                                Thread.sleep(1);
                        } catch (InterruptedException e) {
                                e.printStackTrace();
                        }
                }
        }
}多线程的生命周期
Java语言使用Thread类及其子类的对象来表示线程,在它的一个完整的生命周期中通常要经历如下一些状态:
JDK1.5 之前:5 种状态
线程的生命周期有五种状态:新建(New)、就绪(Runnable)、运行(Running)、阻塞(Blocked)、死亡(Dead)。CPU需要在多条线程之间切换,于是线程状态会多次在运行、阻塞、就绪之间切换。
1.新建
当一个Thread类或其子类的对象被声明并创建时,新生的线程对象处于新建状态。此时它和其他Java对象一样,仅仅由JVM为其分配了内存,并初始化了实例变量的值。此时的线程对象并没有任何线程的动态特征,程序也不会执行它的线程体run()
2.就绪
但是当线程对象调用了start()方法之后,就不一样了,线程就从新建状态转为就绪状态。JVM会为其创建方法调用栈和程序计数器,当然,处于这个状态中的线程并没有开始运行,只是表示已具备了运行的条件,随时可以被调度。至于什么时候被调度,取决于JVM里线程调度器的调度。
注意:
程序只能对新建状态的线程调用start(),并且只能调用一次,如果对非新建状态的线程,如已启动的线程或已死亡的线程调用start()都会报错IllegalThreadStateException异常
3.运行
如果处于就绪状态的线程获得了CPU资源时,开始执行run()方法的线程体代码,则该线程处于运行状态。如果计算机只有一个CPU核心,在任何时刻只有一个线程处于运行状态,如果计算机有多个核心,将会有多个线程并行(Parallel)执行。
CPU讲究雨露均沾。对于抢占式策略的系统而言,系统会给每个可执行的线程一个小时间段来处理任务,当该时间用完,系统会剥夺该线程所占用的资源,让其回到就绪状态等待下一次被调度。此时其他线程将获得执行机会,而在选择下一个线程时,系统会适当考虑线程的优先级。
4.阻塞
当在运行过程中的线程遇到如下情况时,会让出 CPU 并临时中止自己的执行,进入阻塞状态:
-
线程调用了sleep()方法,主动放弃所占用的CPU资源;
-
线程试图获取一个同步监视器,但该同步监视器正被其他线程持有;
-
线程执行过程中,同步监视器调用了wait(),让它等待某个通知(notify);
-
线程执行过程中,同步监视器调用了wait(time)
-
线程执行过程中,遇到了其他线程对象的加塞(join);
-
线程被调用suspend方法被挂起(已过时,因为容易发生死锁);
当前正在执行的线程被阻塞后,其他线程就有机会执行了。针对如上情况,当发生如下情况时会解除阻塞,让该线程重新进入就绪状态,等待线程调度器再次调度它:
-
线程的sleep()时间到;
-
线程成功获得了同步监视器;
-
线程等到了通知(notify);
-
线程wait的时间到了
-
加塞的线程结束了;
-
被挂起的线程又被调用了resume恢复方法(已过时,因为容易发生死锁);
5.死亡
线程会以以下三种方式之一结束,结束后的线程就处于死亡状态:
-
run()方法执行完成,线程正常结束
-
线程执行过程中抛出了一个未捕获的异常(Exception)或错误(Error)
-
直接调用该线程的stop()来结束该线程(已过时)
JDK1.5及之后:6 种状态
在java.lang.Thread.State的枚举类中这样定义:
public enum State {
        NEW,
        RUNNABLE,
        BLOCKED,
        WAITING,
        TIMED_WAITING,
        TERMINATED;
}-
NEW(新建):线程刚被创建,但是并未启动。还没调用start方法。 -
RUNNABLE(可运行):这里没有区分就绪和运行状态。因为对于Java对象来说,只能标记为可运行,至于什么时候运行,不是JVM来控制的了,是OS来进行调度的,而且时间非常短暂,因此对于Java对象的状态来说,无法区分。 -
Teminated(被终止):表明此线程已经结束生命周期,终止运行。 -
重点说明,根据Thread.State的定义,阻塞状态分为三种:
BLOCKED、WAITING、TIMED_WAITING。 -
BLOCKED(锁阻塞):在API中的介绍为:一个正在阻塞、等待一个监视器锁(锁对象)的线程处于这一状态。只有获得锁对象的线程才能有执行机会。 -
比如,线程A与线程B代码中使用同一锁,如果线程A获取到锁,线程A进入到Runnable状态,那么线程B就进入到Blocked锁阻塞状态。
-
TIMED_WAITING(计时等待):在API中的介绍为:一个正在限时等待另一个线程执行一个(唤醒)动作的线程处于这一状态。 -
当前线程执行过程中遇到Thread类的
sleep或join,Object类的wait,LockSupport类的park方法,并且在调用这些方法时,设置了时间,那么当前线程会进入TIMED_WAITING,直到时间到,或被中断。 -
WAITING(无限等待):在API中介绍为:一个正在无限期等待另一个线程执行一个特别的(唤醒)动作的线程处于这一状态。 -
当前线程执行过程中遇到遇到Object类的
wait,Thread类的join,LockSupport类的park方法,并且在调用这些方法时,没有指定时间,那么当前线程会进入WAITING状态,直到被唤醒。 -
通过Object类的wait进入WAITING状态的要有Object的notify/notifyAll唤醒;
-
通过Condition的await进入WAITING状态的要有Condition的signal方法唤醒;
-
通过LockSupport类的park方法进入WAITING状态的要有LockSupport类的unpark方法唤醒
-
通过Thread类的join进入WAITING状态,只有调用join方法的线程对象结束才能让当前线程恢复;
说明:当从WAITING或TIMED_WAITING恢复到Runnable状态时,如果发现当前线程没有得到监视器锁,那么会立刻转入BLOCKED状态
举例:
public class ThreadStateTest {
    public static void main(String[] args) throws InterruptedException {
        SubThread t = new SubThread();
        System.out.println(t.getName() + " 状态 " + t.getState());
        t.start();

        while (Thread.State.TERMINATED != t.getState()) {
            System.out.println(t.getName() + " 状态 " + t.getState());
            Thread.sleep(500);
        }
        System.out.println(t.getName() + " 状态 " + t.getState());
    }
}

class SubThread extends Thread {
    @Override
    public void run() {
        while (true) {
            for (int i = 0; i < 10; i++) {
                System.out.println("打印:" + i);
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
            break;
        }
    }
}线程安全问题及解决
当使用多个线程访问同一资源(可以是同一个变量、同一个文件、同一条记录等)的时候,若多个线程只有读操作,那么不会发生线程安全问题。但是如果多个线程中对资源有读和写的操作,就容易出现线程安全问题。
同一个资源问题和线程安全问题
案例:
火车站要卖票,我们模拟火车站的卖票过程。因为疫情期间,本次列车的座位共100个(即,只能出售100张火车票)。我们来模拟车站的售票窗口,实现多个窗口同时售票的过程。注意:不能出现错票、重票。
局部变量不能共享
示例代码:
class Window extends Thread {
    public void run() {
        int ticket = 100;
        while (ticket > 0) {
            System.out.println(getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        }
    }
}

public class SaleTicketDemo1 {
    public static void main(String[] args) {
        Window w1 = new Window();
        Window w2 = new Window();
        Window w3 = new Window();

        w1.setName("窗口1");
        w2.setName("窗口2");
        w3.setName("窗口3");

        w1.start();
        w2.start();
        w3.start();
    }
}结果:发现卖出300张票。
问题:局部变量是每次调用方法都是独立的,那么每个线程的run()的ticket是独立的,不是共享数据。
不同对象的实例变量不共享
class TicketWindow extends Thread {
    private int ticket = 100;

    public void run() {
        while (ticket > 0) {
            System.out.println(getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        }
    }
}

public class SaleTicketDemo2 {
    public static void main(String[] args) {
        TicketWindow w1 = new TicketWindow();
        TicketWindow w2 = new TicketWindow();
        TicketWindow w3 = new TicketWindow();

        w1.setName("窗口1");
        w2.setName("窗口2");
        w3.setName("窗口3");

        w1.start();
        w2.start();
        w3.start();
    }
}结果:发现卖出300张票。
问题:不同的实例对象的实例变量是独立的。
静态变量是共享的
示例代码:
class TicketSaleThread extends Thread {
    private static int ticket = 100;

    public void run() {
        while (ticket > 0) {
            try {
                Thread.sleep(10);//加入这个,使得问题暴露的更明显
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println(getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        }
    }
}

public class SaleTicketDemo3 {
    public static void main(String[] args) {
        TicketSaleThread t1 = new TicketSaleThread();
        TicketSaleThread t2 = new TicketSaleThread();
        TicketSaleThread t3 = new TicketSaleThread();

        t1.setName("窗口1");
        t2.setName("窗口2");
        t3.setName("窗口3");

        t1.start();
        t2.start();
        t3.start();
    }
}运行结果:
窗口1卖出一张票,票号:100
窗口2卖出一张票,票号:100
窗口3卖出一张票,票号:100
窗口3卖出一张票,票号:97
窗口1卖出一张票,票号:97
窗口2卖出一张票,票号:97
窗口1卖出一张票,票号:94
窗口3卖出一张票,票号:94
窗口2卖出一张票,票号:94
窗口2卖出一张票,票号:91
窗口1卖出一张票,票号:91
窗口3卖出一张票,票号:91
窗口3卖出一张票,票号:88
窗口1卖出一张票,票号:88
窗口2卖出一张票,票号:88
窗口3卖出一张票,票号:85
窗口1卖出一张票,票号:85
窗口2卖出一张票,票号:85
窗口3卖出一张票,票号:82
窗口1卖出一张票,票号:82
窗口2卖出一张票,票号:82
窗口2卖出一张票,票号:79
窗口3卖出一张票,票号:79
窗口1卖出一张票,票号:79
窗口3卖出一张票,票号:76
窗口1卖出一张票,票号:76
窗口2卖出一张票,票号:76
窗口1卖出一张票,票号:73
窗口2卖出一张票,票号:73
窗口3卖出一张票,票号:73
窗口2卖出一张票,票号:70
窗口1卖出一张票,票号:70
窗口3卖出一张票,票号:70
窗口2卖出一张票,票号:67
窗口3卖出一张票,票号:67
窗口1卖出一张票,票号:67
窗口1卖出一张票,票号:64
窗口3卖出一张票,票号:64
窗口2卖出一张票,票号:64
窗口2卖出一张票,票号:61
窗口3卖出一张票,票号:61
窗口1卖出一张票,票号:61
窗口1卖出一张票,票号:58
窗口2卖出一张票,票号:58
窗口3卖出一张票,票号:58
窗口2卖出一张票,票号:55
窗口1卖出一张票,票号:55
窗口3卖出一张票,票号:55
窗口3卖出一张票,票号:52
窗口1卖出一张票,票号:52
窗口2卖出一张票,票号:52
窗口2卖出一张票,票号:49
窗口1卖出一张票,票号:49
窗口3卖出一张票,票号:49
窗口2卖出一张票,票号:46
窗口3卖出一张票,票号:46
窗口1卖出一张票,票号:46
窗口2卖出一张票,票号:43
窗口3卖出一张票,票号:43
窗口1卖出一张票,票号:43
窗口3卖出一张票,票号:40
窗口1卖出一张票,票号:40
窗口2卖出一张票,票号:40
窗口2卖出一张票,票号:37
窗口3卖出一张票,票号:37
窗口1卖出一张票,票号:37
窗口2卖出一张票,票号:34
窗口1卖出一张票,票号:34
窗口3卖出一张票,票号:34
窗口3卖出一张票,票号:31
窗口2卖出一张票,票号:31
窗口1卖出一张票,票号:31
窗口1卖出一张票,票号:28
窗口2卖出一张票,票号:28
窗口3卖出一张票,票号:28
窗口2卖出一张票,票号:25
窗口1卖出一张票,票号:25
窗口3卖出一张票,票号:25
窗口2卖出一张票,票号:22
窗口3卖出一张票,票号:22
窗口1卖出一张票,票号:22
窗口3卖出一张票,票号:19
窗口1卖出一张票,票号:19
窗口2卖出一张票,票号:19
窗口2卖出一张票,票号:16
窗口3卖出一张票,票号:16
窗口1卖出一张票,票号:16
窗口2卖出一张票,票号:13
窗口1卖出一张票,票号:13
窗口3卖出一张票,票号:13
窗口2卖出一张票,票号:10
窗口1卖出一张票,票号:10
窗口3卖出一张票,票号:10
窗口3卖出一张票,票号:7
窗口1卖出一张票,票号:7
窗口2卖出一张票,票号:7
窗口3卖出一张票,票号:4
窗口1卖出一张票,票号:4
窗口2卖出一张票,票号:4
窗口3卖出一张票,票号:1
窗口2卖出一张票,票号:1
窗口1卖出一张票,票号:1结果:发现卖出近100张票。
问题1:但是有重复票或负数票问题。
原因:线程安全问题
问题2:如果要考虑有两场电影,各卖100张票等
原因:TicketThread类的静态变量,是所有TicketThread类的对象共享
同一个对象的实例变量共享
示例代码:多个Thread线程使用同一个Runnable对象
class TicketSaleRunnable implements Runnable {
    private int ticket = 100;

    public void run() {
        while (ticket > 0) {
            try {
                Thread.sleep(10);//加入这个,使得问题暴露的更明显
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println(Thread.currentThread().getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        }
    }
}

public class SaleTicketDemo4 {
    public static void main(String[] args) {
        TicketSaleRunnable tr = new TicketSaleRunnable();
        Thread t1 = new Thread(tr, "窗口一");
        Thread t2 = new Thread(tr, "窗口二");
        Thread t3 = new Thread(tr, "窗口三");

        t1.start();
        t2.start();
        t3.start();
    }
}结果:发现卖出近100张票。
问题:但是有重复票或负数票问题。
原因:线程安全问题
抽取资源类,共享同一个资源对象
示例代码:
package com.atguigu.unsafe;

//1、编写资源类
class Ticket {
    private int ticket = 100;

    public void sale() {
        if (ticket > 0) {
            try {
                Thread.sleep(10);//加入这个,使得问题暴露的更明显
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
            System.out.println(Thread.currentThread().getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        } else {
            throw new RuntimeException("没有票了");
        }
    }

    public int getTicket() {
        return ticket;
    }
}

public class SaleTicketDemo5 {
    public static void main(String[] args) {
        //2、创建资源对象
        Ticket ticket = new Ticket();

        //3、启动多个线程操作资源类的对象
        Thread t1 = new Thread("窗口一") {
            public void run() {
                while (true) {
                    ticket.sale();
                }
            }
        };
        Thread t2 = new Thread("窗口二") {
            public void run() {
                while (true) {
                    ticket.sale();
                }
            }
        };
        Thread t3 = new Thread(new Runnable() {
            public void run() {
                ticket.sale();
            }
        }, "窗口三");


        t1.start();
        t2.start();
        t3.start();
    }
}结果:发现卖出近100张票。
问题:但是有重复票或负数票问题。
原因:线程安全问题
同步机制解决线程安全问题
要解决上述多线程并发访问一个资源的安全性问题:也就是解决重复票与不存在票问题,Java中提供了同步机制
(synchronized)来解决。
根据案例简述:
窗口1线程进入操作的时候,窗口2和窗口3线程只能在外等着,窗口1操作结束,窗口1和窗口2和窗口3才有机会进入代码去执行。也就是说在某个线程修改共享资源的时候,其他线程不能修改该资源,等待修改完毕同步之后,才能去抢夺CPU资源,完成对应的操作,保证了数据的同步性,解决了线程不安全的现象。
为了保证每个线程都能正常执行原子操作,Java引入了线程同步机制。
注意:在任何时候,最多允许一个线程拥有同步锁,谁拿到锁就进入代码块,其他的线程只能在外等着(BLOCKED)。
同步机制解决线程安全问题的原理
同步机制的原理,其实就相当于给某段代码加“锁”,任何线程想要执行这段代码,都要先获得“锁”,我们称它为同步锁。因为Java对象在堆中的数据分为分为对象头、实例变量、空白的填充。而对象头中包含:
-
Mark Word:记录了和当前对象有关的GC、锁标记等信息。
-
指向类的指针:每一个对象需要记录它是由哪个类创建出来的。
-
数组长度(只有数组对象才有)
哪个线程获得了“同步锁”对象之后,”同步锁“对象就会记录这个线程的ID,这样其他线程就只能等待了,除非这个线程”释放“了锁对象,其他线程才能重新获得/占用”同步锁“对象。
同步代码块和同步方法
同步代码块:synchronized 关键字可以用于某个区块前面,表示只对这个区块的资源实行互斥访问。 格式:
synchronized(同步锁){
     需要同步操作的代码
}同步方法:synchronized 关键字直接修饰方法,表示同一时刻只有一个线程能进入这个方法,其他线程在外面等着。
public synchronized void method(){
    可能会产生线程安全问题的代码
}同步锁机制
在《Thinking in Java》中,是这么说的:对于并发工作,你需要某种方式来防止两个任务访问相同的资源(其实就是共享资源竞争)。 防止这种冲突的方法就是当资源被一个任务使用时,在其上加锁。第一个访问某项资源的任务必须锁定这项资源,使其他任务在其被解锁之前,就无法访问它了,而在其被解锁之时,另一个任务就可以锁定并使用它了。
synchronized的锁是什么
同步锁对象可以是任意类型,但是必须保证竞争“同一个共享资源”的多个线程必须使用同一个“同步锁对象”。
对于同步代码块来说,同步锁对象是由程序员手动指定的(很多时候也是指定为this或类名.class),但是对于同步方法来说,同步锁对象只能是默认的:
-
静态方法:当前类的Class对象(类名.class)
-
非静态方法:this
同步操作的思考顺序
1、如何找问题,即代码是否存在线程安全?(非常重要)
(1)明确哪些代码是多线程运行的代码
(2)明确多个线程是否有共享数据
(3)明确多线程运行代码中是否有多条语句操作共享数据
2、如何解决呢?(非常重要)
对多条操作共享数据的语句,只能让一个线程都执行完,在执行过程中,其他线程不可以参与执行。
即所有操作共享数据的这些语句都要放在同步范围中
3、切记:
范围太小:不能解决安全问题
范围太大:因为一旦某个线程抢到锁,其他线程就只能等待,所以范围太大,效率会降低,不能合理利用CPU资源。
代码演示:
静态方法加锁:
package com.atguigu.safe;

class TicketSaleThread extends Thread{
    private static int ticket = 100;
    public void run(){//直接锁这里,肯定不行,会导致,只有一个窗口卖票
        while (ticket > 0) {
            saleOneTicket();
        }
    }

    public synchronized static void saleOneTicket(){//锁对象是TicketSaleThread类的Class对象,而一个类的Class对象在内存中肯定只有一个
        if(ticket > 0) {//不加条件,相当于条件判断没有进入锁管控,线程安全问题就没有解决
            System.out.println(Thread.currentThread().getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        }
    }
}
public class SaleTicketDemo3 {
    public static void main(String[] args) {
        TicketSaleThread t1 = new TicketSaleThread();
        TicketSaleThread t2 = new TicketSaleThread();
        TicketSaleThread t3 = new TicketSaleThread();

        t1.setName("窗口1");
        t2.setName("窗口2");
        t3.setName("窗口3");

        t1.start();
        t2.start();
        t3.start();
    }
}非静态方法加锁:
package com.atguigu.safe;


public class SaleTicketDemo4 {
    public static void main(String[] args) {
        TicketSaleRunnable tr = new TicketSaleRunnable();
        Thread t1 = new Thread(tr, "窗口一");
        Thread t2 = new Thread(tr, "窗口二");
        Thread t3 = new Thread(tr, "窗口三");

        t1.start();
        t2.start();
        t3.start();
    }
}

class TicketSaleRunnable implements Runnable {
    private int ticket = 100;

    public void run() {//直接锁这里,肯定不行,会导致,只有一个窗口卖票
        while (ticket > 0) {
            saleOneTicket();
        }
    }

    public synchronized void saleOneTicket() {//锁对象是this,这里就是TicketSaleRunnable对象,因为上面3个线程使用同一个TicketSaleRunnable对象,所以可以
        if (ticket > 0) {//不加条件,相当于条件判断没有进入锁管控,线程安全问题就没有解决
            System.out.println(Thread.currentThread().getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        }
    }
}同步代码块:
public class SaleTicketDemo5 {
    public static void main(String[] args) {
        //2、创建资源对象
        Ticket ticket = new Ticket();

        //3、启动多个线程操作资源类的对象
        Thread t1 = new Thread("窗口一") {
            public void run() {//不能给run()直接加锁,因为t1,t2,t3的三个run方法分别属于三个Thread类对象,
                // run方法是非静态方法,那么锁对象默认选this,那么锁对象根本不是同一个
                while (true) {
                    synchronized (ticket) {
                        ticket.sale();
                    }
                }
            }
        };
        Thread t2 = new Thread("窗口二") {
            public void run() {
                while (true) {
                    synchronized (ticket) {
                        ticket.sale();
                    }
                }
            }
        };
        Thread t3 = new Thread(new Runnable() {
            public void run() {
                while (true) {
                    synchronized (ticket) {
                        ticket.sale();
                    }
                }
            }
        }, "窗口三");


        t1.start();
        t2.start();
        t3.start();
    }
}

//1、编写资源类
class Ticket {
    private int ticket = 1000;

    public void sale() {//也可以直接给这个方法加锁,锁对象是this,这里就是Ticket对象
        if (ticket > 0) {
            System.out.println(Thread.currentThread().getName() + "卖出一张票,票号:" + ticket);
            ticket--;
        } else {
            throw new RuntimeException("没有票了");
        }
    }

    public int getTicket() {
        return ticket;
    }
}再谈同步
单例设计模式的线程安全问题
饿汉式没有线程安全问题
饿汉式:在类初始化时就直接创建单例对象,而类初始化过程是没有线程安全问题的
形式一:
package com.atguigu.single.hungry;

public class HungrySingle {
    private static HungrySingle INSTANCE = new HungrySingle(); //对象是否声明为final 都可以

    private HungrySingle(){}

    public static HungrySingle getInstance(){
        return INSTANCE;
    }
}形式二:
/*
public class HungryOne{
    public static final HungryOne INSTANCE = new HungryOne();
    private HungryOne(){}
}*/

public enum HungryOne{
    INSTANCE
}测试类:
public class HungrySingleTest {

    static HungrySingle hs1 = null;
    static HungrySingle hs2 = null;

    //演示存在的线程安全问题
    public static void main(String[] args) {

        Thread t1 = new Thread() {
            @Override
            public void run() {
                hs1 = HungrySingle.getInstance();
            }
        };

        Thread t2 = new Thread() {
            @Override
            public void run() {
                hs2 = HungrySingle.getInstance();
            }
        };

        t1.start();
        t2.start();

        try {
            t1.join();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        try {
            t2.join();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        System.out.println(hs1);
        System.out.println(hs2);
        System.out.println(hs1 == hs2);//true
    }

}懒汉式线程安全问题
懒汉式:延迟创建对象,第一次调用getInstance方法再创建对象
形式一:
package com.atguigu.single.lazy;

public class LazyOne {
    private static LazyOne instance;

    private LazyOne(){}

    //方式1:
    public static synchronized LazyOne getInstance1(){
        if(instance == null){
            instance = new LazyOne();
        }
        return instance;
    }
    //方式2:
    public static LazyOne getInstance2(){
        synchronized(LazyOne.class) {
            if (instance == null) {
                instance = new LazyOne();
            }
            return instance;
        }
    }
    //方式3:
    public static LazyOne getInstance3(){
        if(instance == null){
            synchronized (LazyOne.class) {
                try {
                    Thread.sleep(10);//加这个代码,暴露问题
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                if(instance == null){
                    instance = new LazyOne();
                }
            }
        }

        return instance;
    }
    /*
    注意:上述方式3中,有指令重排问题
    mem = allocate(); 为单例对象分配内存空间
    instance = mem;   instance引用现在非空,但还未初始化
    ctorSingleton(instance); 为单例对象通过instance调用构造器
    从JDK2开始,分配空间、初始化、调用构造器会在线程的工作存储区一次性完成,然后复制到主存储区。但是需要
    volatile关键字,避免指令重排。
    */

}形式二:使用内部类
package com.atguigu.single.lazy;

public class LazySingle {
    private LazySingle(){}

    public static LazySingle getInstance(){
        return Inner.INSTANCE;
    }

    private static class Inner{
        static final LazySingle INSTANCE = new LazySingle();
    }

}内部类只有在外部类被调用才加载,产生INSTANCE实例;又不用加锁。
此模式具有之前两个模式的优点,同时屏蔽了它们的缺点,是最好的单例模式。
此时的内部类,使用enum进行定义,也是可以的。
测试类:
package com.atguigu.single.lazy;

import org.junit.Test;

public class TestLazy {
    @Test
    public void test01(){
        LazyOne s1 = LazyOne.getInstance();
        LazyOne s2 = LazyOne.getInstance();

        System.out.println(s1);
        System.out.println(s2);
        System.out.println(s1 == s2);
    }

    //把s1和s2声明在外面,是想要在线程的匿名内部类中为s1和s2赋值
    LazyOne s1;
    LazyOne s2;
    @Test
    public void test02(){
        Thread t1 = new Thread(){
            public void run(){
                s1 = LazyOne.getInstance();
            }
        };
        Thread t2 = new Thread(){
            public void run(){
                s2 = LazyOne.getInstance();
            }
        };

        t1.start();
        t2.start();

        try {
            t1.join();
            t2.join();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        System.out.println(s1);
        System.out.println(s2);
        System.out.println(s1 == s2);
    }


    LazySingle obj1;
    LazySingle obj2;
    @Test
    public void test03(){
        Thread t1 = new Thread(){
            public void run(){
                obj1 = LazySingle.getInstance();
            }
        };
        Thread t2 = new Thread(){
            public void run(){
                obj2 = LazySingle.getInstance();
            }
        };

        t1.start();
        t2.start();

        try {
            t1.join();
            t2.join();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        System.out.println(obj1);
        System.out.println(obj2);
        System.out.println(obj1 == obj2);
    }
}死锁
不同的线程分别占用对方需要的同步资源不放弃,都在等待对方放弃自己需要的同步资源,就形成了线程的死锁。
一旦出现死锁,整个程序既不会发生异常,也不会给出任何提示,只是所有线程处于阻塞状态,无法继续。
举例:
public class DeadLockTest {
        public static void main(String[] args) {

                StringBuilder s1 = new StringBuilder();
                StringBuilder s2 = new StringBuilder();

                new Thread() {
                        public void run() {
                                synchronized (s1) {
                                        s1.append("a");
                                        s2.append("1");

                                        try {
                                                Thread.sleep(10);
                                        } catch (InterruptedException e) {
                                                e.printStackTrace();
                                        }

                                        synchronized (s2) {
                                                s1.append("b");
                                                s2.append("2");

                                                System.out.println(s1);
                                                System.out.println(s2);

                                        }
                                }
                        }
                }.start();

                new Thread() {
                        public void run() {
                                synchronized (s2) {
                                        s1.append("c");
                                        s2.append("3");

                                        try {
                                                Thread.sleep(10);
                                        } catch (InterruptedException e) {
                                                e.printStackTrace();
                                        }

                                        synchronized (s1) {
                                                s1.append("d");
                                                s2.append("4");

                                                System.out.println(s1);
                                                System.out.println(s2);

                                        }

                                }
                        }
                }.start();

        }
}诱发死锁的原因:
-
互斥条件
-
占用且等待
-
不可抢夺(或不可抢占)
-
循环等待
以上4个条件,同时出现就会触发死锁。
解决死锁:
死锁一旦出现,基本很难人为干预,只能尽量规避。可以考虑打破上面的诱发条件。
针对条件1:互斥条件基本上无法被破坏。因为线程需要通过互斥解决安全问题。
针对条件2:可以考虑一次性申请所有所需的资源,这样就不存在等待的问题。
针对条件3:占用部分资源的线程在进一步申请其他资源时,如果申请不到,就主动释放掉已经占用的资源。
针对条件4:可以将资源改为线性顺序。申请资源时,先申请序号较小的,这样避免循环等待问题。
JDK5.0新特性:Lock(锁)
-
JDK5.0的新增功能,保证线程的安全。与采用synchronized相比,Lock可提供多种锁方案,更灵活、更强大。Lock通过显式定义同步锁对象来实现同步。同步锁使用Lock对象充当。
-
java.util.concurrent.locks.Lock接口是控制多个线程对共享资源进行访问的工具。锁提供了对共享资源的独占访问,每次只能有一个线程对Lock对象加锁,线程开始访问共享资源之前应先获得Lock对象。
-
在实现线程安全的控制中,比较常用的是
ReentrantLock,可以显式加锁、释放锁。 -
ReentrantLock类实现了 Lock 接口,它拥有与 synchronized 相同的并发性和内存语义,但是添加了类似锁投票、定时锁等候和可中断锁等候的一些特性。此外,它还提供了在激烈争用情况下更佳的性能。
-
Lock锁也称同步锁,加锁与释放锁方法,如下:
-
public void lock() :加同步锁。
-
public void unlock() :释放同步锁。
代码结构:
class A{
    //1. 创建Lock的实例,必须确保多个线程共享同一个Lock实例
        private final ReentrantLock lock = new ReenTrantLock();
        public void m(){
        //2. 调动lock(),实现需共享的代码的锁定
                lock.lock();
                try{
                        //保证线程安全的代码;
                }
                finally{
            //3. 调用unlock(),释放共享代码的锁定
                        lock.unlock();
                }
        }
}注意:如果同步代码有异常,要将unlock()写入finally语句块。
举例:
import java.util.concurrent.locks.ReentrantLock;

class Window implements Runnable{
        int ticket = 100;
    //1. 创建Lock的实例,必须确保多个线程共享同一个Lock实例
        private final ReentrantLock lock = new ReentrantLock();
        public void run(){

                while(true){
                        try{
                //2. 调动lock(),实现需共享的代码的锁定
                                lock.lock();
                                if(ticket > 0){
                                        try {
                                                Thread.sleep(10);
                                        } catch (InterruptedException e) {
                                                e.printStackTrace();
                                        }
                                        System.out.println(ticket--);
                                }else{
                                        break;
                                }
                        }finally{
                //3. 调用unlock(),释放共享代码的锁定
                                lock.unlock();
                        }
                }
        }
}

public class ThreadLock {
        public static void main(String[] args) {
                Window t = new Window();
                Thread t1 = new Thread(t);
                Thread t2 = new Thread(t);

                t1.start();
                t2.start();
        }
}synchronized与Lock的对比
-
Lock是显式锁(手动开启和关闭锁,别忘记关闭锁),synchronized是隐式锁,出了作用域、遇到异常等自动解锁
-
Lock只有代码块锁,synchronized有代码块锁和方法锁
-
使用Lock锁,JVM将花费较少的时间来调度线程,性能更好。并且具有更好的扩展性(提供更多的子类),更体现面向对象。
-
(了解)Lock锁可以对读不加锁,对写加锁,synchronized不可以
-
(了解)Lock锁可以有多种获取锁的方式,可以从sleep的线程中抢到锁,synchronized不可以
说明:开发建议中处理线程安全问题优先使用顺序为:Lock ----> 同步代码块 ----> 同步方法
线程的通信
线程间通信
为什么要处理线程间通信:
当我们需要多个线程来共同完成一件任务,并且我们希望他们有规律的执行,那么多线程之间需要一些通信机制,可以协调它们的工作,以此实现多线程共同操作一份数据。
比如:线程A用来生产包子的,线程B用来吃包子的,包子可以理解为同一资源,线程A与线程B处理的动作,一个是生产,一个是消费,此时B线程必须等到A线程完成后才能执行,那么线程A与线程B之间就需要线程通信,即—— 等待唤醒机制。
等待唤醒机制
这是多个线程间的一种协作机制。谈到线程我们经常想到的是线程间的竞争(race),比如去争夺锁,但这并不是故事的全部,线程间也会有协作机制。
在一个线程满足某个条件时,就进入等待状态(wait() / wait(time)), 等待其他线程执行完他们的指定代码过后再将其唤醒(notify());或可以指定wait的时间,等时间到了自动唤醒;在有多个线程进行等待时,如果需要,可以使用 notifyAll()来唤醒所有的等待线程。wait/notify 就是线程间的一种协作机制。
-
wait:线程不再活动,不再参与调度,进入
wait set中,因此不会浪费 CPU 资源,也不会去竞争锁了,这时的线程状态是 WAITING 或 TIMED_WAITING。它还要等着别的线程执行一个特别的动作,也即“通知(notify)”或者等待时间到,在这个对象上等待的线程从wait set 中释放出来,重新进入到调度队列(ready queue)中 -
notify:则选取所通知对象的 wait set 中的一个线程释放;
-
notifyAll:则释放所通知对象的 wait set 上的全部线程。
注意:
被通知的线程被唤醒后也不一定能立即恢复执行,因为它当初中断的地方是在同步块内,而此刻它已经不持有锁,所以它需要再次尝试去获取锁(很可能面临其它线程的竞争),成功后才能在当初调用 wait 方法之后的地方恢复执行。
总结如下:
如果能获取锁,线程就从 WAITING 状态变成 RUNNABLE(可运行) 状态;
否则,线程就从 WAITING 状态又变成 BLOCKED(等待锁) 状态
举例:
例题:使用两个线程打印 1-100。线程1, 线程2 交替打印
class Communication implements Runnable {
    int i = 1;
    public void run() {
        while (true) {
            synchronized (this) {
                notify();
                if (i <= 100) {
                    System.out.println(Thread.currentThread().getName() + ":" + i++);
                } else
                    break;
                try {
                    wait();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        }
    }
}调用 wait和 notify需注意
-
wait方法与notify方法必须要由
同一个锁对象调用。因为:对应的锁对象可以通过notify唤醒使用同一个锁对象调用的wait方法后的线程。 -
wait方法与notify方法是属于Object类的方法的。因为:锁对象可以是任意对象,而任意对象的所属类都是继承了Object类的。
-
wait方法与notify方法必须要在
同步代码块或者是同步函数中使用。因为:必须要通过锁对象调用这2个方法。否则会报java.lang.IllegalMonitorStateException异常。
生产者与消费者问题
等待唤醒机制可以解决经典的“生产者与消费者”的问题。生产者与消费者问题(英语:Producer-consumer problem),也称有限缓冲问题(英语:Bounded-buffer problem),是一个多线程同步问题的经典案例。该问题描述了两个(多个)共享固定大小缓冲区的线程——即所谓的“生产者”和“消费者”——在实际运行时会发生的问题。
生产者的主要作用是生成一定量的数据放到缓冲区中,然后重复此过程。与此同时,消费者也在缓冲区消耗这些数据。该问题的关键就是要保证生产者不会在缓冲区满时加入数据,消费者也不会在缓冲区中空时消耗数据。
举例:
生产者(Productor)将产品交给店员(Clerk),而消费者(Customer)从店员处取走产品,店员一次只能持有固定数量的产品(比如:20),如果生产者试图生产更多的产品,店员会叫生产者停一下,如果店中有空位放产品了再通知生产者继续生产;如果店中没有产品了,店员会告诉消费者等一下,如果店中有产品了再通知消费者来取走产品。类似的场景,比如厨师和服务员等。
生产者与消费者问题中其实隐含了两个问题:
-
线程安全问题:因为生产者与消费者共享数据缓冲区,产生安全问题。不过这个问题可以使用同步解决。
-
线程的协调工作问题:
-
要解决该问题,就必须让生产者线程在缓冲区满时等待(wait),暂停进入阻塞状态,等到下次消费者消耗了缓冲区中的数据的时候,通知(notify)正在等待的线程恢复到就绪状态,重新开始往缓冲区添加数据。同样,也可以让消费者线程在缓冲区空时进入等待(wait),暂停进入阻塞状态,等到生产者往缓冲区添加数据之后,再通知(notify)正在等待的线程恢复到就绪状态。通过这样的通信机制来解决此类问题。
代码实现:
public class ConsumerProducerTest {
        public static void main(String[] args) {
                Clerk clerk = new Clerk();
                Producer p1 = new Producer(clerk);

                Consumer c1 = new Consumer(clerk);
                Consumer c2 = new Consumer(clerk);

                p1.setName("生产者1");
                c1.setName("消费者1");
                c2.setName("消费者2");

                p1.start();
                c1.start();
                c2.start();
        }
}

//生产者
class Producer extends Thread{
        private Clerk clerk;

        public Producer(Clerk clerk){
                this.clerk = clerk;
        }

        @Override
        public void run() {

                System.out.println("=========生产者开始生产产品========");
                while(true){

                        try {
                                Thread.sleep(40);
                        } catch (InterruptedException e) {
                                e.printStackTrace();
                        }

                        //要求clerk去增加产品
                        clerk.addProduct();
                }
        }
}

//消费者
class Consumer extends Thread{
        private Clerk clerk;

        public Consumer(Clerk clerk){
                this.clerk = clerk;
        }
        @Override
        public void run() {
                System.out.println("=========消费者开始消费产品========");
                while(true){

                        try {
                                Thread.sleep(90);
                        } catch (InterruptedException e) {
                                e.printStackTrace();
                        }

                        //要求clerk去减少产品
                        clerk.minusProduct();
                }
        }
}

//资源类
class Clerk {
        private int productNum = 0;//产品数量
        private static final int MAX_PRODUCT = 20;
        private static final int MIN_PRODUCT = 1;

        //增加产品
        public synchronized void addProduct() {
                if(productNum < MAX_PRODUCT){
                        productNum++;
                        System.out.println(Thread.currentThread().getName() +
                                        "生产了第" + productNum + "个产品");
                        //唤醒消费者
                        this.notifyAll();
                }else{

                        try {
                                this.wait();
                        } catch (InterruptedException e) {
                                e.printStackTrace();
                        }
                }
        }

        //减少产品
        public synchronized void minusProduct() {
                if(productNum >= MIN_PRODUCT){
                        System.out.println(Thread.currentThread().getName() +
                                        "消费了第" + productNum + "个产品");
                        productNum--;

                        //唤醒生产者
                        this.notifyAll();
                }else{

                        try {
                                this.wait();
                        } catch (InterruptedException e) {
                                e.printStackTrace();
                        }
                }
        }

}区分 sleep 和 wait
相同点:一旦执行,都会使得当前线程结束执行状态,进入阻塞状态。
不同点:
-
定义方法所属的类:sleep():Thread中定义。 wait():Object中定义
-
使用范围的不同:sleep()可以在任何需要使用的位置被调用; wait():必须使用在同步代码块或同步方法中
-
都在同步结构中使用的时候,是否释放同步监视器的操作不同:sleep():不会释放同步监视器 ;wait():会释放同步监视器
-
结束等待的方式不同:sleep():指定时间一到就结束阻塞。 wait():可以指定时间也可以无限等待直到notify或notifyAll。
是否释放锁的操作
任何线程进入同步代码块、同步方法之前,必须先获得对同步监视器的锁定,那么何时会释放对同步监视器的锁定呢?
释放锁的操作:
当前线程的同步方法、同步代码块执行结束。
当前线程在同步代码块、同步方法中遇到break、return终止了该代码块、该方法的继续执行。
当前线程在同步代码块、同步方法中出现了未处理的Error或Exception,导致当前线程异常结束。
当前线程在同步代码块、同步方法中执行了锁对象的wait()方法,当前线程被挂起,并释放锁。
不会释放锁的操作:
线程执行同步代码块或同步方法时,程序调用Thread.sleep()、Thread.yield()方法暂停当前线程的执行。
线程执行同步代码块时,其他线程调用了该线程的suspend()方法将该该线程挂起,该线程不会释放锁(同步监视器)。
应尽量避免使用suspend()和resume()这样的过时来控制线程。
JDK5.0新增线程创建方式
实现 Callable 接口
与使用Runnable相比, Callable功能更强大些
-
相比run()方法,可以有返回值
-
方法可以抛出异常
-
支持泛型的返回值(需要借助FutureTask类,获取返回结果)
Future接口(了解)
-
可以对具体Runnable、Callable任务的执行结果进行取消、查询是否完成、获取结果等。
-
FutureTask是Futrue接口的唯一的实现类
-
FutureTask 同时实现了Runnable, Future接口。它既可以作为Runnable被线程执行,又可以作为Future得到Callable的返回值
缺点:在获取分线程执行结果的时候,当前线程(或是主线程)受阻塞,效率较低。
代码举例
/*
 * 创建多线程的方式三:实现Callable (jdk5.0新增的)
 */
//1.创建一个实现Callable的实现类
class NumThread implements Callable {
    //2.实现call方法,将此线程需要执行的操作声明在call()中
    @Override
    public Object call() throws Exception {
        int sum = 0;
        for (int i = 1; i <= 100; i++) {
            if (i % 2 == 0) {
                System.out.println(i);
                sum += i;
            }
        }
        return sum;
    }
}


public class CallableTest {
    public static void main(String[] args) {
        //3.创建Callable接口实现类的对象
        NumThread numThread = new NumThread();

        //4.将此Callable接口实现类的对象作为传递到FutureTask构造器中,创建FutureTask的对象
        FutureTask futureTask = new FutureTask(numThread);
        //5.将FutureTask的对象作为参数传递到Thread类的构造器中,创建Thread对象,并调用start()
        new Thread(futureTask).start();


//      接收返回值
        try {
            //6.获取Callable中call方法的返回值
            //get()返回值即为FutureTask构造器参数Callable实现类重写的call()的返回值。
            Object sum = futureTask.get();
            System.out.println("总和为:" + sum);
        } catch (InterruptedException e) {
            e.printStackTrace();
        } catch (ExecutionException e) {
            e.printStackTrace();
        }
    }

}使用线程池
现有问题:
如果并发的线程数量很多,并且每个线程都是执行一个时间很短的任务就结束了,这样频繁创建线程就会大大降低系统的效率,因为频繁创建线程和销毁线程需要时间。
那么有没有一种办法使得线程可以复用,即执行完一个任务,并不被销毁,而是可以继续执行其他的任务?
**思路:**提前创建好多个线程,放入线程池中,使用时直接获取,使用完放回池中。可以避免频繁创建销毁、实现重复利用。类似生活中的公共交通工具。
好处:
-
提高响应速度(减少了创建新线程的时间)
-
降低资源消耗(重复利用线程池中线程,不需要每次都创建)
-
便于线程管理
-
corePoolSize:核心池的大小
-
maximumPoolSize:最大线程数
-
keepAliveTime:线程没有任务时最多保持多长时间后会终止
-
…
线程池相关API
-
JDK5.0之前,我们必须手动自定义线程池。从JDK5.0开始,Java内置线程池相关的API。在java.util.concurrent包下提供了线程池相关API:
ExecutorService和Executors。 -
ExecutorService:真正的线程池接口。常见子类ThreadPoolExecutor -
void execute(Runnable command):执行任务/命令,没有返回值,一般用来执行Runnable -
<T> Future<T> submit(Callable<T> task):执行任务,有返回值,一般又来执行Callable -
void shutdown():关闭连接池 -
Executors:一个线程池的工厂类,通过此类的静态工厂方法可以创建多种类型的线程池对象。 -
Executors.newCachedThreadPool():创建一个可根据需要创建新线程的线程池 -
Executors.newFixedThreadPool(int nThreads); 创建一个可重用固定线程数的线程池 -
Executors.newSingleThreadExecutor():创建一个只有一个线程的线程池 -
Executors.newScheduledThreadPool(int corePoolSize):创建一个线程池,它可安排在给定延迟后运行命令或者定期地执行。
代码示例:
class NumberThread implements Runnable{

    @Override
    public void run() {
        for(int i = 0;i <= 100;i++){
            if(i % 2 == 0){
                System.out.println(Thread.currentThread().getName() + ": " + i);
            }
        }
    }
}

class NumberThread1 implements Runnable{

    @Override
    public void run() {
        for(int i = 0;i <= 100;i++){
            if(i % 2 != 0){
                System.out.println(Thread.currentThread().getName() + ": " + i);
            }
        }
    }
}

class NumberThread2 implements Callable {
    @Override
    public Object call() throws Exception {
        int evenSum = 0;//记录偶数的和
        for(int i = 0;i <= 100;i++){
            if(i % 2 == 0){
                evenSum += i;
            }
        }
        return evenSum;
    }

}

public class ThreadPoolTest {

    public static void main(String[] args) {
        //1. 提供指定线程数量的线程池
        ExecutorService service = Executors.newFixedThreadPool(10);
        ThreadPoolExecutor service1 = (ThreadPoolExecutor) service;
//        //设置线程池的属性
//        System.out.println(service.getClass());//ThreadPoolExecutor
        service1.setMaximumPoolSize(50); //设置线程池中线程数的上限

        //2.执行指定的线程的操作。需要提供实现Runnable接口或Callable接口实现类的对象
        service.execute(new NumberThread());//适合适用于Runnable
        service.execute(new NumberThread1());//适合适用于Runnable

        try {
            Future future = service.submit(new NumberThread2());//适合使用于Callable
            System.out.println("总和为:" + future.get());
        } catch (Exception e) {
            e.printStackTrace();
        }
        //3.关闭连接池
        service.shutdown();
    }

}常用类和API
String
特性
-
java.lang.String类代表字符串。Java程序中所有的字符串文字(例如"hello")都可以看作是实现此类的实例。 -
字符串是常量,用双引号引起来表示。它们的值在创建之后不能更改。
String s1 = "hello";
String s2 = "hello";
System.out.println(s1 == s2);
// 内存中只有一个"hello"对象被创建,同时被s1和s2共享。对应内存结构为:(以下内存结构以JDK6为例绘制):
-
字符串String类型本身是final声明的,意味着我们不能继承String。
-
String对象的字符内容是存储在一个字符数组value[]中的。
"abc"等效于char[] data={'h','e','l','l','o'}。 -
private意味着外面无法直接获取字符数组,而且String没有提供value的get和set方法。
-
final意味着字符数组的引用不可改变,而且String也没有提供方法来修改value数组某个元素值
-
因此字符串的字符数组内容也不可变的,即String代表着不可变的字符序列。即,一旦对字符串进行修改,就会产生新对象。
-
JDK9只有,底层使用byte[]数组。
-
Java 语言提供对字符串串联符号("+")以及将其他对象转换为字符串的特殊支持(toString()方法)。
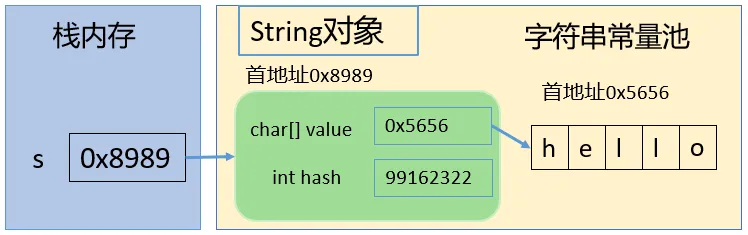
内存结构
因为字符串对象设计为不可变,那么所以字符串有常量池来保存很多常量对象。
JDK6中,字符串常量池在方法区。 JDK7开始,就移到堆空间,直到目前JDK17版本。
举例内存结构分配:
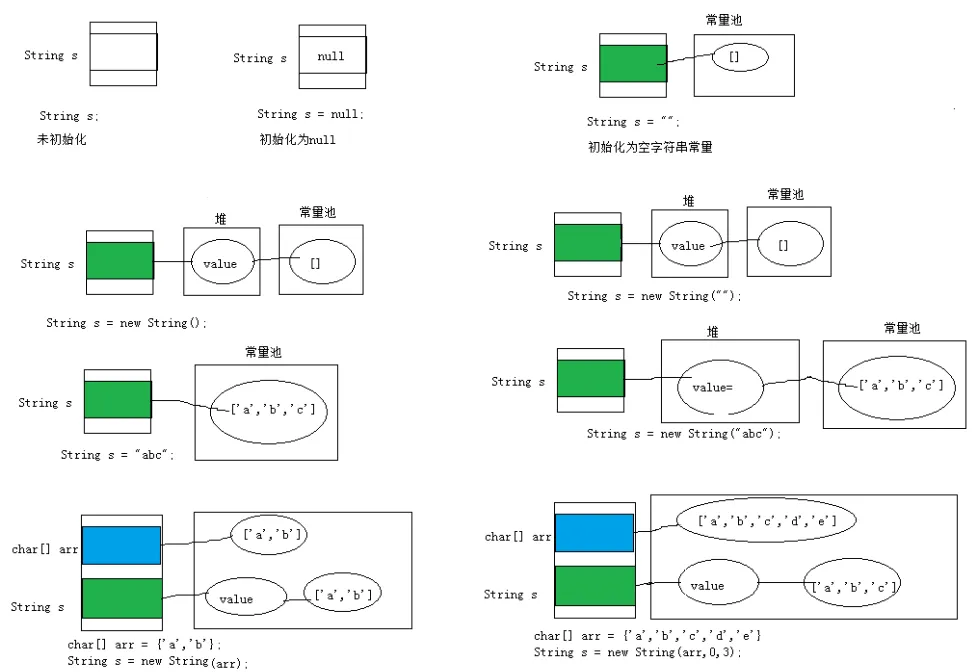
结论:
常量+常量:结果是常量池。且常量池中不会存在相同内容的常量。
常量与变量 或 变量与变量:结果在堆中
拼接后调用intern方法:返回值在常量池中
拼接
String s1 = "hello";
String s2 = "hello";
System.out.println(s1 == s2);
// 内存中只有一个"hello"对象被创建,同时被s1和s2共享。对应内存结构为:(以下内存结构以JDK6为例绘制):
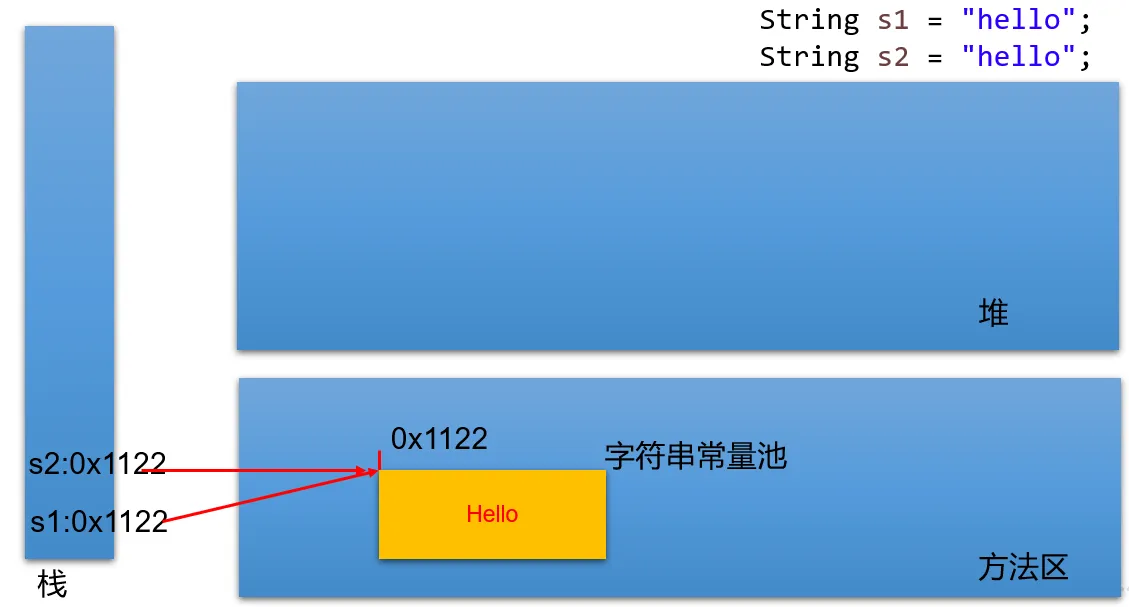
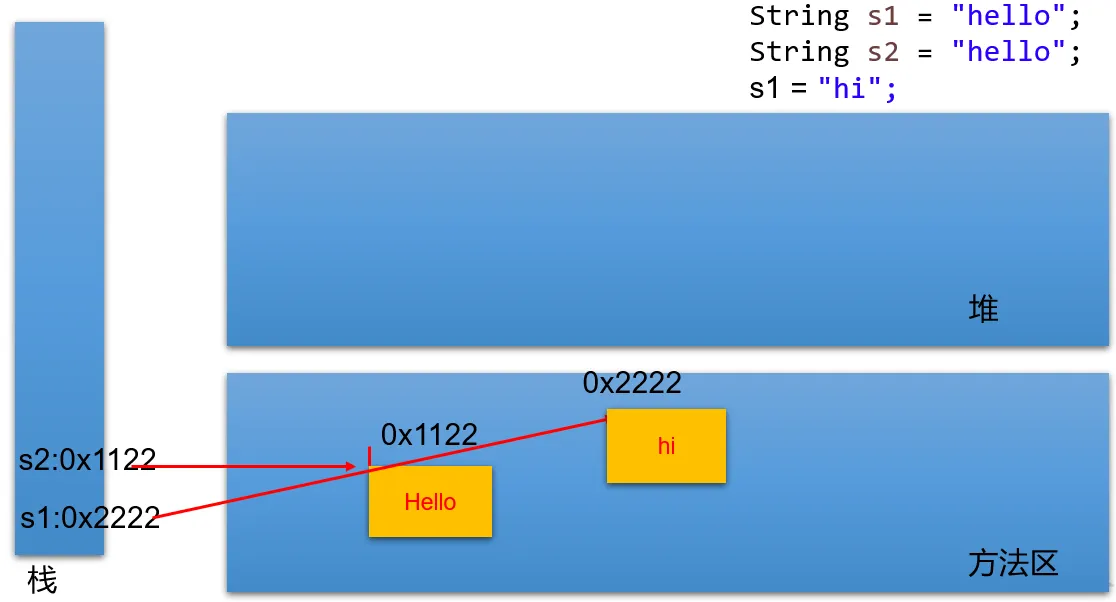
Person p1 = new Person();
p1.name = “Tom";

Person p2 = new Person();
p2.name = “Tom";

System.out.println(p1.name.equals( p2.name)); //
System.out.println(p1.name == p2.name); //
System.out.println(p1.name == "Tom"); //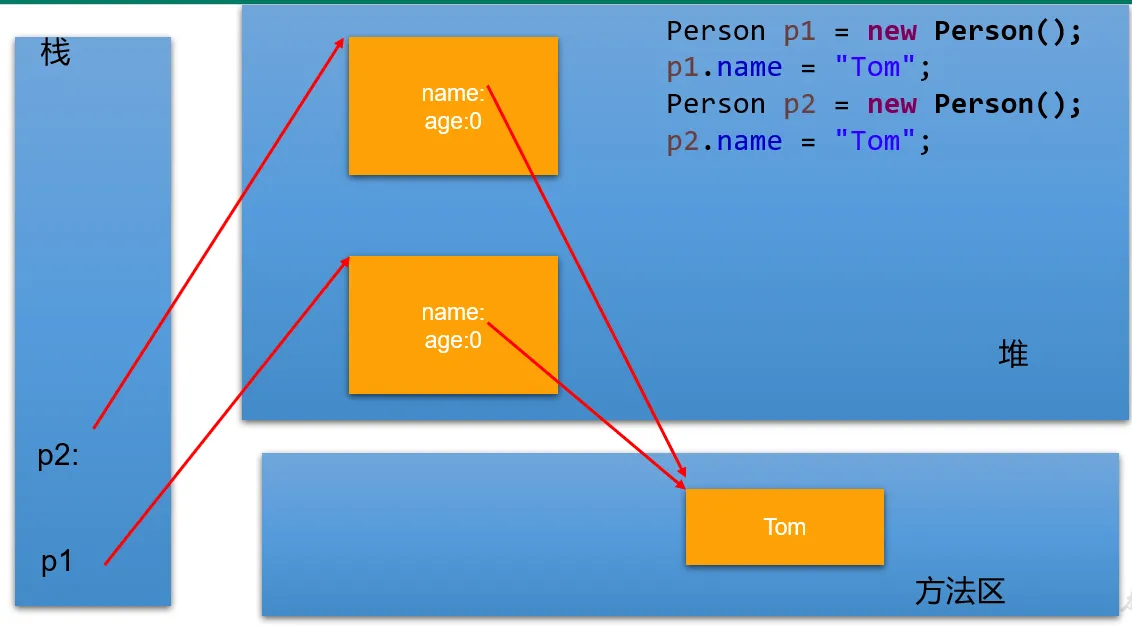
new
String str1 = “abc”; 与 String str2 = new String(“abc”);的区别?
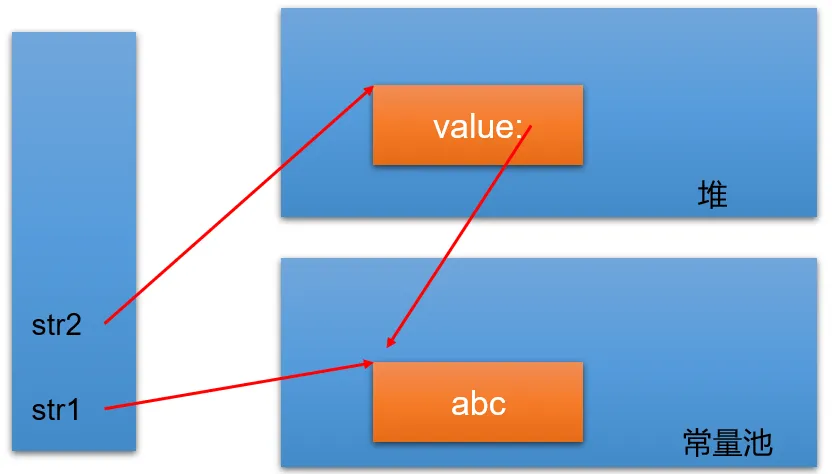
str2 首先指向堆中的一个字符串对象,然后堆中字符串的value数组指向常量池中常量对象的value数组。
-
字符串常量存储在字符串常量池,目的是共享。
-
字符串非常量对象存储在堆中。
intern()
-
String s1 = "a";说明:在字符串常量池中创建了一个字面量为"a"的字符串。 -
s1 = s1 + "b";说明:实际上原来的“a”字符串对象已经丢弃了,现在在堆空间中产生了一个字符串s1+"b"(也就是"ab")。如果多次执行这些改变串内容的操作,会导致大量副本字符串对象存留在内存中,降低效率。如果这样的操作放到循环中,会极大影响程序的性能。 -
String s2 = "ab";说明:直接在字符串常量池中创建一个字面量为"ab"的字符串。 -
String s3 = "a" + "b";说明:s3指向字符串常量池中已经创建的"ab"的字符串。 -
String s4 = s1.intern();说明:堆空间的s1对象在调用intern()之后,会将常量池中已经存在的"ab"字符串赋值给s4。
String s1 = "hello";
String s2 = "world";
String s3 = "hello" + "world";
String s4 = s1 + "world";
String s5 = s1 + s2;
String s6 = (s1 + s2).intern();

System.out.println(s3 == s4);
System.out.println(s3 == s5);
System.out.println(s4 == s5);
System.out.println(s3 == s6);结论:
常量+常量:结果是常量池。且常量池中不会存在相同内容的常量。
常量与变量 或 变量与变量:结果在堆中
拼接后调用intern方法:返回值在常量池中
常用 API
构造器:
-
public String():初始化新创建的 String对象,以使其表示空字符序列。 -
String(String original): 初始化一个新创建的String对象,使其表示一个与参数相同的字符序列;换句话说,新创建的字符串是该参数字符串的副本。 -
public String(char[] value):通过当前参数中的字符数组来构造新的String。 -
public String(char[] value,int offset, int count):通过字符数组的一部分来构造新的String。 -
public String(byte[] bytes):通过使用平台的默认字符集解码当前参数中的字节数组来构造新的String。 -
public String(byte[] bytes,String charsetName):通过使用指定的字符集解码当前参数中的字节数组来构造新的String。
举例:
//字面量定义方式:字符串常量对象
String str = "hello";

//构造器定义方式:无参构造
String str1 = new String();

//构造器定义方式:创建"hello"字符串常量的副本
String str2 = new String("hello");

//构造器定义方式:通过字符数组构造
char chars[] = {'a', 'b', 'c','d','e'};
String str3 = new String(chars);
String str4 = new String(chars,0,3);

//构造器定义方式:通过字节数组构造
byte bytes[] = {97, 98, 99 };
String str5 = new String(bytes);
String str6 = new String(bytes,"GBK");public static void main(String[] args) {
char[] data = {'h','e','l','l','o','j','a','v','a'};
String s1 = String.copyValueOf(data);
String s2 = String.copyValueOf(data,0,5);
int num = 123456;
String s3 = String.valueOf(num);
System.out.println(s1);
System.out.println(s2);
System.out.println(s3);
}String与其他类型间的转换
字符串 --> 基本数据类型、包装类:
-
Integer包装类的public static int parseInt(String s):可以将由“数字”字符组成的字符串转换为整型。
-
类似地,使用java.lang包中的Byte、Short、Long、Float、Double类调相应的类方法可以将由“数字”字符组成的字符串,转化为相应的基本数据类型。
基本数据类型、包装类 --> 字符串:
-
调用String类的public String valueOf(int n)可将int型转换为字符串
-
相应的valueOf(byte b)、valueOf(long l)、valueOf(float f)、valueOf(double d)、valueOf(boolean b)可由参数的相应类型到字符串的转换。
字符数组 --> 字符串:
- String 类的构造器:String(char[]) 和 String(char[],int offset,int length) 分别用字符数组中的全部字符和部分字符创建字符串对象。
字符串 --> 字符数组:
-
public char[] toCharArray():将字符串中的全部字符存放在一个字符数组中的方法。
-
public void getChars(int srcBegin, int srcEnd, char[] dst, int dstBegin):提供了将指定索引范围内的字符串存放到数组中的方法。
字符串 --> 字节数组:(编码)
-
public byte[] getBytes() :使用平台的默认字符集将此 String 编码为 byte 序列,并将结果存储到一个新的 byte 数组中。
-
public byte[] getBytes(String charsetName) :使用指定的字符集将此 String 编码到 byte 序列,并将结果存储到新的 byte 数组。
字节数组 --> 字符串:(解码)
-
String(byte[]):通过使用平台的默认字符集解码指定的 byte 数组,构造一个新的 String。
-
String(byte[],int offset,int length) :用指定的字节数组的一部分,即从数组起始位置offset开始取length个字节构造一个字符串对象。
-
String(byte[], String charsetName ) 或 new String(byte[], int, int,String charsetName ):解码,按照指定的编码方式进行解码。
代码示例:
@Test
public void test01() throws Exception {
    String str = "中国";
    System.out.println(str.getBytes("ISO8859-1").length);// 2
    // ISO8859-1把所有的字符都当做一个byte处理,处理不了多个字节
    System.out.println(str.getBytes("GBK").length);// 4 每一个中文都是对应2个字节
    System.out.println(str.getBytes("UTF-8").length);// 6 常规的中文都是3个字节

    /*
     * 不乱码:(1)保证编码与解码的字符集名称一样(2)不缺字节
     */
    System.out.println(new String(str.getBytes("ISO8859-1"), "ISO8859-1"));// 乱码
    System.out.println(new String(str.getBytes("GBK"), "GBK"));// 中国
    System.out.println(new String(str.getBytes("UTF-8"), "UTF-8"));// 中国
}常见方法
-
boolean isEmpty():字符串是否为空
-
int length():返回字符串的长度
-
String concat(xx):拼接
-
boolean equals(Object obj):比较字符串是否相等,区分大小写
-
boolean equalsIgnoreCase(Object obj):比较字符串是否相等,不区分大小写
-
int compareTo(String other):比较字符串大小,区分大小写,按照Unicode编码值比较大小
-
int compareToIgnoreCase(String other):比较字符串大小,不区分大小写
-
String toLowerCase():将字符串中大写字母转为小写
-
String toUpperCase():将字符串中小写字母转为大写
-
String trim():去掉字符串前后空白符
-
public String intern():结果在常量池中共享
        @Test
        public void test01(){
                //将用户输入的单词全部转为小写,如果用户没有输入单词,重新输入
                Scanner input = new Scanner(System.in);
                String word;
                while(true){
                        System.out.print("请输入单词:");
                        word = input.nextLine();
                        if(word.trim().length()!=0){
                                word = word.toLowerCase();
                                break;
                        }
                }
                System.out.println(word);
        }

        @Test
        public void test02(){
        //随机生成验证码,验证码由0-9,A-Z,a-z的字符组成
                char[] array = new char[26*2+10];
                for (int i = 0; i < 10; i++) {
                        array[i] = (char)('0' + i);
                }
                for (int i = 10,j=0; i < 10+26; i++,j++) {
                        array[i] = (char)('A' + j);
                }
                for (int i = 10+26,j=0; i < array.length; i++,j++) {
                        array[i] = (char)('a' + j);
                }
                String code = "";
                Random rand = new Random();
                for (int i = 0; i < 4; i++) {
                        code += array[rand.nextInt(array.length)];
                }
                System.out.println("验证码:" + code);
                //将用户输入的单词全部转为小写,如果用户没有输入单词,重新输入
                Scanner input = new Scanner(System.in);
                System.out.print("请输入验证码:");
                String inputCode = input.nextLine();

                if(!code.equalsIgnoreCase(inputCode)){
                        System.out.println("验证码输入不正确");
                }
}查找
-
boolean contains(xx):是否包含xx
-
int indexOf(xx):从前往后找当前字符串中xx,即如果有返回第一次出现的下标,要是没有返回-1
-
int indexOf(String str, int fromIndex):返回指定子字符串在此字符串中第一次出现处的索引,从指定的索引开始
-
int lastIndexOf(xx):从后往前找当前字符串中xx,即如果有返回最后一次出现的下标,要是没有返回-1
-
int lastIndexOf(String str, int fromIndex):返回指定子字符串在此字符串中最后一次出现处的索引,从指定的索引开始反向搜索。
字符串截取
-
String substring(int beginIndex) :返回一个新的字符串,它是此字符串的从beginIndex开始截取到最后的一个子字符串。
-
String substring(int beginIndex, int endIndex) :返回一个新字符串,它是此字符串从beginIndex开始截取到endIndex(不包含)的一个子字符串。
@Test
public void test01(){
    String str = "helloworldjavaatguigu";
    String sub1 = str.substring(5);
    String sub2 = str.substring(5,10);
    System.out.println(sub1);
    System.out.println(sub2);
}

@Test
public void test02(){
    String fileName = "快速学习Java的秘诀.dat";
    //截取文件名
    System.out.println("文件名:" + fileName.substring(0,fileName.lastIndexOf(".")));
    //截取后缀名
    System.out.println("后缀名:" + fileName.substring(fileName.lastIndexOf(".")));
}和字符/字符数组相关
-
char charAt(index):返回[index]位置的字符
-
char[] toCharArray(): 将此字符串转换为一个新的字符数组返回
-
static String valueOf(char[] data) :返回指定数组中表示该字符序列的 String
-
static String valueOf(char[] data, int offset, int count) : 返回指定数组中表示该字符序列的 String
-
static String copyValueOf(char[] data): 返回指定数组中表示该字符序列的 String
-
static String copyValueOf(char[] data, int offset, int count):返回指定数组中表示该字符序列的 String
        @Test
        public void test01(){
                //将字符串中的字符按照大小顺序排列
                String str = "helloworldjavaatguigu";
                char[] array = str.toCharArray();
                Arrays.sort(array);
                str = new String(array);
                System.out.println(str);
        }

        @Test
        public void test02(){
                //将首字母转为大写
                String str = "jack";
                str = Character.toUpperCase(str.charAt(0))+str.substring(1);
                System.out.println(str);
        }
        @Test
        public void test03(){
                char[] data = {'h','e','l','l','o','j','a','v','a'};
                String s1 = String.copyValueOf(data);
                String s2 = String.copyValueOf(data,0,5);
                int num = 123456;
                String s3 = String.valueOf(num);

            System.out.println(s1);
                System.out.println(s2);
                System.out.println(s3);
}开头与结尾
-
boolean startsWith(xx):测试此字符串是否以指定的前缀开始
-
boolean startsWith(String prefix, int toffset):测试此字符串从指定索引开始的子字符串是否以指定前缀开始
-
boolean endsWith(xx):测试此字符串是否以指定的后缀结束
@Test
public void test1(){
    String name = "张三";
    System.out.println(name.startsWith("张"));
}

@Test
public void test2(){
    String file = "Hello.txt";
    if(file.endsWith(".java")){
        System.out.println("Java源文件");
    }else if(file.endsWith(".class")){
        System.out.println("Java字节码文件");
    }else{
        System.out.println("其他文件");
    }
}替换
-
String replace(char oldChar, char newChar):返回一个新的字符串,它是通过用 newChar 替换此字符串中出现的所有 oldChar 得到的。 不支持正则。
-
String replace(CharSequence target, CharSequence replacement):使用指定的字面值替换序列替换此字符串所有匹配字面值目标序列的子字符串。
-
String replaceAll(String regex, String replacement):使用给定的 replacement 替换此字符串所有匹配给定的正则表达式的子字符串。
-
String replaceFirst(String regex, String replacement):使用给定的 replacement 替换此字符串匹配给定的正则表达式的第一个子字符串。
@Test
public void test1(){
    String str1 = "hello244world.java;887";
    //把其中的非字母去掉
    str1 = str1.replaceAll("[^a-zA-Z]", "");
    System.out.println(str1);

    String str2 = "12hello34world5java7891mysql456";
    //把字符串中的数字替换成,,如果结果中开头和结尾有,的话去掉
    String string = str2.replaceAll("\\d+", ",").replaceAll("^,|,$", "");
    System.out.println(string);

}StringBuffer 和StringBuilder的理解
java.lang.StringBuffer代表可变的字符序列,JDK1.0中声明,可以对字符串内容进行增删,此时不会产生新的对象。比如:
//情况1:
String s = new String("我喜欢学习");
//情况2:
StringBuffer buffer = new StringBuffer("我喜欢学习");
buffer.append("数学");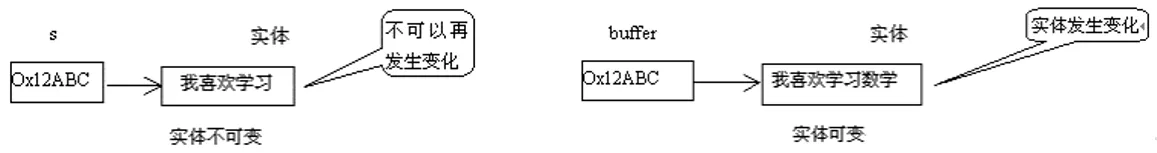
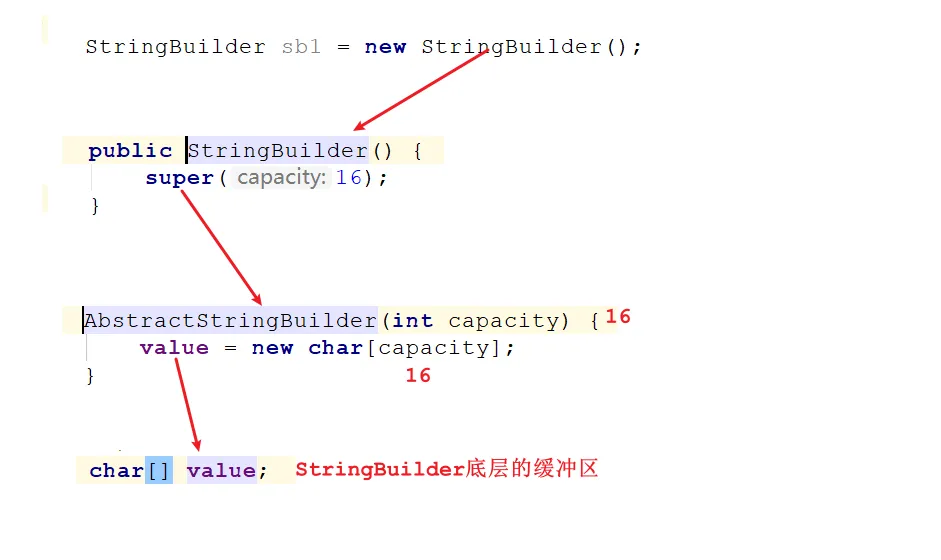
继承结构:
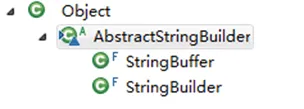
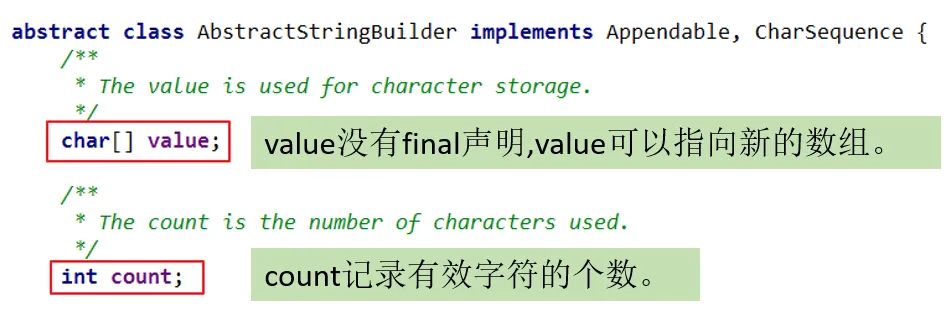
-
StringBuilder 和 StringBuffer 非常类似,均代表可变的字符序列,而且提供相关功能的方法也一样。
-
区分String、StringBuffer、StringBuilder
-
String:不可变的字符序列; 底层使用char[]数组存储(JDK8.0中)
-
StringBuffer:可变的字符序列;线程安全(方法有synchronized修饰),效率低;底层使用char[]数组存储 (JDK8.0中)
-
StringBuilder:可变的字符序列; jdk1.5引入,线程不安全的,效率高;底层使用char[]数组存储(JDK8.0中)
API
StringBuilder、StringBuffer的API是完全一致的,并且很多方法与String相同。
常用API
-
StringBuffer append(xx):提供了很多的append()方法,用于进行字符串追加的方式拼接
-
StringBuffer delete(int start, int end):删除[start,end)之间字符
-
StringBuffer deleteCharAt(int index):删除[index]位置字符
-
StringBuffer replace(int start, int end, String str):替换[start,end)范围的字符序列为str
-
void setCharAt(int index, char c):替换[index]位置字符
-
char charAt(int index):查找指定index位置上的字符
-
StringBuffer insert(int index, xx):在[index]位置插入xx
-
int length():返回存储的字符数据的长度
-
StringBuffer reverse():反转
2、其它API
-
int indexOf(String str):在当前字符序列中查询str的第一次出现下标
-
int indexOf(String str, int fromIndex):在当前字符序列[fromIndex,最后]中查询str的第一次出现下标
-
int lastIndexOf(String str):在当前字符序列中查询str的最后一次出现下标
-
int lastIndexOf(String str, int fromIndex):在当前字符序列[fromIndex,最后]中查询str的最后一次出现下标
-
String substring(int start):截取当前字符序列[start,最后]
-
String substring(int start, int end):截取当前字符序列[start,end)
-
String toString():返回此序列中数据的字符串表示形式
-
void setLength(int newLength) :设置当前字符序列长度为newLength
@Test
public void test1(){
    StringBuilder s = new StringBuilder();
    s.append("hello").append(true).append('a').append(12).append("atguigu");
    System.out.println(s);
    System.out.println(s.length());
}

@Test
public void test2(){
    StringBuilder s = new StringBuilder("helloworld");
    s.insert(5, "java");
    s.insert(5, "chailinyan");
    System.out.println(s);
}

@Test
public void test3(){
    StringBuilder s = new StringBuilder("helloworld");
    s.delete(1, 3);
    s.deleteCharAt(4);
    System.out.println(s);
}
@Test
public void test4(){
    StringBuilder s = new StringBuilder("helloworld");
    s.reverse();
    System.out.println(s);
}

@Test
public void test5(){
    StringBuilder s = new StringBuilder("helloworld");
    s.setCharAt(2, 'a');
    System.out.println(s);
}

@Test
public void test6(){
    StringBuilder s = new StringBuilder("helloworld");
    s.setLength(30);
    System.out.println(s);
}JDK8之前:日期 API
java.lang.System 类的方法
-
System类提供的public static long currentTimeMillis():用来返回当前时间与1970年1月1日0时0分0秒之间以毫秒为单位的时间差。
-
此方法适于计算时间差。
-
计算世界时间的主要标准有:
-
UTC(Coordinated Universal Time)
-
GMT(Greenwich Mean Time)
-
CST(Central Standard Time)
java.util.Date
表示特定的瞬间,精确到毫秒。
构造器:
-
Date():使用无参构造器创建的对象可以获取本地当前时间。
-
Date(long 毫秒数):把该毫秒值换算成日期时间对象
常用方法
-
getTime(): 返回自 1970 年 1 月 1 日 00:00:00 GMT 以来此 Date 对象表示的毫秒数。
-
toString(): 把此 Date 对象转换为以下形式的 String: dow mon dd hh:mm:ss zzz yyyy 其中: dow 是一周中的某一天 (Sun, Mon, Tue, Wed, Thu, Fri, Sat),zzz是时间标准。
-
其它很多方法都过时了。
举例:
@Test
public void test1(){
    Date d = new Date();
    System.out.println(d);
}

@Test
public void test2(){
    long time = System.currentTimeMillis();
    System.out.println(time);//1559806982971
    //当前系统时间距离1970-1-1 0:0:0 0毫秒的时间差,毫秒为单位
}

@Test
public void test3(){
    Date d = new Date();
    long time = d.getTime();
    System.out.println(time);//1559807047979
}

@Test
public void test4(){
    long time = 1559807047979L;
    Date d = new Date(time);
    System.out.println(d);
}

@Test
public void test5(){
    long time = Long.MAX_VALUE;
    Date d = new Date(time);
    System.out.println(d);
}java.text.SimpleDataFormat
java.text.SimpleDateFormat类是一个不与语言环境有关的方式来格式化和解析日期的具体类。
可以进行格式化:日期 --> 文本
可以进行解析:文本 --> 日期
构造器:
-
SimpleDateFormat() :默认的模式和语言环境创建对象
-
public SimpleDateFormat(String pattern):该构造方法可以用参数pattern指定的格式创建一个对象
**格式化: **
- public String format(Date date):方法格式化时间对象date
**解析: **
- public Date parse(String source):从给定字符串的开始解析文本,以生成一个日期。
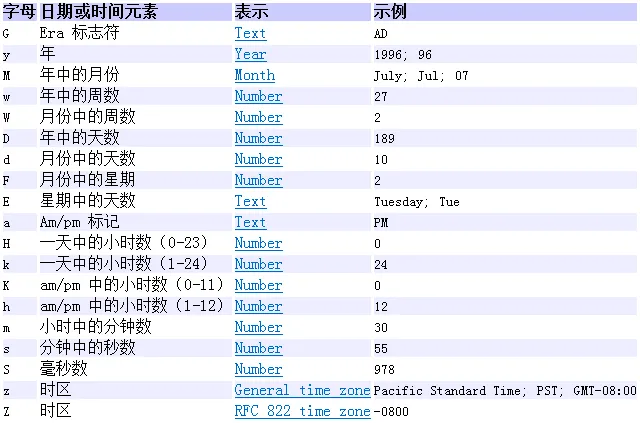
//格式化
@Test
public void test1(){
    Date d = new Date();

    SimpleDateFormat sf = new SimpleDateFormat("yyyy年MM月dd日 HH时mm分ss秒 SSS毫秒  E Z");
    //把Date日期转成字符串,按照指定的格式转
    String str = sf.format(d);
    System.out.println(str);
}
//解析
@Test
public void test2() throws ParseException{
    String str = "2022年06月06日 16时03分14秒 545毫秒  星期四 +0800";
    SimpleDateFormat sf = new SimpleDateFormat("yyyy年MM月dd日 HH时mm分ss秒 SSS毫秒  E Z");
    Date d = sf.parse(str);
    System.out.println(d);
}java.util.Calendar(日历)
Date类的API大部分被废弃了,替换为Calendar。
Calendar 类是一个抽象类,主要用于完成日期字段之间相互操作的功能。
获取Calendar实例的方法 :
1、使用Calendar.getInstance()方法:
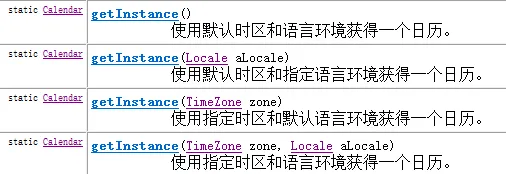
2、调用它的子类GregorianCalendar(公历)的构造器:
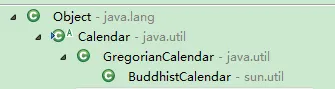
一个Calendar的实例是系统时间的抽象表示,可以修改或获取 YEAR、MONTH、DAY_OF_WEEK、HOUR_OF_DAY 、MINUTE、SECOND等 日历字段对应的时间值:
-
public int get(int field):返回给定日历字段的值
-
public void set(int field,int value) :将给定的日历字段设置为指定的值
-
public void add(int field,int amount):根据日历的规则,为给定的日历字段添加或者减去指定的时间量
-
public final Date getTime():将Calendar转成Date对象
-
public final void setTime(Date date):使用指定的Date对象重置Calendar的时间
常用字段:
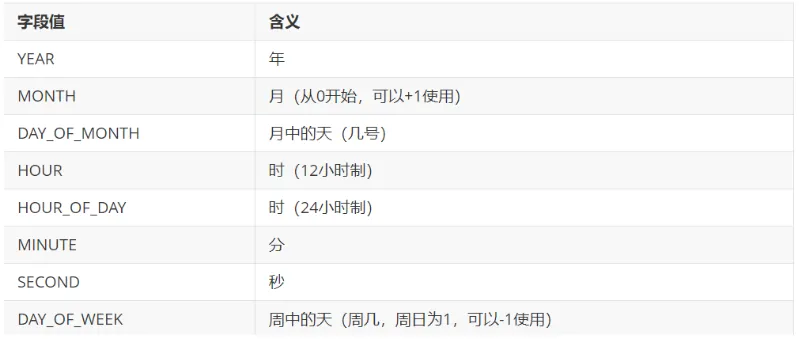
注意:
获取月份时:一月是0,二月是1,以此类推,12月是11
获取星期时:周日是1,周二是2 , 。。。。周六是7
示例代码:
import org.junit.Test;

import java.util.Calendar;
import java.util.TimeZone;

public class TestCalendar {
    @Test
    public void test1(){
        Calendar c = Calendar.getInstance();
        System.out.println(c);

        int year = c.get(Calendar.YEAR);
        int month = c.get(Calendar.MONTH)+1;
        int day = c.get(Calendar.DATE);
        int hour = c.get(Calendar.HOUR_OF_DAY);
        int minute = c.get(Calendar.MINUTE);

        System.out.println(year + "-" + month + "-" + day + " " + hour + ":" + minute);
    }

    @Test
    public void test2(){
        TimeZone t = TimeZone.getTimeZone("America/Los_Angeles");
        Calendar c = Calendar.getInstance(t);
        int year = c.get(Calendar.YEAR);
        int month = c.get(Calendar.MONTH)+1;
        int day = c.get(Calendar.DATE);
        int hour = c.get(Calendar.HOUR_OF_DAY);
        int minute = c.get(Calendar.MINUTE);

        System.out.println(year + "-" + month + "-" + day + " " + hour + ":" + minute);
    }

    @Test
    public void test3(){
        Calendar calendar = Calendar.getInstance();
                // 从一个 Calendar 对象中获取 Date 对象
                Date date = calendar.getTime();

                // 使用给定的 Date 设置此 Calendar 的时间
                date = new Date(234234235235L);
                calendar.setTime(date);
                calendar.set(Calendar.DAY_OF_MONTH, 8);
                System.out.println("当前时间日设置为8后,时间是:" + calendar.getTime());

                calendar.add(Calendar.HOUR, 2);
                System.out.println("当前时间加2小时后,时间是:" + calendar.getTime());

                calendar.add(Calendar.MONTH, -2);
                System.out.println("当前日期减2个月后,时间是:" + calendar.getTime());
    }
}JDK8之后:新的日期 API
本地日期时间:LocalDate、LocalTime、LocalDateTime
| 方法 | 描述 |
|---|---|
| now()/ now(ZoneId zone) | 静态方法,根据当前时间创建对象/指定时区的对象 |
| of(xx,xx,xx,xx,xx,xxx) | 静态方法,根据指定日期/时间创建对象 |
| getDayOfMonth()/getDayOfYear() | 获得月份天数(1-31) /获得年份天数(1-366) |
| getDayOfWeek() | 获得星期几(返回一个 DayOfWeek 枚举值) |
| getMonth() | 获得月份, 返回一个 Month 枚举值 |
| getMonthValue() / getYear() | 获得月份(1-12) /获得年份 |
| getHours()/getMinute()/getSecond() | 获得当前对象对应的小时、分钟、秒 |
| withDayOfMonth()/withDayOfYear()/withMonth()/withYear() | 将月份天数、年份天数、月份、年份修改为指定的值并返回新的对象 |
| with(TemporalAdjuster t) | 将当前日期时间设置为校对器指定的日期时间 |
| plusDays(), plusWeeks(), plusMonths(), plusYears(),plusHours() | 向当前对象添加几天、几周、几个月、几年、几小时 |
| minusMonths() / minusWeeks()/minusDays()/minusYears()/minusHours() | 从当前对象减去几月、几周、几天、几年、几小时 |
| plus(TemporalAmount t)/minus(TemporalAmount t) | 添加或减少一个 Duration 或 Period |
| isBefore()/isAfter() | 比较两个 LocalDate |
| isLeapYear() | 判断是否是闰年(在LocalDate类中声明) |
| format(DateTimeFormatter t) | 格式化本地日期、时间,返回一个字符串 |
| parse(Charsequence text) | 将指定格式的字符串解析为日期、时间 |
import org.junit.Test;

import java.time.LocalDate;
import java.time.LocalDateTime;
import java.time.LocalTime;

public class TestLocalDateTime {
    @Test
    public void test01(){
        LocalDate now = LocalDate.now();
        System.out.println(now);
    }
    @Test
    public void test02(){
        LocalTime now = LocalTime.now();
        System.out.println(now);
    }
    @Test
    public void test03(){
        LocalDateTime now = LocalDateTime.now();
        System.out.println(now);
    }
    @Test
    public void test04(){
        LocalDate lai = LocalDate.of(2019, 5, 13);
        System.out.println(lai);
    }
        @Test
    public void test05(){
        LocalDate lai = LocalDate.of(2019, 5, 13);
        System.out.println(lai.getDayOfYear());
    }
        @Test
    public void test06(){
        LocalDate lai = LocalDate.of(2019, 5, 13);
        LocalDate go = lai.plusDays(160);
        System.out.println(go);//2019-10-20
    }
    @Test
    public void test7(){
        LocalDate now = LocalDate.now();
        LocalDate before = now.minusDays(100);
        System.out.println(before);//2019-02-26
    }
}瞬时:Instant
Instant:时间线上的一个瞬时点。 这可能被用来记录应用程序中的事件时间戳。
-
时间戳是指格林威治时间1970年01月01日00时00分00秒(北京时间1970年01月01日08时00分00秒)起至现在的总秒数。
-
java.time.Instant表示时间线上的一点,而不需要任何上下文信息,例如,时区。概念上讲,它只是简单的表示自1970年1月1日0时0分0秒(UTC)开始的秒数。
| 方法 | 描述 |
|---|---|
| now() | 静态方法,返回默认UTC时区的Instant类的对象 |
| ofEpochMilli(long epochMilli) | 静态方法,返回在1970-01-01 00:00:00基础上加上指定毫秒数之后的Instant类的对象 |
| atOffset(ZoneOffset offset) | 结合即时的偏移来创建一个 OffsetDateTime |
| toEpochMilli() | 返回1970-01-01 00:00:00到当前时间的毫秒数,即为时间戳 |
中国大陆、中国香港、中国澳门、中国台湾、蒙古国、新加坡、马来西亚、菲律宾、西澳大利亚州的时间与UTC的时差均为+8,也就是UTC+8。
instant.atOffset(ZoneOffset.ofHours(8));
日期时间格式化:DateTimeFormatter
该类提供了三种格式化方法:
-
(了解)预定义的标准格式。如:ISO_LOCAL_DATE_TIME、ISO_LOCAL_DATE、ISO_LOCAL_TIME
-
(了解)本地化相关的格式。如:ofLocalizedDate(FormatStyle.LONG)
// 本地化相关的格式。如:ofLocalizedDateTime()
// FormatStyle.MEDIUM / FormatStyle.SHORT :适用于LocalDateTime

// 本地化相关的格式。如:ofLocalizedDate()
// FormatStyle.FULL / FormatStyle.LONG / FormatStyle.MEDIUM / FormatStyle.SHORT : 适用于LocalDate自定义的格式。如:ofPattern(“yyyy-MM-dd hh:mm:ss”)
| 方法 | 描述 |
|---|---|
| ofPattern(Stringpattern) | 静态方法,返回一个指定字符串格式的DateTimeFormatter |
| format(TemporalAccessort) | 格式化一个日期、时间,返回字符串 |
| parse(CharSequencetext) | 将指定格式的字符序列解析为一个日期、时间 |
举例:
import org.junit.Test;

import java.time.LocalDateTime;
import java.time.ZoneId;
import java.time.format.DateTimeFormatter;
import java.time.format.FormatStyle;

public class TestDatetimeFormatter {
    @Test
    public void test1(){
        // 方式一:预定义的标准格式。如:ISO_LOCAL_DATE_TIME;ISO_LOCAL_DATE;ISO_LOCAL_TIME
        DateTimeFormatter formatter = DateTimeFormatter.ISO_LOCAL_DATE_TIME;
        // 格式化:日期-->字符串
        LocalDateTime localDateTime = LocalDateTime.now();
        String str1 = formatter.format(localDateTime);
        System.out.println(localDateTime);
        System.out.println(str1);//2022-12-04T21:02:14.808

        // 解析:字符串 -->日期
        TemporalAccessor parse = formatter.parse("2022-12-04T21:02:14.808");
        LocalDateTime dateTime = LocalDateTime.from(parse);
        System.out.println(dateTime);
    }

    @Test
    public void test2(){
        LocalDateTime localDateTime = LocalDateTime.now();
        // 方式二:
        // 本地化相关的格式。如:ofLocalizedDateTime()
        // FormatStyle.LONG / FormatStyle.MEDIUM / FormatStyle.SHORT :适用于LocalDateTime
        DateTimeFormatter formatter1 = DateTimeFormatter.ofLocalizedDateTime(FormatStyle.LONG);

        // 格式化
        String str2 = formatter1.format(localDateTime);
        System.out.println(str2);// 2022年12月4日 下午09时03分55秒

        // 本地化相关的格式。如:ofLocalizedDate()
        // FormatStyle.FULL / FormatStyle.LONG / FormatStyle.MEDIUM / FormatStyle.SHORT : 适用于LocalDate
        DateTimeFormatter formatter2 = DateTimeFormatter.ofLocalizedDate(FormatStyle.FULL);
        // 格式化
        String str3 = formatter2.format(LocalDate.now());
        System.out.println(str3);// 2022年12月4日 星期日
    }

    @Test
    public void test3(){
        //方式三:自定义的方式(关注、重点)
        DateTimeFormatter dateTimeFormatter = DateTimeFormatter.ofPattern("yyyy/MM/dd HH:mm:ss");
        //格式化
        String strDateTime = dateTimeFormatter.format(LocalDateTime.now());
        System.out.println(strDateTime); //2022/12/04 21:05:42
        //解析
        TemporalAccessor accessor = dateTimeFormatter.parse("2022/12/04 21:05:42");
        LocalDateTime localDateTime = LocalDateTime.from(accessor);
        System.out.println(localDateTime); //2022-12-04T21:05:42
    }
}其它API
1、指定时区日期时间:ZondId和ZonedDateTime
ZoneId:该类中包含了所有的时区信息,一个时区的ID,如 Europe/Paris
ZonedDateTime:一个在ISO-8601日历系统时区的日期时间,如 2007-12-03T10:15:30+01:00 Europe/Paris。其中每个时区都对应着ID,地区ID都为“{区域}/{城市}”的格式,例如:Asia/Shanghai等
常见时区ID:
Asia/Shanghai
UTC
America/New_York可以通过ZondId获取所有可用的时区ID:
import java.time.ZoneId;
import java.time.ZonedDateTime;
import java.util.Set;

public class TestZone {
    @Test
    public void test01() {
        //需要知道一些时区的id
        //Set<String>是一个集合,容器
        Set<String> availableZoneIds = ZoneId.getAvailableZoneIds();
        //快捷模板iter
        for (String availableZoneId : availableZoneIds) {
            System.out.println(availableZoneId);
        }
    }

    @Test
    public void test02(){
        ZonedDateTime t1 = ZonedDateTime.now();
        System.out.println(t1);

        ZonedDateTime t2 = ZonedDateTime.now(ZoneId.of("America/New_York"));
        System.out.println(t2);
    }
}2、持续日期/时间:Period和Duration
-
持续时间:Duration,用于计算两个“时间”间隔
-
日期间隔:Period,用于计算两个“日期”间隔
import org.junit.Test;

import java.time.Duration;
import java.time.LocalDate;
import java.time.LocalDateTime;
import java.time.Period;

public class TestPeriodDuration {
    @Test
    public void test01(){
        LocalDate t1 = LocalDate.now();
        LocalDate t2 = LocalDate.of(2018, 12, 31);
        Period between = Period.between(t1, t2);
        System.out.println(between);

        System.out.println("相差的年数:"+between.getYears());
        System.out.println("相差的月数:"+between.getMonths());
        System.out.println("相差的天数:"+between.getDays());
        System.out.println("相差的总数:"+between.toTotalMonths());
    }

    @Test
    public void test02(){
        LocalDateTime t1 = LocalDateTime.now();
        LocalDateTime t2 = LocalDateTime.of(2017, 8, 29, 0, 0, 0, 0);
        Duration between = Duration.between(t1, t2);
        System.out.println(between);

        System.out.println("相差的总天数:"+between.toDays());
        System.out.println("相差的总小时数:"+between.toHours());
        System.out.println("相差的总分钟数:"+between.toMinutes());
        System.out.println("相差的总秒数:"+between.getSeconds());
        System.out.println("相差的总毫秒数:"+between.toMillis());
        System.out.println("相差的总纳秒数:"+between.toNanos());
        System.out.println("不够一秒的纳秒数:"+between.getNano());
    }
    @Test
    public void test03(){
        //Duration:用于计算两个“时间”间隔,以秒和纳秒为基准
                LocalTime localTime = LocalTime.now();
                LocalTime localTime1 = LocalTime.of(15, 23, 32);
                //between():静态方法,返回Duration对象,表示两个时间的间隔
                Duration duration = Duration.between(localTime1, localTime);
                System.out.println(duration);

                System.out.println(duration.getSeconds());
                System.out.println(duration.getNano());

                LocalDateTime localDateTime = LocalDateTime.of(2016, 6, 12, 15, 23, 32);
                LocalDateTime localDateTime1 = LocalDateTime.of(2017, 6, 12, 15, 23, 32);

                Duration duration1 = Duration.between(localDateTime1, localDateTime);
                System.out.println(duration1.toDays());
    }

    @Test
    public void test4(){
        //Period:用于计算两个“日期”间隔,以年、月、日衡量
                LocalDate localDate = LocalDate.now();
                LocalDate localDate1 = LocalDate.of(2028, 3, 18);

                Period period = Period.between(localDate, localDate1);
                System.out.println(period);

                System.out.println(period.getYears());
                System.out.println(period.getMonths());
                System.out.println(period.getDays());

                Period period1 = period.withYears(2);
                System.out.println(period1);

    }
}3、Clock:使用时区提供对当前即时、日期和时间的访问的时钟。4、
TemporalAdjuster : 时间校正器。有时我们可能需要获取例如:将日期调整到“下一个工作日”等操作。
TemporalAdjusters : 该类通过静态方法(firstDayOfXxx()/lastDayOfXxx()/nextXxx())提供了大量的常用 TemporalAdjuster 的实现。
@Test
public void test1(){
    // TemporalAdjuster:时间校正器
        // 获取当前日期的下一个周日是哪天?
        TemporalAdjuster temporalAdjuster = TemporalAdjusters.next(DayOfWeek.SUNDAY);
        LocalDateTime localDateTime = LocalDateTime.now().with(temporalAdjuster);
        System.out.println(localDateTime);
        // 获取下一个工作日是哪天?
        LocalDate localDate = LocalDate.now().with(new TemporalAdjuster() {
                    @Override
                    public Temporal adjustInto(Temporal temporal) {
                LocalDate date = (LocalDate) temporal;
                       if (date.getDayOfWeek().equals(DayOfWeek.FRIDAY)) {
                           return date.plusDays(3);
                } else if (date.getDayOfWeek().equals(DayOfWeek.SATURDAY)) {
                    return date.plusDays(2);
                } else {
                    return date.plusDays(1);
                }
            }
        });
        System.out.println("下一个工作日是:" + localDate);

}与传统日期处理的转换
| 类 | To遗留类 | From遗留类 |
|---|---|---|
| java.time.Instant与java.util.Date | Date.from(instant) | date.toInstant() |
| java.time.Instant与java.sql.Timestamp | Timestamp.from(instant) | timestamp.toInstant() |
| java.time.ZonedDateTime与java.util.GregorianCalendar | GregorianCalendar.from(zonedDateTime) | cal.toZonedDateTime() |
| java.time.LocalDate与java.sql.Time | Date.valueOf(localDate) | date.toLocalDate() |
| java.time.LocalTime与java.sql.Time | Date.valueOf(localDate) | date.toLocalTime() |
| java.time.LocalDateTime与java.sql.Timestamp | Timestamp.valueOf(localDateTime) | timestamp.toLocalDateTime() |
| java.time.ZoneId与java.util.TimeZone | Timezone.getTimeZone(id) | timeZone.toZoneId() |
| java.time.format.DateTimeFormatter与java.text.DateFormat | formatter.toFormat() | 无 |
Java比较器
在Java中经常会涉及到对象数组的排序问题,那么就涉及到对象之间的比较问题。
Java实现对象排序的方式有两种:
-
自然排序:java.lang.Comparable
-
定制排序:java.util.Comparator
自然排序:java.lang.Comparable
Comparable接口强行对实现它的每个类的对象进行整体排序。这种排序被称为类的自然排序。
实现 Comparable 的类必须实现 compareTo(Object obj)方法,两个对象即通过 compareTo(Object obj) 方法的返回值来比较大小。如果当前对象this大于形参对象obj,则返回正整数,如果当前对象this小于形参对象obj,则返回负整数,如果当前对象this等于形参对象obj,则返回零。
package java.lang;

public interface Comparable{
    int compareTo(Object obj);
}实现Comparable接口的对象列表(和数组)可以通过 Collections.sort 或 Arrays.sort进行自动排序。实现此接口的对象可以用作有序映射中的键或有序集合中的元素,无需指定比较器。
对于类 C 的每一个 e1 和 e2 来说,当且仅当 e1.compareTo(e2) == 0 与 e1.equals(e2) 具有相同的 boolean 值时,类 C 的自然排序才叫做与 equals 一致。建议(虽然不是必需的)最好使自然排序与 equals 一致。
Comparable 的典型实现:(默认都是从小到大排列的)
-
String:按照字符串中字符的Unicode值进行比较
-
Character:按照字符的Unicode值来进行比较
-
数值类型对应的包装类以及BigInteger、BigDecimal:按照它们对应的数值大小进行比较
-
Boolean:true 对应的包装类实例大于 false 对应的包装类实例
-
Date、Time等:后面的日期时间比前面的日期时间大
代码示例:
package com.atguigu.api;

public class Student implements Comparable {
    private int id;
    private String name;
    private int score;
    private int age;

    public Student(int id, String name, int score, int age) {
        this.id = id;
        this.name = name;
        this.score = score;
        this.age = age;
    }

    public int getId() {
        return id;
    }

    public void setId(int id) {
        this.id = id;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public int getScore() {
        return score;
    }

    public void setScore(int score) {
        this.score = score;
    }

    public int getAge() {
        return age;
    }

    public void setAge(int age) {
        this.age = age;
    }

    @Override
    public String toString() {
        return "Student{" +
                "id=" + id +
                ", name='" + name + '\'' +
                ", score=" + score +
                ", age=" + age +
                '}';
    }

    @Override
    public int compareTo(Object o) {
        //这些需要强制,将o对象向下转型为Student类型的变量,才能调用Student类中的属性
        //默认按照学号比较大小
        Student stu = (Student) o;
        return this.id - stu.id;
    }
}测试类:
package com.atguigu.api;

public class TestStudent {
    public static void main(String[] args) {
        Student[] arr = new Student[5];
        arr[0] = new Student(3,"张三",90,23);
        arr[1] = new Student(1,"熊大",100,22);
        arr[2] = new Student(5,"王五",75,25);
        arr[3] = new Student(4,"李四",85,24);
        arr[4] = new Student(2,"熊二",85,18);

        //单独比较两个对象
        System.out.println(arr[0].compareTo(arr[1]));
        System.out.println(arr[1].compareTo(arr[2]));
        System.out.println(arr[2].compareTo(arr[2]));

        System.out.println("所有学生:");
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }
        System.out.println("按照学号排序:");
        for (int i = 1; i < arr.length; i++) {
            for (int j = 0; j < arr.length-i; j++) {
                if(arr[j].compareTo(arr[j+1])>0){
                    Student temp = arr[j];
                    arr[j] = arr[j+1];
                    arr[j+1] = temp;
                }
            }
        }
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }
    }
}定制排序:java.util.Comparator
思考
-
当元素的类型没有实现java.lang.Comparable接口而又不方便修改代码(例如:一些第三方的类,你只有.class文件,没有源文件)
-
如果一个类,实现了Comparable接口,也指定了两个对象的比较大小的规则,但是此时此刻我不想按照它预定义的方法比较大小,但是我又不能随意修改,因为会影响其他地方的使用,怎么办?
JDK在设计类库之初,也考虑到这种情况,所以又增加了一个java.util.Comparator接口。强行对多个对象进行整体排序的比较。
-
重写compare(Object o1,Object o2)方法,比较o1和o2的大小:如果方法返回正整数,则表示o1大于o2;如果返回0,表示相等;返回负整数,表示o1小于o2。
-
可以将 Comparator 传递给 sort 方法(如 Collections.sort 或 Arrays.sort),从而允许在排序顺序上实现精确控制。
package java.util;

public interface Comparator{
    int compare(Object o1,Object o2);
}举例:
package com.atguigu.api;

import java.util.Comparator;
//定义定制比较器类
public class StudentScoreComparator implements Comparator {
    @Override
    public int compare(Object o1, Object o2) {
        Student s1 = (Student) o1;
        Student s2 = (Student) o2;
        int result = s1.getScore() - s2.getScore();
        return result != 0 ? result : s1.getId() - s2.getId();
    }
}测试类
package com.atguigu.api;

public class TestStudent {
    public static void main(String[] args) {
        Student[] arr = new Student[5];
        arr[0] = new Student(3, "张三", 90, 23);
        arr[1] = new Student(1, "熊大", 100, 22);
        arr[2] = new Student(5, "王五", 75, 25);
        arr[3] = new Student(4, "李四", 85, 24);
        arr[4] = new Student(2, "熊二", 85, 18);


        System.out.println("所有学生:");
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }

        System.out.println("按照成绩排序");
        StudentScoreComparator sc = new StudentScoreComparator();
        for (int i = 1; i < arr.length; i++) {
            for (int j = 0; j < arr.length - i; j++) {
                if (sc.compare(arr[j], arr[j + 1]) > 0) {
                    Student temp = arr[j];
                    arr[j] = arr[j + 1];
                    arr[j + 1] = temp;
                }
            }
        }
        for (int i = 0; i < arr.length; i++) {
            System.out.println(arr[i]);
        }
    }
}系统相关类
java.lang.System类
System类代表系统,系统级的很多属性和控制方法都放置在该类的内部。该类位于java.lang包。
由于该类的构造器是private的,所以无法创建该类的对象。其内部的成员变量和成员方法都是static的,所以也可以很方便的进行调用。
成员变量 Scanner scan = new Scanner(System.in);
- System类内部包含
in、out和err三个成员变量,分别代表标准输入流(键盘输入),标准输出流(显示器)和标准错误输出流(显示器)。
成员方法
-
native long currentTimeMillis(): 该方法的作用是返回当前的计算机时间,时间的表达格式为当前计算机时间和GMT时间(格林威治时间)1970年1月1号0时0分0秒所差的毫秒数。 -
void exit(int status): 该方法的作用是退出程序。其中status的值为0代表正常退出,非零代表异常退出。使用该方法可以在图形界面编程中实现程序的退出功能等。 -
void gc(): 该方法的作用是请求系统进行垃圾回收。至于系统是否立刻回收,则取决于系统中垃圾回收算法的实现以及系统执行时的情况。 -
String getProperty(String key): 该方法的作用是获得系统中属性名为key的属性对应的值。系统中常见的属性名以及属性的作用如下表所示:
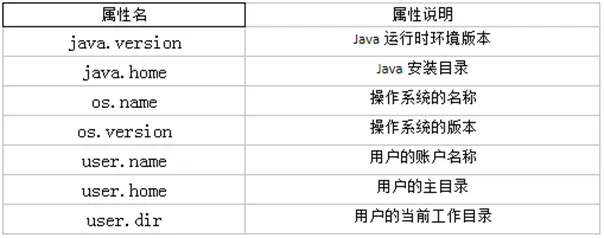
import org.junit.Test;

public class TestSystem {
    @Test
    public void test01(){
        long time = System.currentTimeMillis();
        System.out.println("现在的系统时间距离1970年1月1日凌晨:" + time + "毫秒");

        System.exit(0);

        System.out.println("over");//不会执行
    }

    @Test
    public void test02(){
        String javaVersion = System.getProperty("java.version");
                System.out.println("java的version:" + javaVersion);

                String javaHome = System.getProperty("java.home");
                System.out.println("java的home:" + javaHome);

                String osName = System.getProperty("os.name");
                System.out.println("os的name:" + osName);

                String osVersion = System.getProperty("os.version");
                System.out.println("os的version:" + osVersion);

                String userName = System.getProperty("user.name");
                System.out.println("user的name:" + userName);

                String userHome = System.getProperty("user.home");
                System.out.println("user的home:" + userHome);

                String userDir = System.getProperty("user.dir");
                System.out.println("user的dir:" + userDir);
    }

    @Test
    public void test03() throws InterruptedException {
        for (int i=1; i <=10; i++){
            MyDemo my = new MyDemo(i);
            //每一次循环my就会指向新的对象,那么上次的对象就没有变量引用它了,就成垃圾对象
        }

        //为了看到垃圾回收器工作,我要加下面的代码,让main方法不那么快结束,因为main结束就会导致JVM退出,GC也会跟着结束。
        System.gc();//如果不调用这句代码,GC可能不工作,因为当前内存很充足,GC就觉得不着急回收垃圾对象。
                                //调用这句代码,会让GC尽快来工作。
        Thread.sleep(5000);
    }
}

class MyDemo{
    private int value;

    public MyDemo(int value) {
        this.value = value;
    }

    @Override
    public String toString() {
        return "MyDemo{" + "value=" + value + '}';
    }

    //重写finalize方法,让大家看一下它的调用效果
    @Override
    protected void finalize() throws Throwable {
//        正常重写,这里是编写清理系统内存的代码
//        这里写输出语句是为了看到finalize()方法被调用的效果
        System.out.println(this+ "轻轻的我走了,不带走一段代码....");
    }
}static void arraycopy(Object src, int srcPos, Object dest, int destPos, int length): 从指定源数组中复制一个数组,复制从指定的位置开始,到目标数组的指定位置结束。常用于数组的插入和删除
java.lang.Runtime类
每个 Java 应用程序都有一个 Runtime 类实例,使应用程序能够与其运行的环境相连接。
public static Runtime getRuntime(): 返回与当前 Java 应用程序相关的运行时对象。应用程序不能创建自己的 Runtime 类实例。
public long totalMemory():返回 Java 虚拟机中初始化时的内存总量。此方法返回的值可能随时间的推移而变化,这取决于主机环境。默认为物理电脑内存的1/64。
public long maxMemory():返回 Java 虚拟机中最大程度能使用的内存总量。默认为物理电脑内存的1/4。
public long freeMemory():回 Java 虚拟机中的空闲内存量。调用 gc 方法可能导致 freeMemory 返回值的增加。
package com.atguigu.system;

public class TestRuntime {
    public static void main(String[] args) {
        Runtime runtime = Runtime.getRuntime();
        long initialMemory = runtime.totalMemory(); //获取虚拟机初始化时堆内存总量
        long maxMemory = runtime.maxMemory(); //获取虚拟机最大堆内存总量
        String str = "";
        //模拟占用内存
        for (int i = 0; i < 10000; i++) {
            str += i;
        }
        long freeMemory = runtime.freeMemory(); //获取空闲堆内存总量
        System.out.println("总内存:" + initialMemory / 1024 / 1024 * 64 + "MB");
        System.out.println("总内存:" + maxMemory / 1024 / 1024 * 4 + "MB");
        System.out.println("空闲内存:" + freeMemory / 1024 / 1024 + "MB") ;
        System.out.println("已用内存:" + (initialMemory-freeMemory) / 1024 / 1024 + "MB");
    }
}和数学相关的类
java.lang.Math
java.lang.Math 类包含用于执行基本数学运算的方法,如初等指数、对数、平方根和三角函数。类似这样的工具类,其所有方法均为静态方法,并且不会创建对象,调用起来非常简单。
public static double abs(double a) :返回 double 值的绝对值。
double d1 = Math.abs(-5); //d1的值为5
double d2 = Math.abs(5); //d2的值为5public static double ceil(double a) :返回大于等于参数的最小的整数。
double d1 = Math.ceil(3.3); //d1的值为 4.0
double d2 = Math.ceil(-3.3); //d2的值为 -3.0
double d3 = Math.ceil(5.1); //d3的值为 6.0public static double floor(double a) :返回小于等于参数最大的整数
double d1 = Math.floor(3.3); //d1的值为3.0
double d2 = Math.floor(-3.3); //d2的值为-4.0
double d3 = Math.floor(5.1); //d3的值为 5.0public static long round(double a) :返回最接近参数的 long。(相当于四舍五入方法)
long d1 = Math.round(5.5); //d1的值为6
long d2 = Math.round(5.4); //d2的值为5
long d3 = Math.round(-3.3); //d3的值为-3
long d4 = Math.round(-3.8); //d4的值为-4-
public static double pow(double a,double b):返回a的b幂次方法
-
public static double sqrt(double a):返回a的平方根
-
public static double random():返回[0,1)的随机值
-
public static final double PI:返回圆周率
-
public static double max(double x, double y):返回x,y中的最大值
-
public static double min(double x, double y):返回x,y中的最小值
-
其它:acos,asin,atan,cos,sin,tan 三角函数
double result = Math.pow(2,31);
double sqrt = Math.sqrt(256);
double rand = Math.random();
double pi = Math.PI;java.math 包
BigInteger
Integer类作为int的包装类,能存储的最大整型值为2(31-1,Long类也是有限的,最大为2)63-1。如果要表示再大的整数,不管是基本数据类型还是他们的包装类都无能为力,更不用说进行运算了。
java.math包的BigInteger可以表示不可变的任意精度的整数。BigInteger 提供所有 Java 的基本整数操作符的对应物,并提供 java.lang.Math 的所有相关方法。另外,BigInteger 还提供以下运算:模算术、GCD 计算、质数测试、素数生成、位操作以及一些其他操作。
构造器 :BigInteger(String val):根据字符串构建BigInteger对象
方法 :
-
public BigInteger
abs():返回此 BigInteger 的绝对值的 BigInteger。 -
BigInteger
add(BigInteger val) :返回其值为 (this + val) 的 BigInteger -
BigInteger
subtract(BigInteger val) :返回其值为 (this - val) 的 BigInteger -
BigInteger
multiply(BigInteger val) :返回其值为 (this * val) 的 BigInteger -
BigInteger
divide(BigInteger val) :返回其值为 (this / val) 的 BigInteger。整数相除只保留整数部分。 -
BigInteger
remainder(BigInteger val) :返回其值为 (this % val) 的 BigInteger。 -
BigInteger[]
divideAndRemainder(BigInteger val):返回包含 (this / val) 后跟 (this % val) 的两个 BigInteger 的数组。 -
BigInteger
pow(int exponent) :返回其值为 (this^exponent) 的 BigInteger。
@Test
public void test01(){
    //long bigNum = 123456789123456789123456789L;

    BigInteger b1 = new BigInteger("12345678912345678912345678");
    BigInteger b2 = new BigInteger("78923456789123456789123456789");

    //System.out.println("和:" + (b1+b2));//错误的,无法直接使用+进行求和

    System.out.println("和:" + b1.add(b2));
    System.out.println("减:" + b1.subtract(b2));
    System.out.println("乘:" + b1.multiply(b2));
    System.out.println("除:" + b2.divide(b1));
    System.out.println("余:" + b2.remainder(b1));
}BigDecimal
一般的Float类和Double类可以用来做科学计算或工程计算,但在商业计算中,要求数字精度比较高,故用到java.math.BigDecimal类。
BigDecimal类支持不可变的、任意精度的有符号十进制定点数。
构造器 :
-
public BigDecimal(double val)
-
public BigDecimal(String val) --> 推荐
常用方法
-
public BigDecimal
add(BigDecimal augend) -
public BigDecimal
subtract(BigDecimal subtrahend) -
public BigDecimal
multiply(BigDecimal multiplicand) -
public BigDecimal
divide(BigDecimal divisor, int scale, int roundingMode):divisor是除数,scale指明保留几位小数,roundingMode指明舍入模式(ROUND_UP :向上加1、ROUND_DOWN :直接舍去、ROUND_HALF_UP:四舍五入)
举例:
@Test
public void test03(){
    BigInteger bi = new BigInteger("12433241123");
    BigDecimal bd = new BigDecimal("12435.351");
    BigDecimal bd2 = new BigDecimal("11");
    System.out.println(bi);
    // System.out.println(bd.divide(bd2));
    System.out.println(bd.divide(bd2, BigDecimal.ROUND_HALF_UP));
    System.out.println(bd.divide(bd2, 15, BigDecimal.ROUND_HALF_UP));
}java.util.Random
用于产生随机数
-
boolean nextBoolean():返回下一个伪随机数,它是取自此随机数生成器序列的均匀分布的 boolean 值。 -
void nextBytes(byte[] bytes):生成随机字节并将其置于用户提供的 byte 数组中。 -
double nextDouble():返回下一个伪随机数,它是取自此随机数生成器序列的、在 0.0 和 1.0 之间均匀分布的 double 值。 -
float nextFloat():返回下一个伪随机数,它是取自此随机数生成器序列的、在 0.0 和 1.0 之间均匀分布的 float 值。 -
double nextGaussian():返回下一个伪随机数,它是取自此随机数生成器序列的、呈高斯(“正态”)分布的 double 值,其平均值是 0.0,标准差是 1.0。 -
int nextInt():返回下一个伪随机数,它是此随机数生成器的序列中均匀分布的 int 值。 -
int nextInt(int n):返回一个伪随机数,它是取自此随机数生成器序列的、在 0(包括)和指定值(不包括)之间均匀分布的 int 值。 -
long nextLong():返回下一个伪随机数,它是取自此随机数生成器序列的均匀分布的 long 值。
@Test
public void test04(){
    Random r = new Random();
    System.out.println("随机整数:" + r.nextInt());
    System.out.println("随机小数:" + r.nextDouble());
    System.out.println("随机布尔值:" + r.nextBoolean());
}集合
Java集合体系
Java 集合可分为 Collection 和 Map 两大体系:
-
Collection接口:用于存储一个一个的数据,也称
单列数据集合。 -
List子接口:用来存储有序的、可以重复的数据(主要用来替换数组,"动态"数组)
-
实现类:ArrayList(主要实现类)、LinkedList、Vector
-
Set子接口:用来存储无序的、不可重复的数据(类似于高中讲的"集合")
-
实现类:HashSet(主要实现类)、LinkedHashSet、TreeSet
-
Map接口:用于存储具有映射关系“key-value对”的集合,即一对一对的数据,也称
双列数据集合。(类似于高中的函数、映射。(x1,y1),(x2,y2) ---> y = f(x) ) -
HashMap(主要实现类)、LinkedHashMap、TreeMap、Hashtable、Properties
-
JDK提供的集合API位于java.util包内
Collection接口继承树:
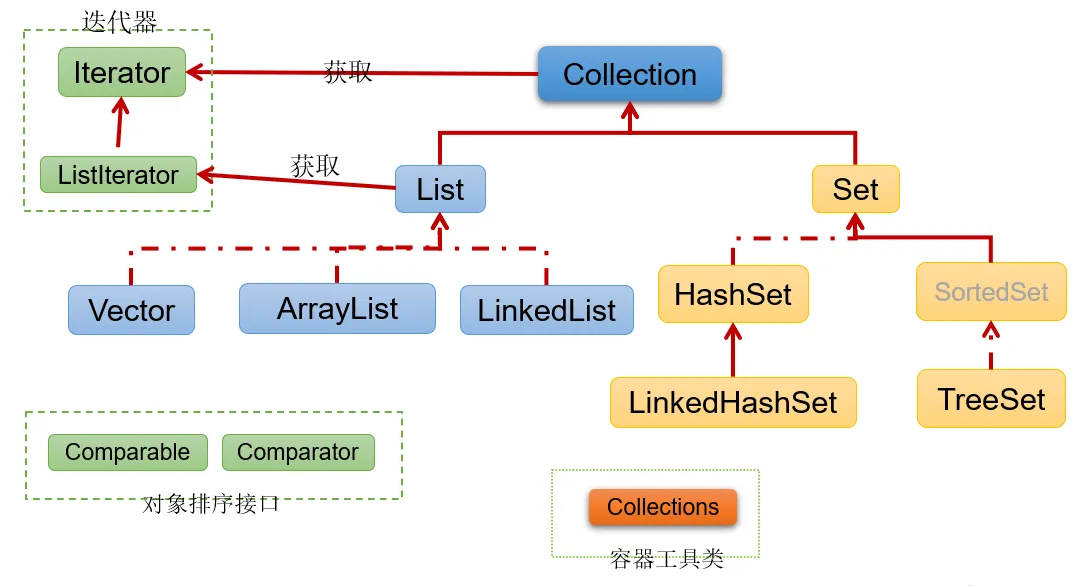
Map接口继承树
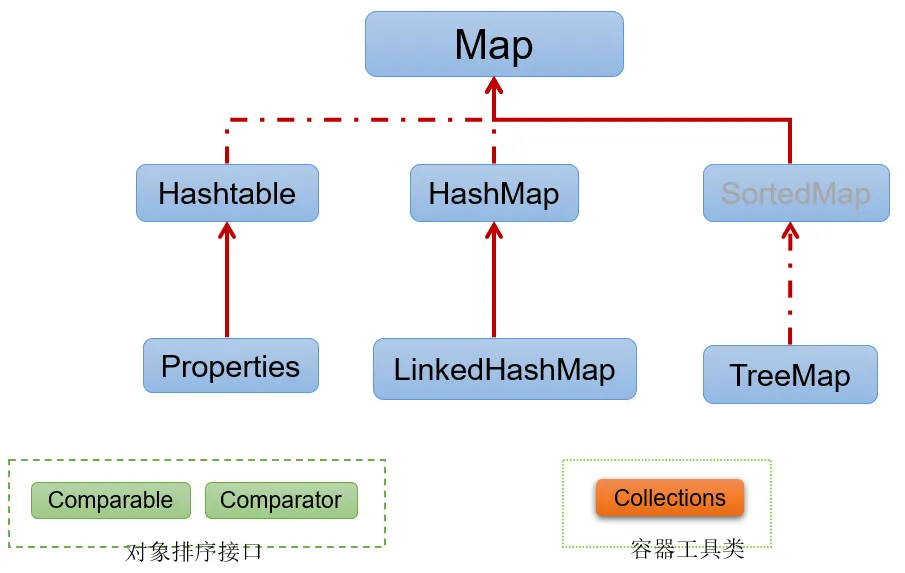
Collection 接口及方法
JDK不提供此接口的任何直接实现,而是提供更具体的子接口(如:Set和List)去实现。
Collection 接口是 List和Set接口的父接口,该接口里定义的方法既可用于操作 Set 集合,也可用于操作 List 集合。方法如下:
添加
-
add(E obj):添加元素对象到当前集合中
-
addAll(Collection other):添加other集合中的所有元素对象到当前集合中,即this = this ∪ other
注意:add 和 addAll 的区别
import org.junit.Test;

import java.util.ArrayList;
import java.util.Collection;

public class TestCollectionAdd {
    @Test
    public void testAdd(){
        //ArrayList是Collection的子接口List的实现类之一。
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        System.out.println(coll);
    }

    @Test
    public void testAddAll(){
        Collection c1 = new ArrayList();
        c1.add(1);
        c1.add(2);
        System.out.println("c1集合元素的个数:" + c1.size());//2
        System.out.println("c1 = " + c1);

        Collection c2 = new ArrayList();
        c2.add(1);
        c2.add(2);
        System.out.println("c2集合元素的个数:" + c2.size());//2
        System.out.println("c2 = " + c2);

        Collection other = new ArrayList();
        other.add(1);
        other.add(2);
        other.add(3);
        System.out.println("other集合元素的个数:" + other.size());//3
        System.out.println("other = " + other);
        System.out.println();

        c1.addAll(other);
        System.out.println("c1集合元素的个数:" + c1.size());//5
        System.out.println("c1.addAll(other) = " + c1);

        c2.add(other);
        System.out.println("c2集合元素的个数:" + c2.size());//3
        System.out.println("c2.add(other) = " + c2);
    }
}注意:coll.addAll(other);与coll.add(other);
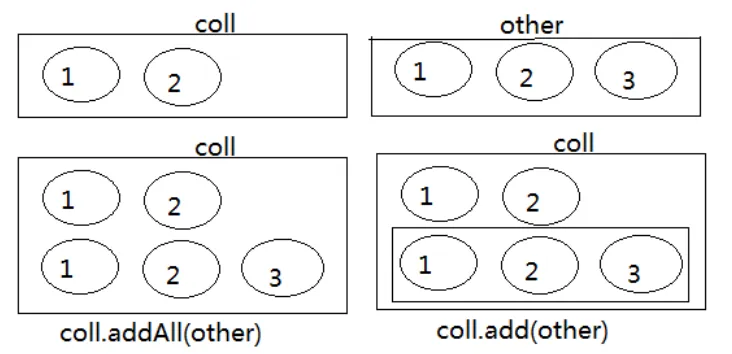
判断
-
int size():获取当前集合中实际存储的元素个数
-
boolean isEmpty():判断当前集合是否为空集合
-
boolean contains(Object obj):判断当前集合中是否存在一个与obj对象equals返回true的元素
-
boolean containsAll(Collection coll):判断coll集合中的元素是否在当前集合中都存在。即coll集合是否是当前集合的“子集”
-
boolean equals(Object obj):判断当前集合与obj是否相等
import org.junit.Test;

import java.util.ArrayList;
import java.util.Arrays;
import java.util.Collection;

public class TestCollectionContains {
    @Test
    public void test01() {
        Collection coll = new ArrayList();
        System.out.println("coll在添加元素之前,isEmpty = " + coll.isEmpty());
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        coll.add("佛地魔");
        System.out.println("coll的元素个数" + coll.size());

        System.out.println("coll在添加元素之后,isEmpty = " + coll.isEmpty());
    }

    @Test
    public void test02() {
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        coll.add("佛地魔");
        System.out.println("coll = " + coll);
        System.out.println("coll是否包含“小李广” = " + coll.contains("小李广"));
        System.out.println("coll是否包含“宋红康” = " + coll.contains("宋红康"));

        Collection other = new ArrayList();
        other.add("小李广");
        other.add("扫地僧");
        other.add("尚硅谷");
        System.out.println("other = " + other);

        System.out.println("coll.containsAll(other) = " + coll.containsAll(other));
    }

    @Test
    public void test03(){
        Collection c1 = new ArrayList();
        c1.add(1);
        c1.add(2);
        System.out.println("c1集合元素的个数:" + c1.size());//2
        System.out.println("c1 = " + c1);

        Collection c2 = new ArrayList();
        c2.add(1);
        c2.add(2);
        System.out.println("c2集合元素的个数:" + c2.size());//2
        System.out.println("c2 = " + c2);

        Collection other = new ArrayList();
        other.add(1);
        other.add(2);
        other.add(3);
        System.out.println("other集合元素的个数:" + other.size());//3
        System.out.println("other = " + other);
        System.out.println();

        c1.addAll(other);
        System.out.println("c1集合元素的个数:" + c1.size());//5
        System.out.println("c1.addAll(other) = " + c1);
        System.out.println("c1.contains(other) = " + c1.contains(other));
        System.out.println("c1.containsAll(other) = " + c1.containsAll(other));
        System.out.println();

        c2.add(other);
        System.out.println("c2集合元素的个数:" + c2.size());
        System.out.println("c2.add(other) = " + c2);
        System.out.println("c2.contains(other) = " + c2.contains(other));
        System.out.println("c2.containsAll(other) = " + c2.containsAll(other));
    }

}删除
-
void clear():清空集合元素
-
boolean remove(Object obj) :从当前集合中删除第一个找到的与obj对象equals返回true的元素。
-
boolean removeAll(Collection coll):从当前集合中删除所有与coll集合中相同的元素。即this = this - this ∩ coll
-
boolean retainAll(Collection coll):从当前集合中删除两个集合中不同的元素,使得当前集合仅保留与coll集合中的元素相同的元素,即当前集合中仅保留两个集合的交集,即this = this ∩ coll;
注意几种删除方法的区别
import org.junit.Test;

import java.util.ArrayList;
import java.util.Collection;
import java.util.function.Predicate;

public class TestCollectionRemove {
    @Test
    public void test01(){
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        coll.add("佛地魔");
        System.out.println("coll = " + coll);

        coll.remove("小李广");
        System.out.println("删除元素\"小李广\"之后coll = " + coll);

        coll.clear();
        System.out.println("coll清空之后,coll = " + coll);
    }

    @Test
    public void test02() {
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        coll.add("佛地魔");
        System.out.println("coll = " + coll);

        Collection other = new ArrayList();
        other.add("小李广");
        other.add("扫地僧");
        other.add("尚硅谷");
        System.out.println("other = " + other);

        coll.removeAll(other);
        System.out.println("coll.removeAll(other)之后,coll = " + coll);
        System.out.println("coll.removeAll(other)之后,other = " + other);
    }

    @Test
    public void test03() {
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        coll.add("佛地魔");
        System.out.println("coll = " + coll);

        Collection other = new ArrayList();
        other.add("小李广");
        other.add("扫地僧");
        other.add("尚硅谷");
        System.out.println("other = " + other);

        coll.retainAll(other);
        System.out.println("coll.retainAll(other)之后,coll = " + coll);
        System.out.println("coll.retainAll(other)之后,other = " + other);
    }

}其他
-
Object[] toArray():返回包含当前集合中所有元素的数组
-
hashCode():获取集合对象的哈希值
-
iterator():返回迭代器对象,用于集合遍历
public class TestCollectionContains {
    @Test
    public void test01() {
        Collection coll = new ArrayList();

        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        coll.add("佛地魔");
                //集合转换为数组:集合的toArray()方法
        Object[] objects = coll.toArray();
        System.out.println("用数组返回coll中所有元素:" + Arrays.toString(objects));

        //对应的,数组转换为集合:调用Arrays的asList(Object ...objs)
        Object[] arr1 = new Object[]{123,"AA","CC"};
        Collection list = Arrays.asList(arr1);
        System.out.println(list);
    }
}Iterator(迭代器)接口
Iterator接口
在程序开发中,经常需要遍历集合中的所有元素。针对这种需求,JDK专门提供了一个接口java.util.Iterator。Iterator接口也是Java集合中的一员,但它与Collection、Map接口有所不同。
-
Collection接口与Map接口主要用于
存储元素 -
Iterator,被称为迭代器接口,本身并不提供存储对象的能力,主要用于遍历Collection中的元素
Collection接口继承了java.lang.Iterable接口,该接口有一个iterator()方法,那么所有实现了Collection接口的集合类都有一个iterator()方法,用以返回一个实现了Iterator接口的对象。
-
public Iterator iterator(): 获取集合对应的迭代器,用来遍历集合中的元素的。 -
集合对象每次调用iterator()方法都得到一个全新的迭代器对象,默认游标都在集合的第一个元素之前。
Iterator接口的常用方法如下:
-
public E next():返回迭代的下一个元素。 -
public boolean hasNext():如果仍有元素可以迭代,则返回 true。
注意:在调用it.next()方法之前必须要调用it.hasNext()进行检测。若不调用,且下一条记录无效,直接调用it.next()会抛出NoSuchElementException异常。
举例:
import org.junit.Test;

import java.util.ArrayList;
import java.util.Collection;
import java.util.Iterator;

public class TestIterator {
    @Test
    public void test01(){
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");

        Iterator iterator = coll.iterator();
        System.out.println(iterator.next());
        System.out.println(iterator.next());
        System.out.println(iterator.next());
        System.out.println(iterator.next()); //报NoSuchElementException异常
    }

    @Test
    public void test02(){
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");

        Iterator iterator = coll.iterator();//获取迭代器对象
        while(iterator.hasNext()) {//判断是否还有元素可迭代
            System.out.println(iterator.next());//取出下一个元素
        }
    }
}迭代器的执行原理
Iterator迭代器对象在遍历集合时,内部采用指针的方式来跟踪集合中的元素,接下来通过一个图例来演示Iterator对象迭代元素的过程:
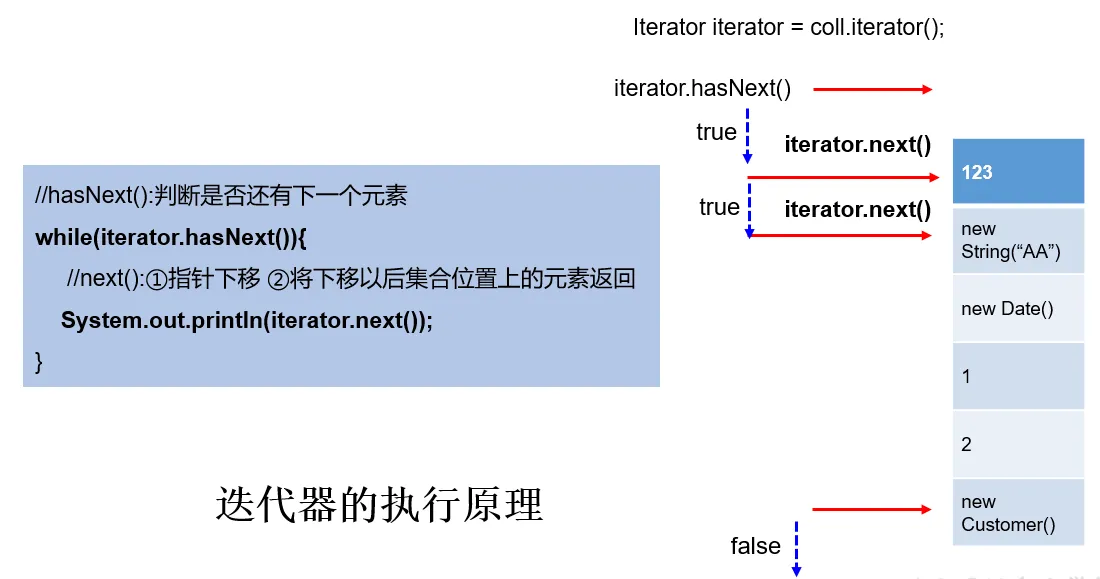
使用Iterator迭代器删除元素:java.util.Iterator迭代器中有一个方法:void remove() ;
Iterator iter = coll.iterator();//回到起点
while(iter.hasNext()){
    Object obj = iter.next();
    if(obj.equals("Tom")){
        iter.remove();
    }
}注意:
-
Iterator可以删除集合的元素,但是遍历过程中通过迭代器对象的remove方法,不是集合对象的remove方法。
-
如果还未调用next()或在上一次调用 next() 方法之后已经调用了 remove() 方法,再调用remove()都会报IllegalStateException。
-
Collection已经有remove(xx)方法了,为什么Iterator迭代器还要提供删除方法呢?因为迭代器的remove()可以按指定的条件进行删除。
例如:要删除以下集合元素中的偶数
import org.junit.Test;

import java.util.ArrayList;
import java.util.Collection;
import java.util.Iterator;

public class TestIteratorRemove {
    @Test
    public void test01(){
        Collection coll = new ArrayList();
        coll.add(1);
        coll.add(2);
        coll.add(3);
        coll.add(4);
        coll.add(5);
        coll.add(6);

        Iterator iterator = coll.iterator();
        while(iterator.hasNext()){
            Integer element = (Integer) iterator.next();
            if(element % 2 == 0){
                iterator.remove();
            }
        }
        System.out.println(coll);
    }
}在JDK8.0时,Collection接口有了removeIf 方法,即可以根据条件删除
import org.junit.Test;

import java.util.ArrayList;
import java.util.Collection;
import java.util.function.Predicate;

public class TestCollectionRemoveIf {
    @Test
    public void test01(){
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
        coll.add("佛地魔");
        System.out.println("coll = " + coll);

        coll.removeIf(new Predicate() {
            @Override
            public boolean test(Object o) {
                String str = (String) o;
                return str.contains("地");
            }
        });
        System.out.println("删除包含\"地\"字的元素之后coll = " + coll);
    }
}for-each 循环
foreach循环(也称增强for循环)是 JDK5.0 中定义的一个高级for循环,专门用来遍历数组和集合的。
foreach循环的语法格式:
for(元素的数据类型 局部变量 : Collection集合或数组){
          //操作局部变量的输出操作
}
//这里局部变量就是一个临时变量,自己命名就可以举例:
import org.junit.Test;

import java.util.ArrayList;
import java.util.Collection;

public class TestForeach {
    @Test
    public void test01(){
        Collection coll = new ArrayList();
        coll.add("小李广");
        coll.add("扫地僧");
        coll.add("石破天");
                //foreach循环其实就是使用Iterator迭代器来完成元素的遍历的。
        for (Object o : coll) {
            System.out.println(o);
        }
    }
    @Test
    public void test02(){
        int[] nums = {1,2,3,4,5};
        for (int num : nums) {
            System.out.println(num);
        }
        System.out.println("-----------------");
        String[] names = {"张三","李四","王五"};
        for (String name : names) {
            System.out.println(name);
        }
    }
}对于集合的遍历,增强for的内部原理其实是个Iterator迭代器。如下图。
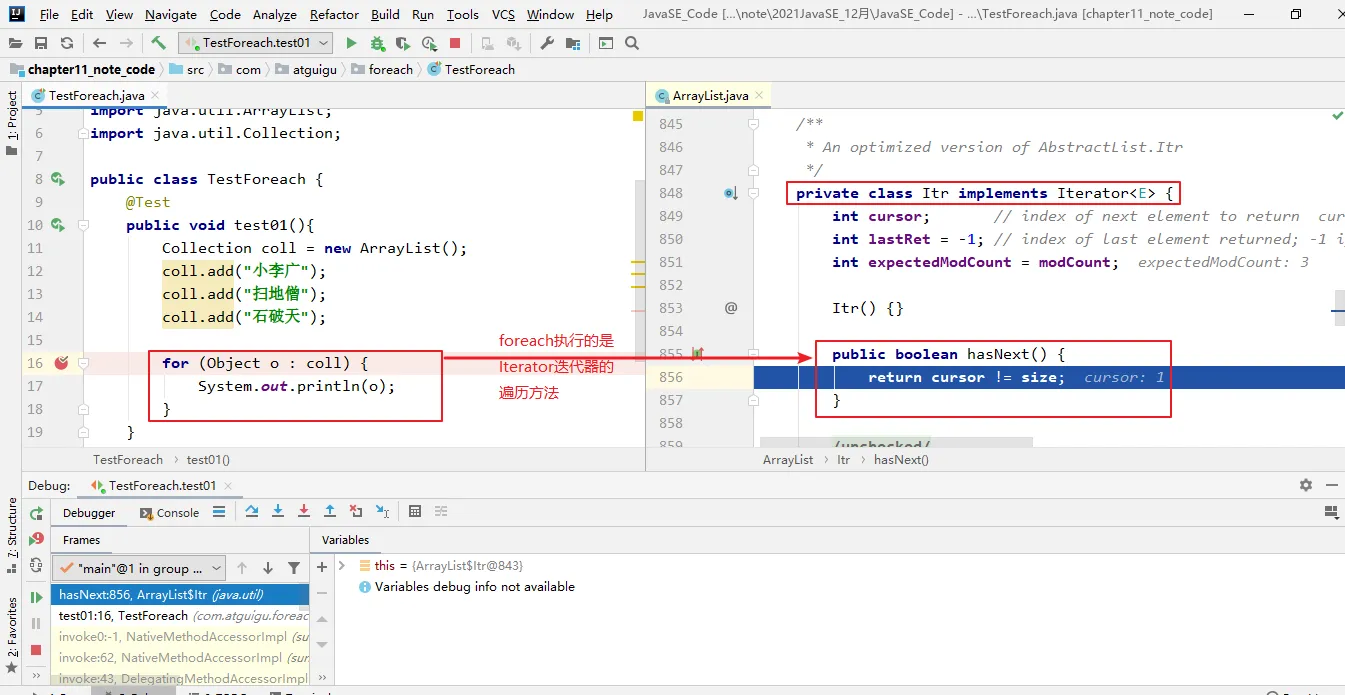
它用于遍历Collection和数组。通常只进行遍历元素,不要在遍历的过程中对集合元素进行增删操作。
练习:判断输出结果为何?
public class ForTest {
    public static void main(String[] args) {
        String[] str = new String[5];
        for (String myStr : str) {
            myStr = "atguigu";
            System.out.println(myStr);
        }
        for (int i = 0; i < str.length; i++) {
            System.out.println(str[i]);
        }
    }
}List
接口特点
鉴于Java中数组用来存储数据的局限性,我们通常使用java.util.List替代数组
List集合类中元素有序、且可重复,集合中的每个元素都有其对应的顺序索引。
举例:List集合存储数据,就像银行门口客服,给每一个来办理业务的客户分配序号:第一个来的是“张三”,客服给他分配的是0;第二个来的是“李四”,客服给他分配的1;以此类推,最后一个序号应该是“总人数-1”。
JDK API中List接口的实现类常用的有:ArrayList、LinkedList和Vector。
接口方法
List除了从Collection集合继承的方法外,List 集合里添加了一些根据索引来操作集合元素的方法。
-
插入元素
-
void add(int index, Object ele):在index位置插入ele元素 -
boolean addAll(int index, Collection eles):从index位置开始将eles中的所有元素添加进来
-
获取元素
-
Object get(int index):获取指定index位置的元素 -
List subList(int fromIndex, int toIndex):返回从fromIndex到toIndex位置的子集合
-
获取元素索引
-
int indexOf(Object obj):返回obj在集合中首次出现的位置
-
int lastIndexOf(Object obj):返回obj在当前集合中末次出现的位置
-
删除和替换元素
-
Object remove(int index):移除指定index位置的元素,并返回此元素 -
Object set(int index, Object ele):设置指定index位置的元素为ele
举例:
import java.util.ArrayList;
import java.util.List;

public class TestListMethod {
    public static void main(String[] args) {
        // 创建List集合对象
        List<String> list = new ArrayList<String>();

        // 往 尾部添加 指定元素
        list.add("图图");
        list.add("小美");
        list.add("不高兴");

        System.out.println(list);
        // add(int index,String s) 往指定位置添加
        list.add(1,"没头脑");

        System.out.println(list);
        // String remove(int index) 删除指定位置元素  返回被删除元素
        // 删除索引位置为2的元素
        System.out.println("删除索引位置为2的元素");
        System.out.println(list.remove(2));

        System.out.println(list);

        // String set(int index,String s)
        // 在指定位置 进行 元素替代(改)
        // 修改指定位置元素
        list.set(0, "三毛");
        System.out.println(list);

        // String get(int index)  获取指定位置元素
        // 跟size() 方法一起用  来 遍历的
        for(int i = 0;i<list.size();i++){
            System.out.println(list.get(i));
        }
        //还可以使用增强for
        for (String string : list) {
            System.out.println(string);
        }
    }
}注意:在JavaSE中List名称的类型有两个,一个是java.util.List集合接口,一个是java.awt.List图形界面的组件,别导错包了。
List接口主要实现类:
-
ArrayList
-
LinkedList
-
Vector
ArrayList
ArrayList 是 List 接口的主要实现类
本质上,ArrayList是对象引用的一个”变长”数组
Arrays.asList(…) 方法返回的 List 集合,既不是 ArrayList 实例,也不是 Vector 实例。 Arrays.asList(…) 返回值是一个固定长度的 List 集合
LinkedList
对于频繁的插入或删除元素的操作,建议使用LinkedList类,效率较高。这是由底层采用链表(双向链表)结构存储数据决定的。
特有方法:
-
void addFirst(Object obj)
-
void addLast(Object obj)
-
Object getFirst()
-
Object getLast()
-
Object removeFirst()
-
Object removeLast()
Vector
Vector 是一个古老的集合,JDK1.0就有了。大多数操作与ArrayList相同,区别之处在于Vector是线程安全的。
在各种List中,最好把ArrayList作为默认选择。当插入、删除频繁时,使用LinkedList;Vector总是比ArrayList慢,所以尽量避免使用。
特有方法:
-
void addElement(Object obj)
-
void insertElementAt(Object obj,int index)
-
void setElementAt(Object obj,int index)
-
void removeElement(Object obj)
-
void removeAllElements()
Set
Set接口是Collection的子接口,Set接口相较于Collection接口没有提供额外的方法
Set 集合不允许包含相同的元素,如果试把两个相同的元素加入同一个 Set 集合中,则添加操作失败。
Set集合支持的遍历方式和Collection集合一样:foreach和Iterator。
Set的常用实现类有:HashSet、TreeSet、LinkedHashSet。
HashSet
HashSet 是 Set 接口的主要实现类,大多数时候使用 Set 集合时都使用这个实现类。
HashSet 按 Hash 算法来存储集合中的元素,因此具有很好的存储、查找、删除性能。
HashSet 具有以下特点:
-
不能保证元素的排列顺序
-
HashSet 不是线程安全的
-
集合元素可以是 null
HashSet 集合判断两个元素相等的标准:两个对象通过 hashCode() 方法得到的哈希值相等,并且两个对象的 equals()方法返回值为true。
对于存放在Set容器中的对象,对应的类一定要重写hashCode()和equals(Object obj)方法,以实现对象相等规则。即:“相等的对象必须具有相等的散列码”。
HashSet集合中元素的无序性,不等同于随机性。这里的无序性与元素的添加位置有关。具体来说:我们在添加每一个元素到数组中时,具体的存储位置是由元素的hashCode()调用后返回的hash值决定的。导致在数组中每个元素不是依次紧密存放的,表现出一定的无序性。
HashSet中添加元素的过程:
-
当向 HashSet 集合中存入一个元素时,HashSet 会调用该对象的 hashCode() 方法得到该对象的 hashCode值,然后根据 hashCode值,通过某个散列函数决定该对象在 HashSet 底层数组中的存储位置。
-
如果要在数组中存储的位置上没有元素,则直接添加成功。
-
如果要在数组中存储的位置上有元素,则继续比较:
-
如果两个元素的hashCode值不相等,则添加成功;
-
如果两个元素的hashCode()值相等,则会继续调用equals()方法:
-
如果equals()方法结果为false,则添加成功。
-
如果equals()方法结果为true,则添加失败。
第2步添加成功,元素会保存在底层数组中。
第3步两种添加成功的操作,由于该底层数组的位置已经有元素了,则会通过
链表的方式继续链接,存储。
举例:
import java.util.Objects;

public class MyDate {
    private int year;
    private int month;
    private int day;

    public MyDate(int year, int month, int day) {
        this.year = year;
        this.month = month;
        this.day = day;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        MyDate myDate = (MyDate) o;
        return year == myDate.year &&
                month == myDate.month &&
                day == myDate.day;
    }

    @Override
    public int hashCode() {
        return Objects.hash(year, month, day);
    }

    @Override
    public String toString() {
        return "MyDate{" +
                "year=" + year +
                ", month=" + month +
                ", day=" + day +
                '}';
    }
}import org.junit.Test;
import java.util.HashSet;
public class TestHashSet {
@Test
public void test01(){
HashSet set = new HashSet();
set.add("张三");
set.add("张三");
set.add("李四");
set.add("王五");
set.add("王五");
set.add("赵六");
System.out.println("set = " + set);//不允许重复,无序
}
@Test
public void test02(){
HashSet set = new HashSet();
set.add(new MyDate(2021,1,1));
set.add(new MyDate(2021,1,1));
set.add(new MyDate(2022,2,4));
set.add(new MyDate(2022,2,4));
System.out.println("set = " + set);//不允许重复,无序
}
}重写 hashCode 方法的基本原则:
在程序运行时,同一个对象多次调用 hashCode() 方法应该返回相同的值。
当两个对象的 equals() 方法比较返回 true 时,这两个对象的 hashCode() 方法的返回值也应相等。
对象中用作 equals() 方法比较的 Field,都应该用来计算 hashCode 值。
注意:如果两个元素的 equals() 方法返回 true,但它们的 hashCode() 返回值不相等,hashSet 将会把它们存储在不同的位置,但依然可以添加成功。
重写equals方法的基本原则:
重写equals方法的时候一般都需要同时复写hashCode方法。通常参与计算hashCode的对象的属性也应该参与到equals()中进行计算。
推荐:开发中直接调用Eclipse/IDEA里的快捷键自动重写equals()和hashCode()方法即可。
为什么用Eclipse/IDEA复写hashCode方法,有31这个数字?
首先,选择系数的时候要选择尽量大的系数。因为如果计算出来的hash地址越大,所谓的“冲突”就越少,查找起来效率也会提高。(减少冲突)

其次,31只占用5bits,相乘造成数据溢出的概率较小。

再次,31可以 由i*31== (i<<5)-1来表示,现在很多虚拟机里面都有做相关优化。(提高算法效率)

最后,31是一个素数,素数作用就是如果我用一个数字来乘以这个素数,那么最终出来的结果只能被素数本身和被乘数还有1来整除!(减少冲突)LinkedHashSet
LinkedHashSet 是 HashSet 的子类,不允许集合元素重复。
LinkedHashSet 根据元素的 hashCode 值来决定元素的存储位置,但它同时使用双向链表维护元素的次序,这使得元素看起来是以添加顺序保存的。
LinkedHashSet插入性能略低于 HashSet,但在迭代访问 Set 里的全部元素时有很好的性能。
举例:
import org.junit.Test;

import java.util.LinkedHashSet;

public class TestLinkedHashSet {
    @Test
    public void test01(){
        LinkedHashSet set = new LinkedHashSet();
        set.add("张三");
        set.add("张三");
        set.add("李四");
        set.add("王五");
        set.add("王五");
        set.add("赵六");

        System.out.println("set = " + set);//不允许重复,体现添加顺序
    }
}TreeSet
TreeSet 是 SortedSet 接口的实现类,TreeSet 可以按照添加的元素的指定的属性的大小顺序进行遍历。
TreeSet底层使用红黑树结构存储数据
新增的方法如下: (了解)
-
Comparator comparator()
-
Object first()
-
Object last()
-
Object lower(Object e)
-
Object higher(Object e)
-
SortedSet subSet(fromElement, toElement)
-
SortedSet headSet(toElement)
-
SortedSet tailSet(fromElement)
TreeSet特点:不允许重复、实现排序(自然排序或定制排序)
TreeSet 两种排序方法:自然排序和定制排序。默认情况下,TreeSet 采用自然排序。
-
自然排序:TreeSet 会调用集合元素的 compareTo(Object obj) 方法来比较元素之间的大小关系,然后将集合元素按升序(默认情况)排列。 -
如果试图把一个对象添加到 TreeSet 时,则该对象的类必须实现 Comparable 接口。
-
实现 Comparable 的类必须实现 compareTo(Object obj) 方法,两个对象即通过 compareTo(Object obj) 方法的返回值来比较大小。
-
定制排序:如果元素所属的类没有实现Comparable接口,或不希望按照升序(默认情况)的方式排列元素或希望按照其它属性大小进行排序,则考虑使用定制排序。定制排序,通过Comparator接口来实现。需要重写compare(T o1,T o2)方法。 -
利用int compare(T o1,T o2)方法,比较o1和o2的大小:如果方法返回正整数,则表示o1大于o2;如果返回0,表示相等;返回负整数,表示o1小于o2。
-
要实现定制排序,需要将实现Comparator接口的实例作为形参传递给TreeSet的构造器。
因为只有相同类的两个实例才会比较大小,所以向 TreeSet 中添加的应该是同一个类的对象。
对于 TreeSet 集合而言,它判断两个对象是否相等的唯一标准是:两个对象通过 compareTo(Object obj) 或compare(Object o1,Object o2)方法比较返回值。返回值为0,则认为两个对象相等。
Map接口
现实生活与开发中,我们常会看到这样的一类集合:用户ID与账户信息、学生姓名与考试成绩、IP地址与主机名等,这种一一对应的关系,就称作映射。Java提供了专门的集合框架用来存储这种映射关系的对象,即java.util.Map接口
Map与Collection并列存在。用于保存具有映射关系的数据:key-value
-
Collection集合称为单列集合,元素是孤立存在的(理解为单身)。 -
Map集合称为双列集合,元素是成对存在的(理解为夫妻)。
Map 中的 key 和 value 都可以是任何引用类型的数据。但常用String类作为Map的“键”。
Map接口的常用实现类:HashMap、LinkedHashMap、TreeMap和Properties。其中HashMap 是Map接口使用频率最高的实现类。
Map中 key-value特点
这里主要以HashMap为例说明。HashMap中存储的key、value的特点如下:
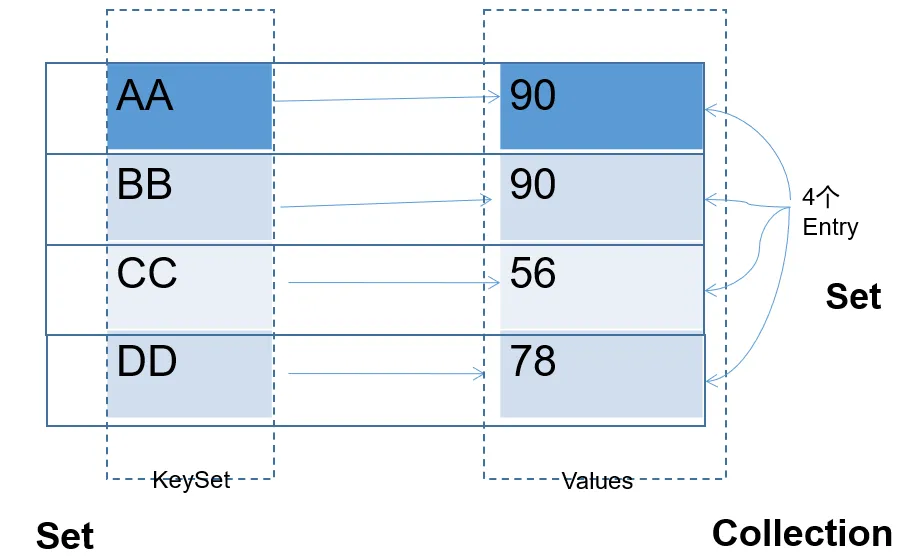
Map 中的 key用Set来存放,不允许重复,即同一个 Map 对象所对应的类,须重写hashCode()和equals()方法
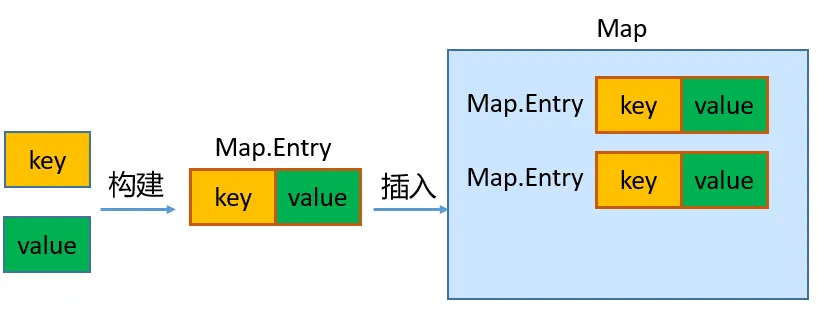
key 和 value 之间存在单向一对一关系,即通过指定的 key 总能找到唯一的、确定的 value,不同key对应的value可以重复。value所在的类要重写equals()方法。
key和value构成一个entry。所有的entry彼此之间是无序的、不可重复的。
Map 接口的常用方法
-
添加、修改操作:
-
Object put(Object key,Object value):将指定key-value添加到(或修改)当前map对象中
-
void putAll(Map m):将m中的所有key-value对存放到当前map中
-
删除操作:
-
Object remove(Object key):移除指定key的key-value对,并返回value
-
void clear():清空当前map中的所有数据
-
元素查询的操作:
-
Object get(Object key):获取指定key对应的value
-
boolean containsKey(Object key):是否包含指定的key
-
boolean containsValue(Object value):是否包含指定的value
-
int size():返回map中key-value对的个数
-
boolean isEmpty():判断当前map是否为空
-
boolean equals(Object obj):判断当前map和参数对象obj是否相等
-
元视图操作的方法:
-
Set keySet():返回所有key构成的Set集合
-
Collection values():返回所有value构成的Collection集合
-
Set entrySet():返回所有key-value对构成的Set集合
举例:
import java.util.HashMap;

public class TestMapMethod {
    public static void main(String[] args) {
        //创建 map对象
        HashMap map = new HashMap();

        //添加元素到集合
        map.put("黄晓明", "杨颖");
        map.put("李晨", "李小璐");
        map.put("李晨", "范冰冰");
        map.put("邓超", "孙俪");
        System.out.println(map);

        //删除指定的key-value
        System.out.println(map.remove("黄晓明"));
        System.out.println(map);

        //查询指定key对应的value
        System.out.println(map.get("邓超"));
        System.out.println(map.get("黄晓明"));

    }
}HashMap
HashMap是 Map 接口使用频率最高的实现类。
HashMap是线程不安全的。允许添加 null 键和 null 值。
存储数据采用的哈希表结构,底层使用一维数组+单向链表+红黑树进行key-value数据的存储。与HashSet一样,元素的存取顺序不能保证一致。
HashMap 判断两个key相等的标准是:两个 key 的hashCode值相等,通过 equals() 方法返回 true。
HashMap 判断两个value相等的标准是:两个 value 通过 equals() 方法返回 true。
LinkedHashMap
LinkedHashMap 是 HashMap 的子类
存储数据采用的哈希表结构+链表结构,在HashMap存储结构的基础上,使用了一对双向链表来记录添加元素的先后顺序,可以保证遍历元素时,与添加的顺序一致。
通过哈希表结构可以保证键的唯一、不重复,需要键所在类重写hashCode()方法、equals()方法。
public class TestLinkedHashMap {
    public static void main(String[] args) {
        LinkedHashMap map = new LinkedHashMap();
        map.put("王五", 13000.0);
        map.put("张三", 10000.0);
        //key相同,新的value会覆盖原来的value
        //因为String重写了hashCode和equals方法
        map.put("张三", 12000.0);
        map.put("李四", 14000.0);
        //HashMap支持key和value为null值
        String name = null;
        Double salary = null;
        map.put(name, salary);

        Set entrySet = map.entrySet();
        for (Object obj : entrySet) {
                Map.Entry entry = (Map.Entry)obj;
            System.out.println(entry);
        }
    }
}TreeMap
TreeMap存储 key-value 对时,需要根据 key-value 对进行排序。TreeMap 可以保证所有的 key-value 对处于有序状态。
TreeSet底层使用红黑树结构存储数据
TreeMap 的 Key 的排序:
-
自然排序:TreeMap 的所有的 Key 必须实现 Comparable 接口,而且所有的 Key 应该是同一个类的对象,否则将会抛出 ClasssCastException -
定制排序:创建 TreeMap 时,构造器传入一个 Comparator 对象,该对象负责对 TreeMap 中的所有 key 进行排序。此时不需要 Map 的 Key 实现 Comparable 接口
TreeMap判断两个key相等的标准:两个key通过compareTo()方法或者compare()方法返回0。
public class TestTreeMap {
    /*
    * 自然排序举例
    * */
    @Test
    public void test1(){
        TreeMap map = new TreeMap();

        map.put("CC",45);
        map.put("MM",78);
        map.put("DD",56);
        map.put("GG",89);
        map.put("JJ",99);

        Set entrySet = map.entrySet();
        for(Object entry : entrySet){
            System.out.println(entry);
        }

    }

    /*
    * 定制排序
    *
    * */
    @Test
    public void test2(){
        //按照User的姓名的从小到大的顺序排列

        TreeMap map = new TreeMap(new Comparator() {
            @Override
            public int compare(Object o1, Object o2) {
                if(o1 instanceof User && o2 instanceof User){
                    User u1 = (User)o1;
                    User u2 = (User)o2;

                    return u1.name.compareTo(u2.name);
                }
                throw new RuntimeException("输入的类型不匹配");
            }
        });

        map.put(new User("Tom",12),67);
        map.put(new User("Rose",23),"87");
        map.put(new User("Jerry",2),88);
        map.put(new User("Eric",18),45);
        map.put(new User("Tommy",44),77);
        map.put(new User("Jim",23),88);
        map.put(new User("Maria",18),34);

        Set entrySet = map.entrySet();
        for(Object entry : entrySet){
            System.out.println(entry);
        }
    }
}

class User implements Comparable{
    String name;
    int age;

    public User(String name, int age) {
        this.name = name;
        this.age = age;
    }

    public User() {
    }

    @Override
    public String toString() {
        return "User{" +
                "name='" + name + '\'' +
                ", age=" + age +
                '}';
    }
    /*
    举例:按照age从小到大的顺序排列,如果age相同,则按照name从大到小的顺序排列
    * */
    @Override
    public int compareTo(Object o) {
        if(this == o){
            return 0;
        }

        if(o instanceof User){
            User user = (User)o;
            int value = this.age - user.age;
            if(value != 0){
                return value;
            }
            return -this.name.compareTo(user.name);
        }
        throw new RuntimeException("输入的类型不匹配");
    }
}HashTable
Hashtable是Map接口的古老实现类,JDK1.0就提供了。不同于HashMap,Hashtable是线程安全的。
Hashtable实现原理和HashMap相同,功能相同。底层都使用哈希表结构(数组+单向链表),查询速度快。
与HashMap一样,Hashtable 也不能保证其中 Key-Value 对的顺序
Hashtable判断两个key相等、两个value相等的标准,与HashMap一致。
与HashMap不同,Hashtable 不允许使用 null 作为 key 或 value。
面试题:Hashtable和HashMap的区别
HashMap:底层是一个哈希表(jdk7:数组+链表;jdk8:数组+链表+红黑树),是一个线程不安全的集合,执行效率高
Hashtable:底层也是一个哈希表(数组+链表),是一个线程安全的集合,执行效率低

HashMap集合:可以存储null的键、null的值
Hashtable集合,不能存储null的键、null的值

Hashtable和Vector集合一样,在jdk1.2版本之后被更先进的集合(HashMap,ArrayList)取代了。所以HashMap是Map的主要实现类,Hashtable是Map的古老实现类。

Hashtable的子类Properties(配置文件)依然活跃在历史舞台
Properties集合是一个唯一和IO流相结合的集合Properties
Properties 类是 Hashtable 的子类,该对象用于处理属性文件
由于属性文件里的 key、value 都是字符串类型,所以 Properties 中要求 key 和 value 都是字符串类型
存取数据时,建议使用setProperty(String key,String value)方法和getProperty(String key)方法
@Test
public void test01() {
    Properties properties = System.getProperties();
    String fileEncoding = properties.getProperty("file.encoding");//当前源文件字符编码
    System.out.println("fileEncoding = " + fileEncoding);
}
@Test
public void test02() {
    Properties properties = new Properties();
    properties.setProperty("user","songhk");
    properties.setProperty("password","123456");
    System.out.println(properties);
}

@Test
public void test03() throws IOException {
    Properties pros = new Properties();
    pros.load(new FileInputStream("jdbc.properties"));
    String user = pros.getProperty("user");
    System.out.println(user);
}Collection工具类
参考操作数组的工具类:Arrays,Collections 是一个操作 Set、List 和 Map 等集合的工具类。
常用方法
Collections 中提供了一系列静态的方法对集合元素进行排序、查询和修改等操作,还提供了对集合对象设置不可变、对集合对象实现同步控制等方法(均为static方法):
排序操作:
-
reverse(List):反转 List 中元素的顺序
-
shuffle(List):对 List 集合元素进行随机排序
-
sort(List):根据元素的自然顺序对指定 List 集合元素按升序排序
-
sort(List,Comparator):根据指定的 Comparator 产生的顺序对 List 集合元素进行排序
-
swap(List,int, int):将指定 list 集合中的 i 处元素和 j 处元素进行交换
查找
-
Object max(Collection):根据元素的自然顺序,返回给定集合中的最大元素
-
Object max(Collection,Comparator):根据 Comparator 指定的顺序,返回给定集合中的最大元素
-
Object min(Collection):根据元素的自然顺序,返回给定集合中的最小元素
-
Object min(Collection,Comparator):根据 Comparator 指定的顺序,返回给定集合中的最小元素
-
int binarySearch(List list,T key)在List集合中查找某个元素的下标,但是List的元素必须是T或T的子类对象,而且必须是可比较大小的,即支持自然排序的。而且集合也事先必须是有序的,否则结果不确定。
-
int binarySearch(List list,T key,Comparator c)在List集合中查找某个元素的下标,但是List的元素必须是T或T的子类对象,而且集合也事先必须是按照c比较器规则进行排序过的,否则结果不确定。
-
int frequency(Collection c,Object o):返回指定集合中指定元素的出现次数
复制、替换
-
void copy(List dest,List src):将src中的内容复制到dest中
-
boolean replaceAll(List list,Object oldVal,Object newVal):使用新值替换 List 对象的所有旧值
-
提供了多个unmodifiableXxx()方法,该方法返回指定 Xxx的不可修改的视图。
添加
- boolean addAll(Collection c,T... elements)将所有指定元素添加到指定 collection 中。
同步
- Collections 类中提供了多个 synchronizedXxx() 方法,该方法可使将指定集合包装成线程同步的集合,从而可以解决多线程并发访问集合时的线程安全问题:
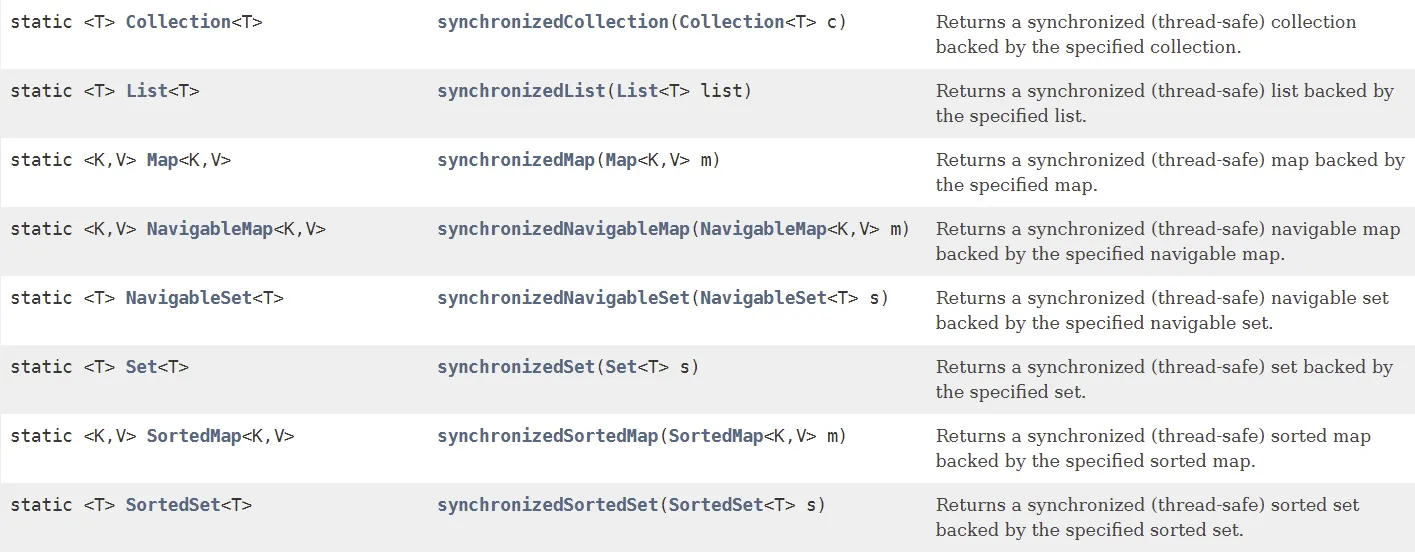
泛型
在Java中,我们在声明方法时,当在完成方法功能时如果有未知的数据需要参与,这些未知的数据需要在调用方法时才能确定,那么我们把这样的数据通过形参表示。在方法体中,用这个形参名来代表那个未知的数据,而调用者在调用时,对应的传入实参就可以了。
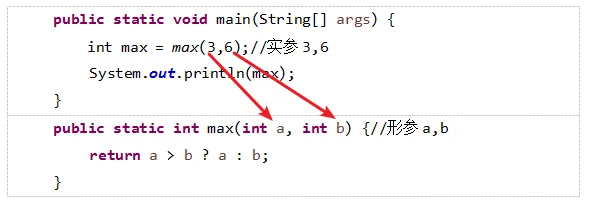
受以上启发,JDK1.5设计了泛型的概念。泛型即为“类型参数”,这个类型参数在声明它的类、接口或方法中,代表未知的某种通用类型。
举例 1:
集合类在设计阶段/声明阶段不能确定这个容器到底实际存的是什么类型的对象,所以在JDK5.0之前只能把元素类型设计为Object,JDK5.0时Java引入了“参数化类型(Parameterized type)”的概念,允许我们在创建集合时指定集合元素的类型。比如:List<String>,这表明该List只能保存字符串类型的对象。
使用集合存储数据时,除了元素的类型不确定,其他部分是确定的(例如关于这个元素如何保存,如何管理等)。
举例 2:
java.lang.Comparable接口和java.util.Comparator接口,是用于比较对象大小的接口。这两个接口只是限定了当一个对象大于另一个对象时返回正整数,小于返回负整数,等于返回0,但是并不确定是什么类型的对象比较大小。JDK5.0之前只能用Object类型表示,使用时既麻烦又不安全,因此 JDK5.0 给它们增加了泛型。
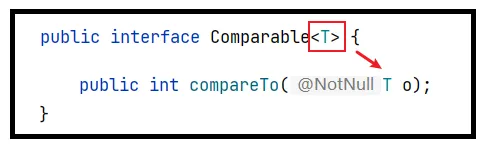
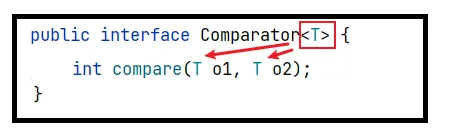
其中<T>就是类型参数,即泛型。
所谓泛型,就是允许在定义类、接口时通过一个
标识表示类中某个属性的类型或者是某个方法的返回值或参数的类型。这个类型参数将在使用时(例如,继承或实现这个接口、创建对象或调用方法时)确定(即传入实际的类型参数,也称为类型实参)。
使用泛型举例
自从JDK5.0引入泛型的概念之后,对之前核心类库中的API做了很大的修改,例如:JDK5.0改写了集合框架中的全部接口和类、java.lang.Comparable接口、java.util.Comparator接口、Class类等。为这些接口、类增加了泛型支持,从而可以在声明变量、创建对象时传入类型实参。
集合中使用泛型
集合中没有使用泛型时:
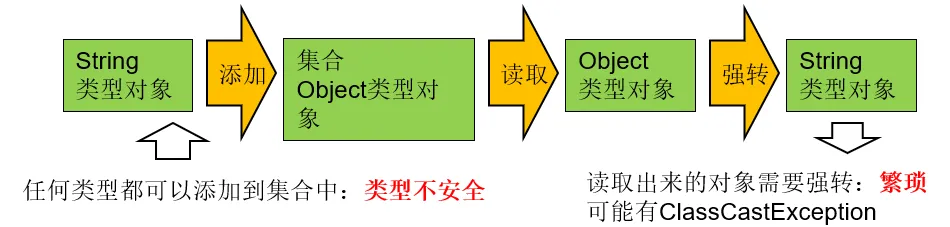
集合中使用泛型时:
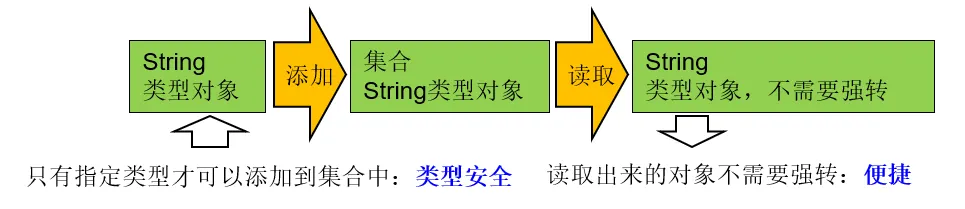
Java泛型可以保证如果程序在编译时没有发出警告,运行时就不会产生ClassCastException异常。即,把不安全的因素在编译期间就排除了,而不是运行期;既然通过了编译,那么类型一定是符合要求的,就避免了类型转换。
同时,代码更加简洁、健壮。
把一个集合中的内容限制为一个特定的数据类型,这就是generic背后的核心思想。
举例:
//泛型在List中的使用
@Test
public void test1(){
    //举例:将学生成绩保存在ArrayList中
    //标准写法:
    //ArrayList<Integer> list = new ArrayList<Integer>();
    //jdk7的新特性:类型推断
    ArrayList<Integer> list = new ArrayList<>();

    list.add(56); //自动装箱
    list.add(76);
    list.add(88);
    list.add(89);
    //当添加非Integer类型数据时,编译不通过
    //list.add("Tom");//编译报错

    Iterator<Integer> iterator = list.iterator();
    while(iterator.hasNext()){
        //不需要强转,直接可以获取添加时的元素的数据类型
        Integer score = iterator.next();
        System.out.println(score);
    }
}比较器中使用泛型
举例:
public class Circle{
    private double radius;

    public Circle(double radius) {
        super();
        this.radius = radius;
    }

    public double getRadius() {
        return radius;
    }

    public void setRadius(double radius) {
        this.radius = radius;
    }

    @Override
    public String toString() {
        return "Circle [radius=" + radius + "]";
    }

}使用泛型之前:
import java.util.Comparator;

class CircleComparator implements Comparator{
    @Override
    public int compare(Object o1, Object o2) {
        //强制类型转换
        Circle c1 = (Circle) o1;
        Circle c2 = (Circle) o2;
        return Double.compare(c1.getRadius(), c2.getRadius());
    }
}
//测试:
public class TestNoGeneric {
    public static void main(String[] args) {
        CircleComparator com = new CircleComparator();
        System.out.println(com.compare(new Circle(1), new Circle(2)));

        System.out.println(com.compare("圆1", "圆2"));//运行时异常:ClassCastException
    }
}使用泛型之后:
import java.util.Comparator;

class CircleComparator1 implements Comparator<Circle> {

    @Override
    public int compare(Circle o1, Circle o2) {
        //不再需要强制类型转换,代码更简洁
        return Double.compare(o1.getRadius(), o2.getRadius());
    }
}

//测试类
public class TestHasGeneric {
    public static void main(String[] args) {
        CircleComparator1 com = new CircleComparator1();
        System.out.println(com.compare(new Circle(1), new Circle(2)));

        //System.out.println(com.compare("圆1", "圆2"));
        //编译错误,因为"圆1", "圆2"不是Circle类型,是String类型,编译器提前报错,
        //而不是冒着风险在运行时再报错。
    }
}使用说明:
-
在创建集合对象的时候,可以指明泛型的类型。具体格式为:List list = new ArrayList();
-
JDK7.0时,有新特性,可以简写为:
List list = new ArrayList<>(); //类型推断 -
泛型,也称为泛型参数,即参数的类型,只能使用引用数据类型进行赋值。(不能使用基本数据类型,可以使用包装类替换)
-
集合声明时,声明泛型参数。在使用集合时,可以具体指明泛型的类型。一旦指明,类或接口内部,凡是使用泛型参数的位置,都指定为具体的参数类型。如果没有指明的话,看做是Object类型。
自定义泛型结构
1、<类型>这种语法形式就叫泛型。
<类型>的形式称为类型参数,这里的"类型"习惯上使用T表示,是Type的缩写。即:代表未知的数据类型
类比方法的参数的概念,我们把,称为类型形参,将称为类型实参,有助于我们理解泛型
这里的T,可以替换成K,V等任意字母。
2、在哪里可以声明类型变量
声明类或接口时,在类名或接口名后面声明泛型类型,这样的类或接口称为泛型类或泛型接口。
【修饰符】 class 类名<类型变量列表> 【extends 父类】 【implements 接口们】{

}
【修饰符】 interface 接口名<类型变量列表> 【implements 接口们】{

}

//例如:
public class ArrayList<E>
public interface Map<K,V>{
    ....
}声明方法时,在【修饰符】与返回值类型之间声明类型变量,我们把声明了类型变量的方法,称为泛型方法。
[修饰符] <类型变量列表> 返回值类型 方法名([形参列表])[throws 异常列表]{
    //...
}

//例如:java.util.Arrays类中的
public static <T> List<T> asList(T... a){
    ....
}自定义泛型类或泛型接口
当我们在类或接口中定义某个成员时,该成员的相关类型是不确定的,而这个类型需要在使用这个类或接口时才可以确定,那么我们可以使用泛型类、泛型接口。
-
我们在声明完自定义泛型类以后,可以在类的内部(比如:属性、方法、构造器中)使用类的泛型。
-
我们在创建自定义泛型类的对象时,可以指明泛型参数类型。一旦指明,内部凡是使用类的泛型参数的位置,都具体化为指定的类的泛型类型。
-
如果在创建自定义泛型类的对象时,没有指明泛型参数类型,那么泛型将被擦除,泛型对应的类型均按照Object处理,但不等价于Object。
-
经验:泛型要使用一路都用。要不用,一路都不要用。
-
泛型的指定中必须使用引用数据类型。不能使用基本数据类型,此时只能使用包装类替换。
-
除创建泛型类对象外,子类继承泛型类时、实现类实现泛型接口时,也可以确定泛型结构中的泛型参数。
如果我们在给泛型类提供子类时,子类也不确定泛型的类型,则可以继续使用泛型参数。
我们还可以在现有的父类的泛型参数的基础上,新增泛型参数。
注意:
-
泛型类可能有多个参数,此时应将多个参数一起放在尖括号内。比如:<E1,E2,E3>
-
JDK7.0 开始,泛型的简化操作:ArrayList flist = new ArrayList<>();
-
如果泛型结构是一个接口或抽象类,则不可创建泛型类的对象。
-
不能使用new E[]。但是可以:E[] elements = (E[])new Object[capacity];
text参考:ArrayList源码中声明:Object[] elementData,而非泛型参数类型数组。 -
在类/接口上声明的泛型,在本类或本接口中即代表某种类型,但不可以在静态方法中使用类的泛型。
-
异常类不能是带泛型的。
举例:
class Person<T> {
    // 使用T类型定义变量
    private T info;
    // 使用T类型定义一般方法
    public T getInfo() {
        return info;
    }
    public void setInfo(T info) {
        this.info = info;
    }
    // 使用T类型定义构造器
    public Person() {
    }
    public Person(T info) {
        this.info = info;
    }
    // static的方法中不能声明泛型
    //public static void show(T t) {
    //
    //}
    // 不能在try-catch中使用泛型定义
    //public void test() {
        //try {
        //
        //} catch (MyException<T> ex) {
        //
        //}
    //}
}自定义泛型方法
如果我们定义类、接口时没有使用<泛型参数>,但是某个方法形参类型不确定时,这个方法可以单独定义<泛型参数>
泛型方法格式:
[访问权限]  <泛型>  返回值类型  方法名([泛型标识 参数名称])  [抛出的异常]{

}举例
public class DAO {

    public <E> E get(int id, E e) {

        E result = null;

        return result;
    }
}泛型在继承上的体现
如果B是A的一个子类型(子类或者子接口),而G是具有泛型声明的类或接口,G并不是G的子类型!
比如:String是Object的子类,但是List并不是List
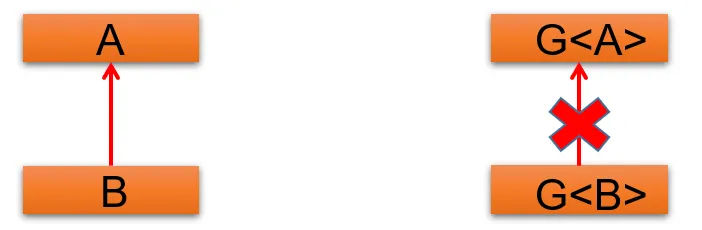
public void testGenericAndSubClass() {
    Person[] persons = null;
    Man[] mans = null;
    //Person[] 是 Man[] 的父类
    persons = mans;

    Person p = mans[0];

    // 在泛型的集合上
    List<Person> personList = null;
    List<Man> manList = null;
    //personList = manList;(报错)
}思考:对比如下两段代码有何不同:
片段1:
public void printCollection(Collection c) {
    Iterator i = c.iterator();
    for (int k = 0; k < c.size(); k++) {
        System.out.println(i.next());
    }
}片段2:
public void printCollection(Collection<Object> c) {
    for (Object e : c) {
        System.out.println(e);
    }
}通配符
当我们声明一个变量/形参时,这个变量/形参的类型是一个泛型类或泛型接口,例如:Comparator类型,但是我们仍然无法确定这个泛型类或泛型接口的类型变量的具体类型,此时我们考虑使用类型通配符?
使用类型通配符:?
比如:List<?>,Map<?,?>
List<?>是List<String>、List<Object>等各种泛型List的父类。
写操作
将任意元素加入到其中不是类型安全的:
Collection<?> c = new ArrayList<String>();

c.add(new Object()); // 编译时错误因为我们不知道c的元素类型,我们不能向其中添加对象。add方法有类型参数E作为集合的元素类型。我们传给add的任何参数都必须是一个未知类型的子类。因为我们不知道那是什么类型,所以我们无法传任何东西进去。
唯一可以插入的元素是null,因为它是所有引用类型的默认值。
读操作
另一方面,读取List<?>的对象list中的元素时,永远是安全的,因为不管 list 的真实类型是什么,它包含的都是Object。
public class TestWildcard {
public static void m4(Collection<?> coll){
for (Object o : coll) {
System.out.println(o);
}
}
}注意点:
注意点1:编译错误:不能用在泛型方法声明上,返回值类型前面<>不能使用?
public static <?> void test(ArrayList<?> list){
}注意点2:编译错误:不能用在泛型类的声明上
class GenericTypeClass<?>{
}注意点3:编译错误:不能用在创建对象上,右边属于创建集合对象
ArrayList<?> list2 = new ArrayList<?>();通配符的限制
<?>:允许所有泛型的引用调用
通配符指定上限:<? extends 类/接口 >:使用时指定的类型必须是继承某个类,或者实现某个接口,即<=
通配符指定下限:<? super 类/接口 >:使用时指定的类型必须是操作的类或接口,或者是操作的类的父类或接口的父接口,即>=
<? extends Number> //(无穷小 , Number]
//只允许泛型为Number及Number子类的引用调用
<? super Number> //[Number , 无穷大)
//只允许泛型为Number及Number父类的引用调用
<? extends Comparable>
//只允许泛型为实现Comparable接口的实现类的引用调用class Creature{}
class Person extends Creature{}
class Man extends Person{}
class PersonTest {
public static <T extends Person> void test(T t){
System.out.println(t);
}
public static void main(String[] args) {
test(new Person());
test(new Man());
//The method test(T) in the type PersonTest is not
//applicable for the arguments (Creature)
test(new Creature());
}
}File类和IO流
java.io.File类的使用
File类及下面的各种流,都定义在java.io包下。
一个File对象代表硬盘或网络中可能存在的一个文件或者文件目录(俗称文件夹),与平台无关。(体会万事万物皆对象)
File 能新建、删除、重命名文件和目录,但 File 不能访问文件内容本身。如果需要访问文件内容本身,则需要使用输入/输出流。 File对象可以作为参数传递给流的构造器。
想要在Java程序中表示一个真实存在的文件或目录,那么必须有一个File对象,但是Java程序中的一个File对象,可能没有一个真实存在的文件或目录。
构造器
-
public File(String pathname):以pathname为路径创建File对象,可以是绝对路径或者相对路径,如果pathname是相对路径,则默认的当前路径在系统属性user.dir中存储。 -
public File(String parent, String child):以parent为父路径,child为子路径创建File对象。 -
public File(File parent, String child):根据一个父File对象和子文件路径创建File对象
关于路径:
-
**绝对路径:**从盘符开始的路径,这是一个完整的路径。
-
**相对路径:**相对于
项目目录的路径,这是一个便捷的路径,开发中经常使用。 -
IDEA中,main中的文件的相对路径,是相对于"
当前工程" -
IDEA中,单元测试方法中的文件的相对路径,是相对于"
当前module"
举例:
import java.io.File;
public class FileObjectTest {
public static void main(String[] args) {
// 文件路径名
String pathname = "D:\\aaa.txt";
File file1 = new File(pathname);
// 文件路径名
String pathname2 = "D:\\aaa\\bbb.txt";
File file2 = new File(pathname2);
// 通过父路径和子路径字符串
String parent = "d:\\aaa";
String child = "bbb.txt";
File file3 = new File(parent, child);
// 通过父级File对象和子路径字符串
File parentDir = new File("d:\\aaa");
String childFile = "bbb.txt";
File file4 = new File(parentDir, childFile);
}
@Test
public void test01() throws IOException{
File f1 = new File("d:\\atguigu\\javase\\HelloIO.java"); //绝对路径
System.out.println("文件/目录的名称:" + f1.getName());
System.out.println("文件/目录的构造路径名:" + f1.getPath());
System.out.println("文件/目录的绝对路径名:" + f1.getAbsolutePath());
System.out.println("文件/目录的父目录名:" + f1.getParent());
}
@Test
public void test02()throws IOException{
File f2 = new File("/HelloIO.java");//绝对路径,从根路径开始
System.out.println("文件/目录的名称:" + f2.getName());
System.out.println("文件/目录的构造路径名:" + f2.getPath());
System.out.println("文件/目录的绝对路径名:" + f2.getAbsolutePath());
System.out.println("文件/目录的父目录名:" + f2.getParent());
}
@Test
public void test03() throws IOException {
File f3 = new File("HelloIO.java");//相对路径
System.out.println("user.dir =" + System.getProperty("user.dir"));
System.out.println("文件/目录的名称:" + f3.getName());
System.out.println("文件/目录的构造路径名:" + f3.getPath());
System.out.println("文件/目录的绝对路径名:" + f3.getAbsolutePath());
System.out.println("文件/目录的父目录名:" + f3.getParent());
}
@Test
public void test04() throws IOException{
File f5 = new File("HelloIO.java");//相对路径
System.out.println("user.dir =" + System.getProperty("user.dir"));
System.out.println("文件/目录的名称:" + f5.getName());
System.out.println("文件/目录的构造路径名:" + f5.getPath());
System.out.println("文件/目录的绝对路径名:" + f5.getAbsolutePath());
System.out.println("文件/目录的父目录名:" + f5.getParent());
}
}注意:
无论该路径下是否存在文件或者目录,都不影响File对象的创建。
window的路径分隔符使用“\”,而Java程序中的“\”表示转义字符,所以在Windows中表示路径,需要用“\”。或者直接使用“/”也可以,Java程序支持将“/”当成平台无关的
路径分隔符。或者直接使用File.separator常量值表示。比如: File file2 = new File("d:" + File.separator + "atguigu" + File.separator + "info.txt");当构造路径是绝对路径时,那么getPath和getAbsolutePath结果一样 当构造路径是相对路径时,那么getAbsolutePath的路径 = user.dir的路径 + 构造路径
常见方法
获取文件和目录的基本信息:
-
public String getName():获取名称 -
public String getPath():获取路径 -
public String getAbsolutePath():获取绝对路径 -
public File getAbsoluteFile():获取绝对路径表示的文件 -
public String getParent():获取上层文件目录路径。若无,返回null -
public long length():获取文件长度(即:字节数)。不能获取目录的长度。 -
public long lastModified():获取最后一次的修改时间,毫秒值
如果File对象代表的文件或目录存在,则File对象实例初始化时,就会用硬盘中对应文件或目录的属性信息(例如,时间、类型等)为File对象的属性赋值,否则除了路径和名称,File对象的其他属性将会保留默认值。
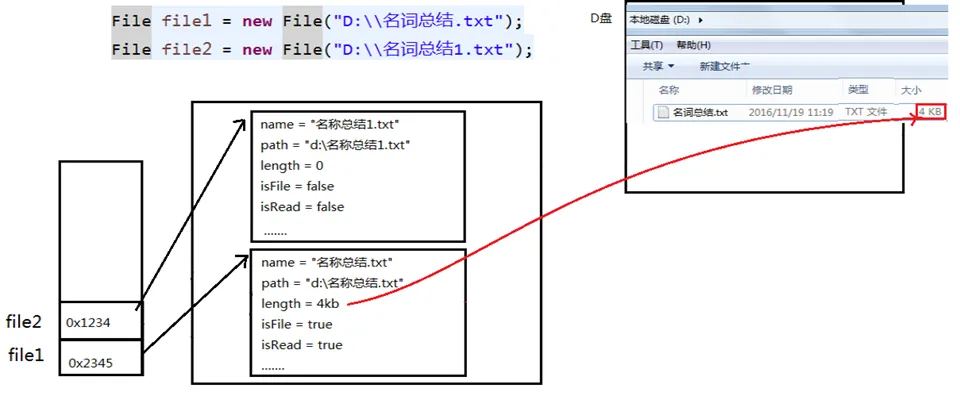
举例:
import java.io.File;
import java.time.Instant;
import java.time.LocalDateTime;
import java.time.ZoneId;
public class FileInfoMethod {
public static void main(String[] args) {
File f = new File("d:/aaa/bbb.txt");
System.out.println("文件构造路径:"+f.getPath());
System.out.println("文件名称:"+f.getName());
System.out.println("文件长度:"+f.length()+"字节");
System.out.println("文件最后修改时间:" + LocalDateTime.ofInstant(Instant.ofEpochMilli(f.lastModified()),ZoneId.of("Asia/Shanghai")));
File f2 = new File("d:/aaa");
System.out.println("目录构造路径:"+f2.getPath());
System.out.println("目录名称:"+f2.getName());
System.out.println("目录长度:"+f2.length()+"字节");
System.out.println("文件最后修改时间:" + LocalDateTime.ofInstant(Instant.ofEpochMilli(f.lastModified()),ZoneId.of("Asia/Shanghai")));
}
}输出结果:
文件构造路径:d:\aaa\bbb.java
文件名称:bbb.java
文件长度:636字节
文件最后修改时间:2022-07-23T22:01:32.065
目录构造路径:d:\aaa
目录名称:aaa
目录长度:4096字节
文件最后修改时间:2022-07-23T22:01:32.065列出目录的下一级:
-
public String[] list():返回一个String数组,表示该File目录中的所有子文件或目录。 -
public File[] listFiles():返回一个File数组,表示该File目录中的所有的子文件或目录。
package com.atguigu.file;
import org.junit.Test;
import java.io.File;
import java.io.FileFilter;
import java.io.FilenameFilter;
public class DirListFiles {
@Test
public void test01() {
File dir = new File("d:/atguigu");
String[] subs = dir.list();
for (String sub : subs) {
System.out.println(sub);
}
}
}重命名的功能:
- public boolean renameTo(File dest):把文件重命名为指定的文件路径。
判断功能的方法:
-
public boolean exists():此File表示的文件或目录是否实际存在。 -
public boolean isDirectory():此File表示的是否为目录。 -
public boolean isFile():此File表示的是否为文件。 -
public boolean canRead():判断是否可读 -
public boolean canWrite():判断是否可写 -
public boolean isHidden():判断是否隐藏
举例:
import java.io.File;
public class FileIs {
public static void main(String[] args) {
File f = new File("d:\\aaa\\bbb.java");
File f2 = new File("d:\\aaa");
// 判断是否存在
System.out.println("d:\\aaa\\bbb.java 是否存在:"+f.exists());
System.out.println("d:\\aaa 是否存在:"+f2.exists());
// 判断是文件还是目录
System.out.println("d:\\aaa 文件?:"+f2.isFile());
System.out.println("d:\\aaa 目录?:"+f2.isDirectory());
}
}输出结果:
d:\aaa\bbb.java 是否存在:true
d:\aaa 是否存在:true
d:\aaa 文件?:false
d:\aaa 目录?:true如果文件或目录不存在,那么exists()、isFile()和isDirectory()都是返回true
创建、删除:
-
public boolean createNewFile():创建文件。若文件存在,则不创建,返回false。 -
public boolean mkdir():创建文件目录。如果此文件目录存在,就不创建了。如果此文件目录的上层目录不存在,也不创建。 -
public boolean mkdirs():创建文件目录。如果上层文件目录不存在,一并创建。 -
public boolean delete():删除文件或者文件夹 删除注意事项:① Java中的删除不走回收站。② 要删除一个文件目录,请注意该文件目录内不能包含文件或者文件目录。
举例:
import java.io.File;
import java.io.IOException;
public class FileCreateDelete {
public static void main(String[] args) throws IOException {
// 文件的创建
File f = new File("aaa.txt");
System.out.println("aaa.txt是否存在:"+f.exists());
System.out.println("aaa.txt是否创建:"+f.createNewFile());
System.out.println("aaa.txt是否存在:"+f.exists());
// 目录的创建
File f2= new File("newDir");
System.out.println("newDir是否存在:"+f2.exists());
System.out.println("newDir是否创建:"+f2.mkdir());
System.out.println("newDir是否存在:"+f2.exists());
// 创建一级目录
File f3= new File("newDira\\newDirb");
System.out.println("newDira\\newDirb创建:" + f3.mkdir());
File f4= new File("newDir\\newDirb");
System.out.println("newDir\\newDirb创建:" + f4.mkdir());
// 创建多级目录
File f5= new File("newDira\\newDirb");
System.out.println("newDira\\newDirb创建:" + f5.mkdirs());
// 文件的删除
System.out.println("aaa.txt删除:" + f.delete());
// 目录的删除
System.out.println("newDir删除:" + f2.delete());
System.out.println("newDir\\newDirb删除:" + f4.delete());
}
}运行结果:
aaa.txt是否存在:false
aaa.txt是否创建:true
aaa.txt是否存在:true
newDir是否存在:false
newDir是否创建:true
newDir是否存在:true
newDira\newDirb创建:false
newDir\newDirb创建:true
newDira\newDirb创建:true
aaa.txt删除:true
newDir删除:false
newDir\newDirb删除:trueAPI中说明:delete方法,如果此File表示目录,则目录必须为空才能删除。
IO 流原理及流的分类
Java IO 原理
Java程序中,对于数据的输入/输出操作以“流(stream)” 的方式进行,可以看做是一种数据的流动。
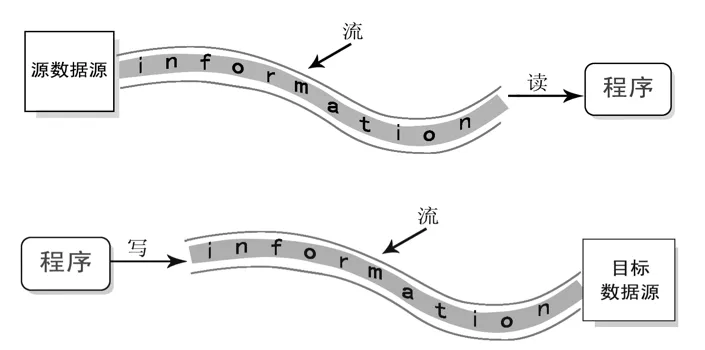
I/O流中的I/O是Input/Output的缩写, I/O技术是非常实用的技术,用于处理设备之间的数据传输。如读/写文件,网络通讯等。
-
输入input:读取外部数据(磁盘、光盘等存储设备的数据)到程序(内存)中。 -
输出output:将程序(内存)数据输出到磁盘、光盘等存储设备中。
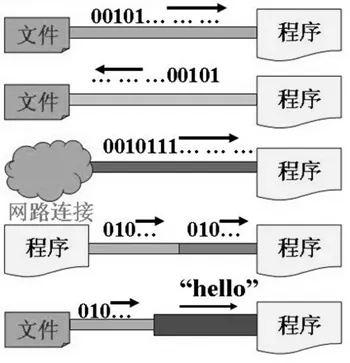
流的分类
java.io包下提供了各种“流”类和接口,用以获取不同种类的数据,并通过标准的方法输入或输出数据。
-
按数据的流向不同分为:输入流和输出流。
-
输入流 :把数据从
其他设备上读取到内存中的流。 -
以InputStream、Reader结尾
-
输出流 :把数据从
内存中写出到其他设备上的流。 -
以OutputStream、Writer结尾
-
按操作数据单位的不同分为:字节流(8bit)和字符流(16bit)。
-
字节流 :以字节为单位,读写数据的流。
-
以InputStream、OutputStream结尾
-
字符流 :以字符为单位,读写数据的流。
-
以Reader、Writer结尾
-
根据IO流的角色不同分为:节点流和处理流。
-
节点流:直接从数据源或目的地读写数据
-
处理流:不直接连接到数据源或目的地,而是“连接”在已存在的流(节点流或处理流)之上,通过对数据的处理为程序提供更为强大的读写功能。
图解
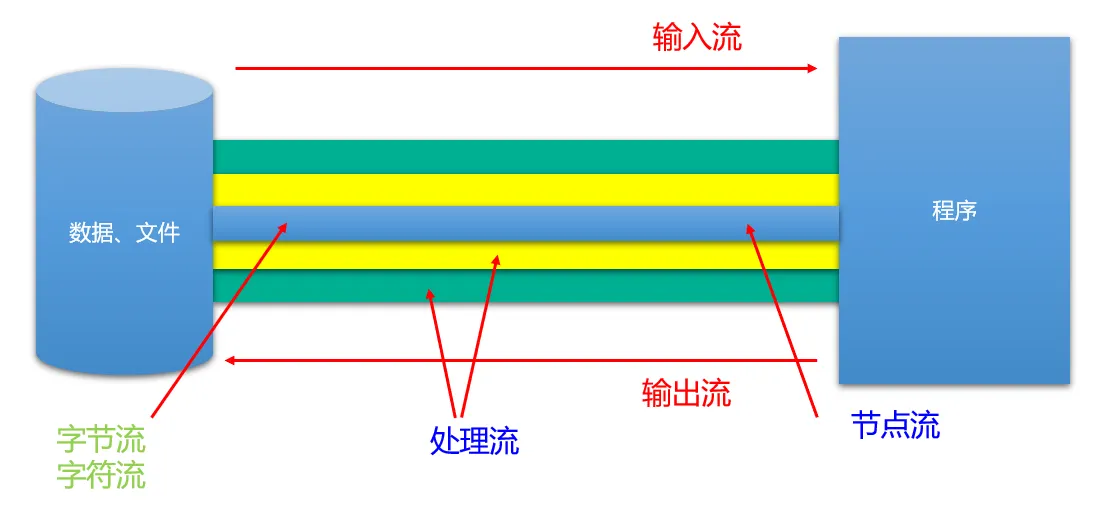
流的API
Java的IO流共涉及40多个类,实际上非常规则,都是从如下4个抽象基类派生的。
| (抽象基类) | 输入流 | 输出流 |
|---|---|---|
| 字节流 | InputStream | OutputStream |
| 字符流 | Reader | Writer |
由这四个类派生出来的子类名称都是以其父类名作为子类名后缀
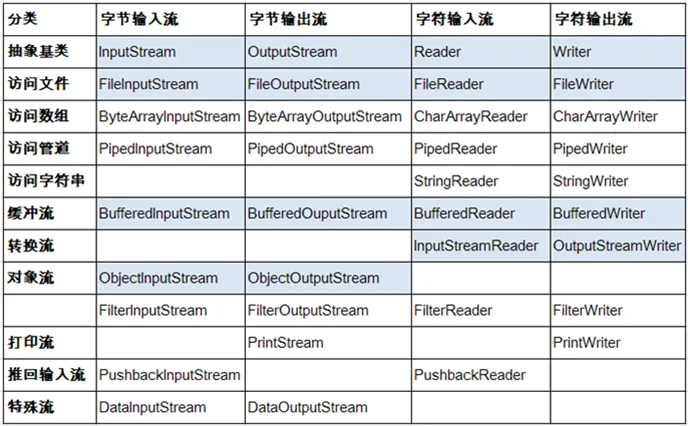
常用的节点流:
-
文件流: FileInputStream、FileOutputStrean、FileReader、FileWriter
-
字节/字符数组流: ByteArrayInputStream、ByteArrayOutputStream、CharArrayReader、CharArrayWriter
-
对数组进行处理的节点流(对应的不再是文件,而是内存中的一个数组)。
常用处理流:
-
缓冲流:BufferedInputStream、BufferedOutputStream、BufferedReader、BufferedWriter
-
作用:增加缓冲功能,避免频繁读写硬盘,进而提升读写效率。
-
转换流:InputStreamReader、OutputStreamReader
-
作用:实现字节流和字符流之间的转换。
-
对象流:ObjectInputStream、ObjectOutputStream
-
作用:提供直接读写Java对象功能
FileReader/FileWriter
Reader 与 Writer
Java提供一些字符流类,以字符为单位读写数据,专门用于处理文本文件。不能操作图片,视频等非文本文件。
常见的文本文件有如下的格式:.txt、.java、.c、.cpp、.py等
注意:.doc、.xls、.ppt这些都不是文本文件。
字符输入流:Reader
java.io.Reader抽象类是表示用于读取字符流的所有类的父类,可以读取字符信息到内存中。它定义了字符输入流的基本共性功能方法。
-
public int read(): 从输入流读取一个字符。 虽然读取了一个字符,但是会自动提升为int类型。返回该字符的Unicode编码值。如果已经到达流末尾了,则返回-1。 -
public int read(char[] cbuf): 从输入流中读取一些字符,并将它们存储到字符数组 cbuf中 。每次最多读取cbuf.length个字符。返回实际读取的字符个数。如果已经到达流末尾,没有数据可读,则返回-1。 -
public int read(char[] cbuf,int off,int len):从输入流中读取一些字符,并将它们存储到字符数组 cbuf中,从cbuf[off]开始的位置存储。每次最多读取len个字符。返回实际读取的字符个数。如果已经到达流末尾,没有数据可读,则返回-1。 -
public void close():关闭此流并释放与此流相关联的任何系统资源。
注意:当完成流的操作时,必须调用close()方法,释放系统资源,否则会造成内存泄漏。
字符输出流:Writer
java.io.Writer抽象类是表示用于写出字符流的所有类的超类,将指定的字符信息写出到目的地。它定义了字节输出流的基本共性功能方法。
-
public void write(int c):写出单个字符。 -
public void write(char[] cbuf):写出字符数组。 -
public void write(char[] cbuf, int off, int len):写出字符数组的某一部分。off:数组的开始索引;len:写出的字符个数。 -
public void write(String str):写出字符串。 -
public void write(String str, int off, int len):写出字符串的某一部分。off:字符串的开始索引;len:写出的字符个数。 -
public void flush():刷新该流的缓冲。 -
public void close():关闭此流。
注意:当完成流的操作时,必须调用close()方法,释放系统资源,否则会造成内存泄漏。
FileReader 与 FileWriter
FileReader
java.io.FileReader类用于读取字符文件,构造时使用系统默认的字符编码和默认字节缓冲区。
-
FileReader(File file): 创建一个新的 FileReader ,给定要读取的File对象。 -
FileReader(String fileName): 创建一个新的 FileReader ,给定要读取的文件的名称。
**举例:**读取hello.txt文件中的字符数据,并显示在控制台上
public class FileReaderWriterTest {
//实现方式1
@Test
public void test1() throws IOException {
//1. 创建File类的对象,对应着物理磁盘上的某个文件
File file = new File("hello.txt");
//2. 创建FileReader流对象,将File类的对象作为参数传递到FileReader的构造器中
FileReader fr = new FileReader(file);
//3. 通过相关流的方法,读取文件中的数据
// int data = fr.read(); //每调用一次读取一个字符
// while (data != -1) {
// System.out.print((char) data);
// data = fr.read();
// }
int data;
while ((data = fr.read()) != -1) {
System.out.print((char) data);
}
//4. 关闭相关的流资源,避免出现内存泄漏
fr.close();
}
//实现方式2:在方式1的基础上改进,使用try-catch-finally处理异常。保证流是可以关闭的
@Test
public void test2() {
FileReader fr = null;
try {
//1. 创建File类的对象,对应着物理磁盘上的某个文件
File file = new File("hello.txt");
//2. 创建FileReader流对象,将File类的对象作为参数传递到FileReader的构造器中
fr = new FileReader(file);
//3. 通过相关流的方法,读取文件中的数据
/*
* read():每次从对接的文件中读取一个字符。并将此字符返回。
* 如果返回值为-1,则表示文件到了末尾,可以不再读取。
* */
// int data = fr.read();
// while(data != -1){
// System.out.print((char)data);
// data = fr.read();
// }
int data;
while ((data = fr.read()) != -1) {
System.out.println((char) data);
}
} catch (IOException e) {
e.printStackTrace();
} finally {
//4. 关闭相关的流资源,避免出现内存泄漏
try {
if (fr != null)
fr.close();
} catch (IOException e) {
e.printStackTrace();
}
}
}
//实现方式3:调用read(char[] cbuf),每次从文件中读取多个字符
@Test
public void test3() {
FileReader fr = null;
try {
//1. 创建File类的对象,对应着物理磁盘上的某个文件
File file = new File("hello.txt");
//2. 创建FileReader流对象,将File类的对象作为参数传递到FileReader的构造器中
fr = new FileReader(file);
//3. 通过相关流的方法,读取文件中的数据
char[] cbuf = new char[5];
/*
* read(char[] cbuf) : 每次将文件中的数据读入到cbuf数组中,并返回读入到数组中的
* 字符的个数。
* */
int len; //记录每次读入的字符的个数
while ((len = fr.read(cbuf)) != -1) {
//处理char[]数组即可
//错误:
// for(int i = 0;i < cbuf.length;i++){
// System.out.print(cbuf[i]);
// }
//错误:
// String str = new String(cbuf);
// System.out.print(str);
//正确:
// for(int i = 0;i < len;i++){
// System.out.print(cbuf[i]);
// }
//正确:
String str = new String(cbuf, 0, len);
System.out.print(str);
}
} catch (IOException e) {
e.printStackTrace();
} finally {
//4. 关闭相关的流资源,避免出现内存泄漏
try {
if (fr != null)
fr.close();
} catch (IOException e) {
e.printStackTrace();
}
}
}
}不同实现方式的类比:
FileWriter
java.io.FileWriter类用于写出字符到文件,构造时使用系统默认的字符编码和默认字节缓冲区。
-
FileWriter(File file): 创建一个新的 FileWriter,给定要读取的File对象。 -
FileWriter(String fileName): 创建一个新的 FileWriter,给定要读取的文件的名称。 -
FileWriter(File file,boolean append): 创建一个新的 FileWriter,指明是否在现有文件末尾追加内容。
举例:
public class FWWrite {
//注意:应该使用try-catch-finally处理异常。这里出于方便阅读代码,使用了throws的方式
@Test
public void test01()throws IOException {
// 使用文件名称创建流对象
FileWriter fw = new FileWriter(new File("fw.txt"));
// 写出数据
fw.write(97); // 写出第1个字符
fw.write('b'); // 写出第2个字符
fw.write('C'); // 写出第3个字符
fw.write(30000); // 写出第4个字符,中文编码表中30000对应一个汉字。
//关闭资源
fw.close();
}
//注意:应该使用try-catch-finally处理异常。这里出于方便阅读代码,使用了throws的方式
@Test
public void test02()throws IOException {
// 使用文件名称创建流对象
FileWriter fw = new FileWriter(new File("fw.txt"));
// 字符串转换为字节数组
char[] chars = "尚硅谷".toCharArray();
// 写出字符数组
fw.write(chars); // 尚硅谷
// 写出从索引1开始,2个字符。
fw.write(chars,1,2); // 硅谷
// 关闭资源
fw.close();
}
//注意:应该使用try-catch-finally处理异常。这里出于方便阅读代码,使用了throws的方式
@Test
public void test03()throws IOException {
// 使用文件名称创建流对象
FileWriter fw = new FileWriter("fw.txt");
// 字符串
String msg = "尚硅谷";
// 写出字符数组
fw.write(msg); //尚硅谷
// 写出从索引1开始,2个字符。
fw.write(msg,1,2); // 硅谷
// 关闭资源
fw.close();
}
@Test
public void test04(){
FileWriter fw = null;
try {
//1. 创建File的对象
File file = new File("personinfo.txt");
//2. 创建FileWriter的对象,将File对象作为参数传递到FileWriter的构造器中
//如果输出的文件已存在,则会对现有的文件进行覆盖
fw = new FileWriter(file);
// fw = new FileWriter(file,false);
//如果输出的文件已存在,则会在现有的文件末尾写入数据
// fw = new FileWriter(file,true);
//3. 调用相关的方法,实现数据的写出操作
//write(String str) / write(char[] cbuf)
fw.write("I love you,");
fw.write("you love him.");
fw.write("so sad".toCharArray());
} catch (IOException e) {
e.printStackTrace();
} finally {
//4. 关闭资源,避免内存泄漏
try {
if (fw != null)
fw.close();
} catch (IOException e) {
throw new RuntimeException(e);
}
}
}
}关于 flush(刷新)
因为内置缓冲区的原因,如果FileWriter不关闭输出流,无法写出字符到文件中。但是关闭的流对象,是无法继续写出数据的。如果我们既想写出数据,又想继续使用流,就需要flush() 方法了。
-
flush():刷新缓冲区,流对象可以继续使用。 -
close():先刷新缓冲区,然后通知系统释放资源。流对象不可以再被使用了。
注意:即便是flush()方法写出了数据,操作的最后还是要调用close方法,释放系统资源。
举例:
public class FWWriteFlush {
//注意:应该使用try-catch-finally处理异常。这里出于方便阅读代码,使用了throws的方式
@Test
public void test() throws IOException {
// 使用文件名称创建流对象
FileWriter fw = new FileWriter("fw.txt");
// 写出数据,通过flush
fw.write('刷'); // 写出第1个字符
fw.flush();
fw.write('新'); // 继续写出第2个字符,写出成功
fw.flush();
// 写出数据,通过close
fw.write('关'); // 写出第1个字符
fw.close();
fw.write('闭'); // 继续写出第2个字符,【报错】java.io.IOException: Stream closed
fw.close();
}
}FileInputStream/FileOutputStream
如果我们读取或写出的数据是非文本文件,则Reader、Writer就无能为力了,必须使用字节流。
InputStream和OutputStream
字节输入流:InputStream
java.io.InputStream抽象类是表示字节输入流的所有类的超类,可以读取字节信息到内存中。它定义了字节输入流的基本共性功能方法。
-
public int read(): 从输入流读取一个字节。返回读取的字节值。虽然读取了一个字节,但是会自动提升为int类型。如果已经到达流末尾,没有数据可读,则返回-1。 -
public int read(byte[] b): 从输入流中读取一些字节数,并将它们存储到字节数组 b中 。每次最多读取b.length个字节。返回实际读取的字节个数。如果已经到达流末尾,没有数据可读,则返回-1。 -
public int read(byte[] b,int off,int len):从输入流中读取一些字节数,并将它们存储到字节数组 b中,从b[off]开始存储,每次最多读取len个字节 。返回实际读取的字节个数。如果已经到达流末尾,没有数据可读,则返回-1。 -
public void close():关闭此输入流并释放与此流相关联的任何系统资源。
说明:close()方法,当完成流的操作时,必须调用此方法,释放系统资源。
字节输出流:OutputStream
java.io.OutputStream抽象类是表示字节输出流的所有类的超类,将指定的字节信息写出到目的地。它定义了字节输出流的基本共性功能方法。
-
public void write(int b):将指定的字节输出流。虽然参数为int类型四个字节,但是只会保留一个字节的信息写出。 -
public void write(byte[] b):将 b.length字节从指定的字节数组写入此输出流。 -
public void write(byte[] b, int off, int len):从指定的字节数组写入 len字节,从偏移量 off开始输出到此输出流。 -
public void flush():刷新此输出流并强制任何缓冲的输出字节被写出。 -
public void close():关闭此输出流并释放与此流相关联的任何系统资源。
说明:close()方法,当完成流的操作时,必须调用此方法,释放系统资源。
FileInputStream与 FileOutputStream
FileInputStream
java.io.FileInputStream类是文件输入流,从文件中读取字节。
-
FileInputStream(File file): 通过打开与实际文件的连接来创建一个 FileInputStream ,该文件由文件系统中的 File对象 file命名。 -
FileInputStream(String name): 通过打开与实际文件的连接来创建一个 FileInputStream ,该文件由文件系统中的路径名 name命名。
举例:
//read.txt文件中的内容如下:
abcde读取操作:
public class FISRead {
//注意:应该使用try-catch-finally处理异常。这里出于方便阅读代码,使用了throws的方式
@Test
public void test() throws IOException {
// 使用文件名称创建流对象
FileInputStream fis = new FileInputStream("read.txt");
// 读取数据,返回一个字节
int read = fis.read();
System.out.println((char) read);
read = fis.read();
System.out.println((char) read);
read = fis.read();
System.out.println((char) read);
read = fis.read();
System.out.println((char) read);
read = fis.read();
System.out.println((char) read);
// 读取到末尾,返回-1
read = fis.read();
System.out.println(read);
// 关闭资源
fis.close();
/*
文件内容:abcde
输出结果:
a
b
c
d
e
-1
*/
}
@Test
public void test02()throws IOException{
// 使用文件名称创建流对象
FileInputStream fis = new FileInputStream("read.txt");
// 定义变量,保存数据
int b;
// 循环读取
while ((b = fis.read())!=-1) {
System.out.println((char)b);
}
// 关闭资源
fis.close();
}
@Test
public void test03()throws IOException{
// 使用文件名称创建流对象.
FileInputStream fis = new FileInputStream("read.txt"); // 文件中为abcde
// 定义变量,作为有效个数
int len;
// 定义字节数组,作为装字节数据的容器
byte[] b = new byte[2];
// 循环读取
while (( len= fis.read(b))!=-1) {
// 每次读取后,把数组变成字符串打印
System.out.println(new String(b));
}
// 关闭资源
fis.close();
/*
输出结果:
ab
cd
ed
最后错误数据`d`,是由于最后一次读取时,只读取一个字节`e`,数组中,
上次读取的数据没有被完全替换,所以要通过`len` ,获取有效的字节
*/
}
@Test
public void test04()throws IOException{
// 使用文件名称创建流对象.
FileInputStream fis = new FileInputStream("read.txt"); // 文件中为abcde
// 定义变量,作为有效个数
int len;
// 定义字节数组,作为装字节数据的容器
byte[] b = new byte[2];
// 循环读取
while (( len= fis.read(b))!=-1) {
// 每次读取后,把数组的有效字节部分,变成字符串打印
System.out.println(new String(b,0,len));// len 每次读取的有效字节个数
}
// 关闭资源
fis.close();
/*
输出结果:
ab
cd
e
*/
}
}FileOutputStream
java.io.FileOutputStream类是文件输出流,用于将数据写出到文件。
-
public FileOutputStream(File file):创建文件输出流,写出由指定的 File对象表示的文件。 -
public FileOutputStream(String name): 创建文件输出流,指定的名称为写出文件。 -
public FileOutputStream(File file, boolean append): 创建文件输出流,指明是否在现有文件末尾追加内容。
举例:
import org.junit.Test;
import java.io.FileOutputStream;
import java.io.IOException;
public class FOSWrite {
//注意:应该使用try-catch-finally处理异常。这里出于方便阅读代码,使用了throws的方式
@Test
public void test01() throws IOException {
// 使用文件名称创建流对象
FileOutputStream fos = new FileOutputStream("fos.txt");
// 写出数据
fos.write(97); // 写出第1个字节
fos.write(98); // 写出第2个字节
fos.write(99); // 写出第3个字节
// 关闭资源
fos.close();
/* 输出结果:abc*/
}
@Test
public void test02()throws IOException {
// 使用文件名称创建流对象
FileOutputStream fos = new FileOutputStream("fos.txt");
// 字符串转换为字节数组
byte[] b = "abcde".getBytes();
// 写出从索引2开始,2个字节。索引2是c,两个字节,也就是cd。
fos.write(b,2,2);
// 关闭资源
fos.close();
}
//这段程序如果多运行几次,每次都会在原来文件末尾追加abcde
@Test
public void test03()throws IOException {
// 使用文件名称创建流对象
FileOutputStream fos = new FileOutputStream("fos.txt",true);
// 字符串转换为字节数组
byte[] b = "abcde".getBytes();
fos.write(b);
// 关闭资源
fos.close();
}
//使用FileInputStream\FileOutputStream,实现对文件的复制
@Test
public void test05() {
FileInputStream fis = null;
FileOutputStream fos = null;
try {
//1. 造文件-造流
//复制图片:成功
// fis = new FileInputStream(new File("pony.jpg"));
// fos = new FileOutputStream(new File("pony_copy1.jpg"));
//复制文本文件:成功
fis = new FileInputStream(new File("hello.txt"));
fos = new FileOutputStream(new File("hello1.txt"));
//2. 复制操作(读、写)
byte[] buffer = new byte[1024];
int len;//每次读入到buffer中字节的个数
while ((len = fis.read(buffer)) != -1) {
fos.write(buffer, 0, len);
// String str = new String(buffer,0,len);
// System.out.print(str);
}
System.out.println("复制成功");
} catch (IOException e) {
throw new RuntimeException(e);
} finally {
//3. 关闭资源
try {
if (fos != null)
fos.close();
} catch (IOException e) {
throw new RuntimeException(e);
}
try {
if (fis != null)
fis.close();
} catch (IOException e) {
throw new RuntimeException(e);
}
}
}
}缓冲流
为了提高数据读写的速度,Java API提供了带缓冲功能的流类:缓冲流。
缓冲流要“套接”在相应的节点流之上,根据数据操作单位可以把缓冲流分为:
-
字节缓冲流:
BufferedInputStream,BufferedOutputStream -
字符缓冲流:
BufferedReader,BufferedWriter
缓冲流的基本原理:在创建流对象时,内部会创建一个缓冲区数组(缺省使用8192个字节(8Kb)的缓冲区),通过缓冲区读写,减少系统IO次数,从而提高读写的效率。
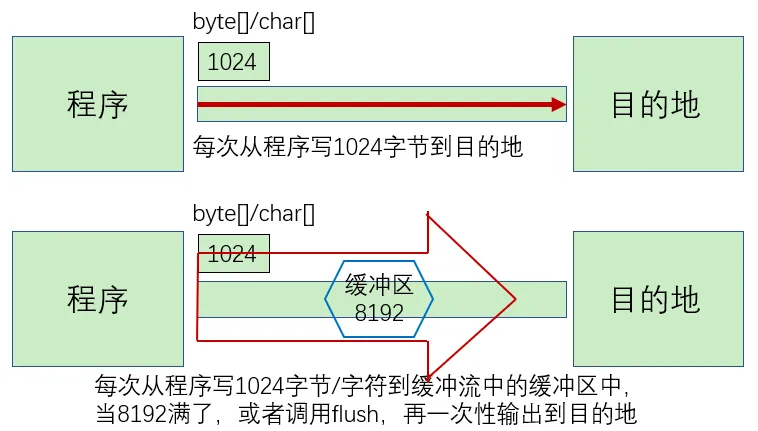
构造器
-
public BufferedInputStream(InputStream in):创建一个 新的字节型的缓冲输入流。 -
public BufferedOutputStream(OutputStream out): 创建一个新的字节型的缓冲输出流。
代码举例:
// 创建字节缓冲输入流
BufferedInputStream bis = new BufferedInputStream(new FileInputStream("abc.jpg"));
// 创建字节缓冲输出流
BufferedOutputStream bos = new BufferedOutputStream(new FileOutputStream("abc_copy.jpg"));-
public BufferedReader(Reader in):创建一个 新的字符型的缓冲输入流。 -
public BufferedWriter(Writer out): 创建一个新的字符型的缓冲输出流。
代码举例:
// 创建字符缓冲输入流
BufferedReader br = new BufferedReader(new FileReader("br.txt"));
// 创建字符缓冲输出流
BufferedWriter bw = new BufferedWriter(new FileWriter("bw.txt"));字符缓冲流特有方法
字符缓冲流的基本方法与普通字符流调用方式一致,不再阐述,我们来看它们具备的特有方法。
-
BufferedReader:
public String readLine(): 读一行文字。 -
BufferedWriter:
public void newLine(): 写一行行分隔符,由系统属性定义符号。
public class BufferedIOLine {
@Test
public void testReadLine()throws IOException {
// 创建流对象
BufferedReader br = new BufferedReader(new FileReader("in.txt"));
// 定义字符串,保存读取的一行文字
String line;
// 循环读取,读取到最后返回null
while ((line = br.readLine())!=null) {
System.out.println(line);
}
// 释放资源
br.close();
}
@Test
public void testNewLine()throws IOException{
// 创建流对象
BufferedWriter bw = new BufferedWriter(new FileWriter("out.txt"));
// 写出数据
bw.write("尚");
// 写出换行
bw.newLine();
bw.write("硅");
bw.newLine();
bw.write("谷");
bw.newLine();
// 释放资源
bw.close();
}
}说明:
涉及到嵌套的多个流时,如果都显式关闭的话,需要先关闭外层的流,再关闭内层的流
其实在开发中,只需要关闭最外层的流即可,因为在关闭外层流时,内层的流也会被关闭。
转换流
问题引入
引入情况1:
使用FileReader 读取项目中的文本文件。由于IDEA设置中针对项目设置了UTF-8编码,当读取Windows系统中创建的文本文件时,如果Windows系统默认的是GBK编码,则读入内存中会出现乱码。
import java.io.FileReader;
import java.io.IOException;
public class Problem {
public static void main(String[] args) throws IOException {
FileReader fileReader = new FileReader("E:\\File_GBK.txt");
int data;
while ((data = fileReader.read()) != -1) {
System.out.print((char)data);
}
fileReader.close();
}
}
输出结果:
���那么如何读取GBK编码的文件呢?
引入情况2:
针对文本文件,现在使用一个字节流进行数据的读入,希望将数据显示在控制台上。此时针对包含中文的文本数据,可能会出现乱码。
转换流的理解
作用:转换流是字节与字符间的桥梁
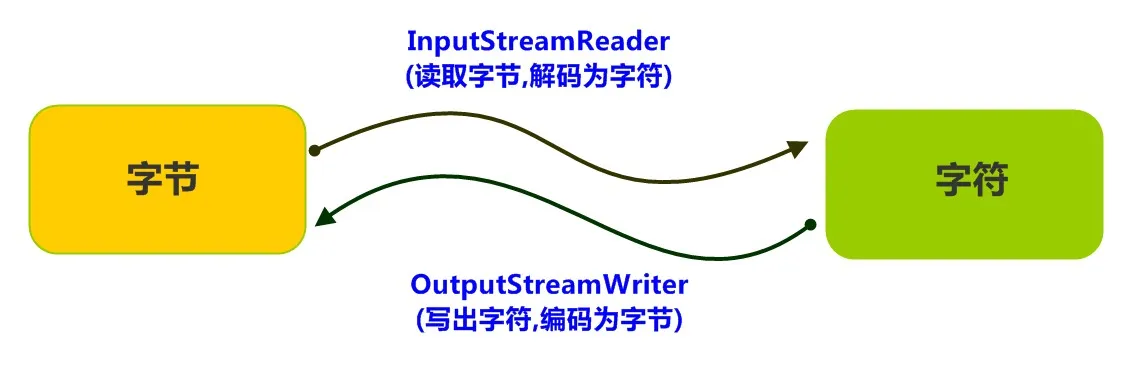
具体来说:
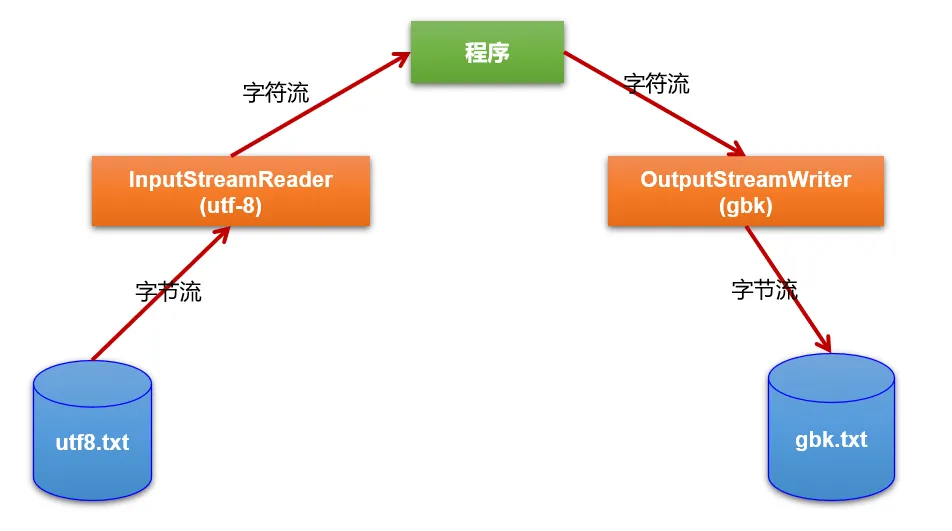
InputStreamReader 和 OutputStreamWriter
InputStreamReader
转换流java.io.InputStreamReader,是Reader的子类,是从字节流到字符流的桥梁。它读取字节,并使用指定的字符集将其解码为字符。它的字符集可以由名称指定,也可以接受平台的默认字符集。
构造器
-
InputStreamReader(InputStream in): 创建一个使用默认字符集的字符流。 -
InputStreamReader(InputStream in, String charsetName): 创建一个指定字符集的字符流。
举例:
//使用默认字符集
InputStreamReader isr1 = new InputStreamReader(new FileInputStream("in.txt"));
//使用指定字符集
InputStreamReader isr2 = new InputStreamReader(new FileInputStream("in.txt") , "GBK");示例代码:
import java.io.FileInputStream;
import java.io.IOException;
import java.io.InputStreamReader;
public class InputStreamReaderDemo {
public static void main(String[] args) throws IOException {
// 定义文件路径,文件为gbk编码
String fileName = "E:\\file_gbk.txt";
//方式1:
// 创建流对象,默认UTF8编码
InputStreamReader isr1 = new InputStreamReader(new FileInputStream(fileName));
// 定义变量,保存字符
int charData;
// 使用默认编码字符流读取,乱码
while ((charData = isr1.read()) != -1) {
System.out.print((char)charData); // ��Һ�
}
isr1.close();
//方式2:
// 创建流对象,指定GBK编码
InputStreamReader isr2 = new InputStreamReader(new FileInputStream(fileName) , "GBK");
// 使用指定编码字符流读取,正常解析
while ((charData = isr2.read()) != -1) {
System.out.print((char)charData);// 大家好
}
isr2.close();
}
}OutputStreamWriter
转换流java.io.OutputStreamWriter ,是Writer的子类,是从字符流到字节流的桥梁。使用指定的字符集将字符编码为字节。它的字符集可以由名称指定,也可以接受平台的默认字符集。
构造器:
-
OutputStreamWriter(OutputStream in): 创建一个使用默认字符集的字符流。 -
OutputStreamWriter(OutputStream in,String charsetName): 创建一个指定字符集的字符流。
举例:
//使用默认字符集
OutputStreamWriter isr = new OutputStreamWriter(new FileOutputStream("out.txt"));
//使用指定的字符集
OutputStreamWriter isr2 = new OutputStreamWriter(new FileOutputStream("out.txt") , "GBK");示例代码:
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.OutputStreamWriter;
public class OutputStreamWriterDemo {
public static void main(String[] args) throws IOException {
// 定义文件路径
String FileName = "E:\\out_utf8.txt";
// 创建流对象,默认UTF8编码
OutputStreamWriter osw = new OutputStreamWriter(new FileOutputStream(FileName));
// 写出数据
osw.write("你好"); // 保存为6个字节
osw.close();
// 定义文件路径
String FileName2 = "E:\\out_gbk.txt";
// 创建流对象,指定GBK编码
OutputStreamWriter osw2 = new OutputStreamWriter(new
FileOutputStream(FileName2),"GBK");
// 写出数据
osw2.write("你好");// 保存为4个字节
osw2.close();
}
}字符编码和字符集
编码与解码
计算机中储存的信息都是用二进制数表示的,而我们在屏幕上看到的数字、英文、标点符号、汉字等字符是二进制数转换之后的结果。按照某种规则,将字符存储到计算机中,称为编码 。反之,将存储在计算机中的二进制数按照某种规则解析显示出来,称为解码 。
字符编码(Character Encoding) : 就是一套自然语言的字符与二进制数之间的对应规则。
编码表:生活中文字和计算机中二进制的对应规则
乱码的情况:按照A规则存储,同样按照A规则解析,那么就能显示正确的文本符号。反之,按照A规则存储,再按照B规则解析,就会导致乱码现象。
编码:字符(人能看懂的)--字节(人看不懂的)
解码:字节(人看不懂的)-->字符(人能看懂的)字符集
-
字符集Charset:也叫编码表。是一个系统支持的所有字符的集合,包括各国家文字、标点符号、图形符号、数字等。
-
计算机要准确的存储和识别各种字符集符号,需要进行字符编码,一套字符集必然至少有一套字符编码。常见字符集有ASCII字符集、GBK字符集、Unicode字符集等。
可见,当指定了编码,它所对应的字符集自然就指定了,所以编码才是我们最终要关心的。
-
ASCII字符集 :
-
ASCII码(American Standard Code for Information Interchange,美国信息交换标准代码):上个世纪60年代,美国制定了一套字符编码,对
英语字符与二进制位之间的关系,做了统一规定。这被称为ASCII码。 -
ASCII码用于显示现代英语,主要包括控制字符(回车键、退格、换行键等)和可显示字符(英文大小写字符、阿拉伯数字和西文符号)。
-
基本的ASCII字符集,使用7位(bits)表示一个字符(最前面的1位统一规定为0),共
128个字符。比如:空格“SPACE”是32(二进制00100000),大写的字母A是65(二进制01000001)。 -
缺点:不能表示所有字符。
-
ISO-8859-1字符集:
-
拉丁码表,别名Latin-1,用于显示欧洲使用的语言,包括荷兰语、德语、意大利语、葡萄牙语等
-
ISO-8859-1使用单字节编码,兼容ASCII编码。
-
GBxxx字符集:
-
GB就是国标的意思,是为了
显示中文而设计的一套字符集。 -
GB2312:简体中文码表。一个小于127的字符的意义与原来相同,即向下兼容ASCII码。但两个大于127的字符连在一起时,就表示一个汉字,这样大约可以组合了包含
7000多个简体汉字,此外数学符号、罗马希腊的字母、日文的假名们都编进去了,这就是常说的"全角"字符,而原来在127号以下的那些符号就叫"半角"字符了。 -
GBK:最常用的中文码表。是在GB2312标准基础上的扩展规范,使用了
双字节编码方案,共收录了21003个汉字,完全兼容GB2312标准,同时支持繁体汉字以及日韩汉字等。 -
GB18030:最新的中文码表。收录汉字
70244个,采用多字节编码,每个字可以由1个、2个或4个字节组成。支持中国国内少数民族的文字,同时支持繁体汉字以及日韩汉字等。 -
Unicode字符集 :
-
Unicode编码为表达
任意语言的任意字符而设计,也称为统一码、标准万国码。Unicode 将世界上所有的文字用2个字节统一进行编码,为每个字符设定唯一的二进制编码,以满足跨语言、跨平台进行文本处理的要求。 -
Unicode 的缺点:这里有三个问题:
-
第一,英文字母只用一个字节表示就够了,如果用更多的字节存储是
极大的浪费。 -
第二,如何才能
区别Unicode和ASCII?计算机怎么知道两个字节表示一个符号,而不是分别表示两个符号呢? -
第三,如果和GBK等双字节编码方式一样,用最高位是1或0表示两个字节和一个字节,就少了很多值无法用于表示字符,
不够表示所有字符。 -
Unicode在很长一段时间内无法推广,直到互联网的出现,为解决Unicode如何在网络上传输的问题,于是面向传输的众多 UTF(UCS Transfer Format)标准出现。具体来说,有三种编码方案,UTF-8、UTF-16和UTF-32。
-
UTF-8字符集:
-
Unicode是字符集,UTF-8、UTF-16、UTF-32是三种
将数字转换到程序数据的编码方案。顾名思义,UTF-8就是每次8个位传输数据,而UTF-16就是每次16个位。其中,UTF-8 是在互联网上使用最广的一种 Unicode 的实现方式。 -
互联网工程工作小组(IETF)要求所有互联网协议都必须支持UTF-8编码。所以,我们开发Web应用,也要使用UTF-8编码。UTF-8 是一种
变长的编码方式。它使用1-4个字节为每个字符编码,编码规则:
-
128个US-ASCII字符,只需一个字节编码。
-
拉丁文等字符,需要二个字节编码。
-
大部分常用字(含中文),使用三个字节编码。
-
其他极少使用的Unicode辅助字符,使用四字节编码。
举例:
Unicode符号范围 | UTF-8编码方式
(十六进制) | (二进制)
————————————————————|—–—–—–—–—–—–—–—–—–—–—–—–—–—–
0000 0000-0000 007F | 0xxxxxxx(兼容原来的ASCII)
0000 0080-0000 07FF | 110xxxxx 10xxxxxx
0000 0800-0000 FFFF | 1110xxxx 10xxxxxx 10xxxxxx
0001 0000-0010 FFFF | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx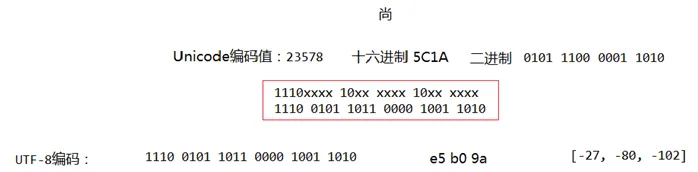
注意:在中文操作系统上,ANSI(美国国家标准学会、AMERICAN NATIONAL STANDARDS INSTITUTE: ANSI)编码即为GBK;在英文操作系统上,ANSI编码即为ISO-8859-1。
数据流、对象流
如果需要将内存中定义的变量(包括基本数据类型或引用数据类型)保存在文件中,那怎么办呢?
Java提供了数据流和对象流来处理这些类型的数据:
数据流:DataOutputStream、DataInputStream
-
DataOutputStream:允许应用程序将基本数据类型、String类型的变量写入输出流中
-
DataInputStream:允许应用程序以与机器无关的方式从底层输入流中读取基本数据类型、String类型的变量。
对象流DataInputStream中的方法:
byte readByte() short readShort()
int readInt() long readLong()
float readFloat() double readDouble()
char readChar() boolean readBoolean()
String readUTF() void readFully(byte[] b)对象流DataOutputStream中的方法:将上述的方法的read改为相应的write即可。
数据流的弊端:只支持Java基本数据类型和字符串的读写,而不支持其它Java对象的类型。而ObjectOutputStream和ObjectInputStream既支持Java基本数据类型的数据读写,又支持Java对象的读写,所以重点介绍对象流ObjectOutputStream和ObjectInputStream。
对象流:ObjectOutputStream、ObjectInputStream
-
ObjectOutputStream:将 Java 基本数据类型和对象写入字节输出流中。通过在流中使用文件可以实现Java各种基本数据类型的数据以及对象的持久存储。
-
ObjectInputStream:ObjectInputStream 对以前使用 ObjectOutputStream 写出的基本数据类型的数据和对象进行读入操作,保存在内存中。
对象流的强大之处就是可以把Java中的对象写入到数据源中,也能把对象从数据源中还原回来。
对象流 API
ObjectOutputStream中的构造器:
public ObjectOutputStream(OutputStream out): 创建一个指定的ObjectOutputStream。
FileOutputStream fos = new FileOutputStream("game.dat");
ObjectOutputStream oos = new ObjectOutputStream(fos);ObjectOutputStream中的方法:
-
public void writeBoolean(boolean val):写出一个 boolean 值。
-
public void writeByte(int val):写出一个8位字节
-
public void writeShort(int val):写出一个16位的 short 值
-
public void writeChar(int val):写出一个16位的 char 值
-
public void writeInt(int val):写出一个32位的 int 值
-
public void writeLong(long val):写出一个64位的 long 值
-
public void writeFloat(float val):写出一个32位的 float 值。
-
public void writeDouble(double val):写出一个64位的 double 值
-
public void writeUTF(String str):将表示长度信息的两个字节写入输出流,后跟字符串 s 中每个字符的 UTF-8 修改版表示形式。根据字符的值,将字符串 s 中每个字符转换成一个字节、两个字节或三个字节的字节组。注意,将 String 作为基本数据写入流中与将它作为 Object 写入流中明显不同。 如果 s 为 null,则抛出 NullPointerException。
-
public void writeObject(Object obj):写出一个obj对象 -
public void close() :关闭此输出流并释放与此流相关联的任何系统资源
ObjectInputStream中的构造器:
public ObjectInputStream(InputStream in): 创建一个指定的ObjectInputStream。
FileInputStream fis = new FileInputStream("game.dat");
ObjectInputStream ois = new ObjectInputStream(fis);ObjectInputStream中的方法:
-
public boolean readBoolean():读取一个 boolean 值
-
public byte readByte():读取一个 8 位的字节
-
public short readShort():读取一个 16 位的 short 值
-
public char readChar():读取一个 16 位的 char 值
-
public int readInt():读取一个 32 位的 int 值
-
public long readLong():读取一个 64 位的 long 值
-
public float readFloat():读取一个 32 位的 float 值
-
public double readDouble():读取一个 64 位的 double 值
-
public String readUTF():读取 UTF-8 修改版格式的 String
-
public void readObject(Object obj):读入一个obj对象 -
public void close() :关闭此输入流并释放与此流相关联的任何系统资源
对象序列化机制
1、何为对象序列化机制?
对象序列化机制允许把内存中的Java对象转换成平台无关的二进制流,从而允许把这种二进制流持久地保存在磁盘上,或通过网络将这种二进制流传输到另一个网络节点。//当其它程序获取了这种二进制流,就可以恢复成原来的Java对象。
-
序列化过程:用一个字节序列可以表示一个对象,该字节序列包含该
对象的类型和对象中存储的属性等信息。字节序列写出到文件之后,相当于文件中持久保存了一个对象的信息。 -
反序列化过程:该字节序列还可以从文件中读取回来,重构对象,对它进行
反序列化。对象的数据、对象的类型和对象中存储的数据信息,都可以用来在内存中创建对象。
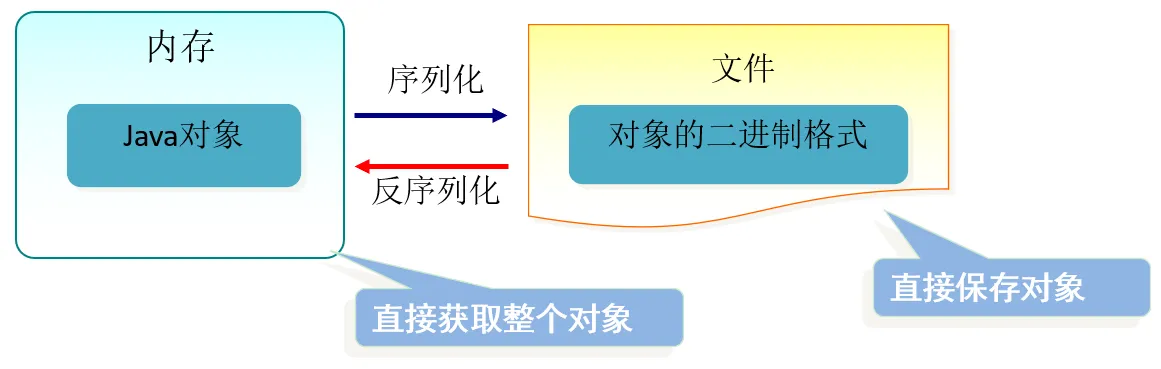
2、序列化机制的重要性
序列化是 RMI(Remote Method Invoke、远程方法调用)过程的参数和返回值都必须实现的机制,而 RMI 是 JavaEE 的基础。因此序列化机制是 JavaEE 平台的基础。
序列化的好处,在于可将任何实现了Serializable接口的对象转化为字节数据,使其在保存和传输时可被还原。
3、实现原理
-
序列化:用ObjectOutputStream类保存基本类型数据或对象的机制。方法为:
-
public final void writeObject (Object obj): 将指定的对象写出。 -
反序列化:用ObjectInputStream类读取基本类型数据或对象的机制。方法为:
-
public final Object readObject (): 读取一个对象。
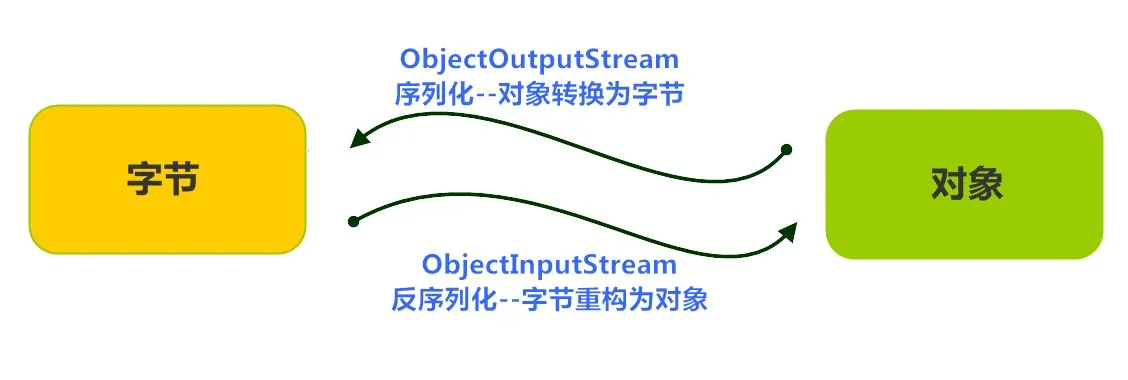
如何实现序列化机制
如果需要让某个对象支持序列化机制,则必须让对象所属的类及其属性是可序列化的,为了让某个类是可序列化的,该类必须实现java.io.Serializable 接口。Serializable 是一个标记接口,不实现此接口的类将不会使任何状态序列化或反序列化,会抛出NotSerializableException 。
-
如果对象的某个属性也是引用数据类型,那么如果该属性也要序列化的话,也要实现
Serializable接口 -
该类的所有属性必须是可序列化的。如果有一个属性不需要可序列化的,则该属性必须注明是瞬态的,使用
transient关键字修饰。 -
静态(static)变量的值不会序列化。因为静态变量的值不属于某个对象。
举例:
import org.junit.Test;
import java.io.*;
public class ReadWriteDataOfAnyType {
@Test
public void save() throws IOException {
String name = "巫师";
int age = 300;
char gender = '男';
int energy = 5000;
double price = 75.5;
boolean relive = true;
ObjectOutputStream oos = new ObjectOutputStream(new FileOutputStream("game.dat"));
oos.writeUTF(name);
oos.writeInt(age);
oos.writeChar(gender);
oos.writeInt(energy);
oos.writeDouble(price);
oos.writeBoolean(relive);
oos.close();
}
@Test
public void reload()throws IOException{
ObjectInputStream ois = new ObjectInputStream(new FileInputStream("game.dat"));
String name = ois.readUTF();
int age = ois.readInt();
char gender = ois.readChar();
int energy = ois.readInt();
double price = ois.readDouble();
boolean relive = ois.readBoolean();
System.out.println(name+"," + age + "," + gender + "," + energy + "," + price + "," + relive);
ois.close();
}
}反序列化失败问题
问题1:
对于JVM可以反序列化对象,它必须是能够找到class文件的类。如果找不到该类的class文件,则抛出一个 ClassNotFoundException 异常。
问题2:
当JVM反序列化对象时,能找到class文件,但是class文件在序列化对象之后发生了修改,那么反序列化操作也会失败,抛出一个InvalidClassException异常。发生这个异常的原因如下:
-
该类的序列版本号与从流中读取的类描述符的版本号不匹配
-
该类包含未知数据类型
解决办法:
Serializable 接口给需要序列化的类,提供了一个序列版本号:serialVersionUID 。凡是实现 Serializable接口的类都应该有一个表示序列化版本标识符的静态变量:
static final long serialVersionUID = 234242343243L; //它的值由程序员随意指定即可。-
serialVersionUID用来表明类的不同版本间的兼容性。简单来说,Java的序列化机制是通过在运行时判断类的serialVersionUID来验证版本一致性的。在进行反序列化时,JVM会把传来的字节流中的serialVersionUID与本地相应实体类的serialVersionUID进行比较,如果相同就认为是一致的,可以进行反序列化,否则就会出现序列化版本不一致的异常(InvalidCastException)。
-
如果类没有显示定义这个静态常量,它的值是Java运行时环境根据类的内部细节
自动生成的。若类的实例变量做了修改,serialVersionUID可能发生变化。因此,建议显式声明。 -
如果声明了serialVersionUID,即使在序列化完成之后修改了类导致类重新编译,则原来的数据也能正常反序列化,只是新增的字段值是默认值而已。
import java.io.Serializable;
public class Employee implements Serializable {
private static final long serialVersionUID = 1324234L; //增加serialVersionUID
//其它结构:略
}其他流的使用
标准输入/输出流
-
System.in和System.out分别代表了系统标准的输入和输出设备
-
默认输入设备是:键盘,输出设备是:显示器
-
System.in的类型是InputStream
-
System.out的类型是PrintStream,其是OutputStream的子类FilterOutputStream 的子类
-
重定向:通过System类的setIn,setOut方法对默认设备进行改变。
-
public static void setIn(InputStream in)
-
public static void setOut(PrintStream out)
举例:
从键盘输入字符串,要求将读取到的整行字符串转成大写输出。然后继续进行输入操作,直至当输入“e”或者“exit”时,退出程序。
System.out.println("请输入信息(退出输入e或exit):");
// 把"标准"输入流(键盘输入)这个字节流包装成字符流,再包装成缓冲流
BufferedReader br = new BufferedReader(new InputStreamReader(System.in));
String s = null;
try {
while ((s = br.readLine()) != null) { // 读取用户输入的一行数据 --> 阻塞程序
if ("e".equalsIgnoreCase(s) || "exit".equalsIgnoreCase(s)) {
System.out.println("安全退出!!");
break;
}
// 将读取到的整行字符串转成大写输出
System.out.println("-->:" + s.toUpperCase());
System.out.println("继续输入信息");
}
} catch (IOException e) {
e.printStackTrace();
} finally {
try {
if (br != null) {
br.close(); // 关闭过滤流时,会自动关闭它包装的底层节点流
}
} catch (IOException e) {
e.printStackTrace();
}
}拓展:
System类中有三个常量对象:System.out、System.in、System.err
查看System类中这三个常量对象的声明:
public final static InputStream in = null;
public final static PrintStream out = null;
public final static PrintStream err = null;奇怪的是:
-
这三个常量对象有final声明,但是却初始化为null。final声明的常量一旦赋值就不能修改,那么null不会空指针异常吗?
-
这三个常量对象为什么要小写?final声明的常量按照命名规范不是应该大写吗?
-
这三个常量的对象有set方法?final声明的常量不是不能修改值吗?set方法是如何修改它们的值的?
public static void setOut(PrintStream out) {
checkIO();
setOut0(out);
}
public static void setErr(PrintStream err) {
checkIO();
setErr0(err);
}
public static void setIn(InputStream in) {
checkIO();
setIn0(in);
}
private static void checkIO() {
SecurityManager sm = getSecurityManager();
if (sm != null) {
sm.checkPermission(new RuntimePermission("setIO"));
}
}
private static native void setIn0(InputStream in);
private static native void setOut0(PrintStream out);
private static native void setErr0(PrintStream err);打印流
实现将基本数据类型的数据格式转化为字符串输出。
打印流:PrintStream和PrintWriter
提供了一系列重载的print()和println()方法,用于多种数据类型的输出
PrintStream和PrintWriter的输出不会抛出IOException异常
PrintStream和PrintWriter有自动flush功能
PrintStream 打印的所有字符都使用平台的默认字符编码转换为字节。在需要写入字符而不是写入字节的情况下,应该使用 PrintWriter 类。
System.out返回的是PrintStream的实例
构造器
-
PrintStream(File file) :创建具有指定文件且不带自动行刷新的新打印流。
-
PrintStream(File file, String csn):创建具有指定文件名称和字符集且不带自动行刷新的新打印流。
-
PrintStream(OutputStream out) :创建新的打印流。
-
PrintStream(OutputStream out, boolean autoFlush):创建新的打印流。 autoFlush如果为 true,则每当写入 byte 数组、调用其中一个 println 方法或写入换行符或字节 ('\n') 时都会刷新输出缓冲区。
-
PrintStream(OutputStream out, boolean autoFlush, String encoding) :创建新的打印流。
-
PrintStream(String fileName):创建具有指定文件名称且不带自动行刷新的新打印流。
-
PrintStream(String fileName, String csn) :创建具有指定文件名称和字符集且不带自动行刷新的新打印流。
例如:
package com.atguigu.systemio;
import java.io.FileNotFoundException;
import java.io.PrintStream;
public class TestPrintStream {
public static void main(String[] args) throws FileNotFoundException {
PrintStream ps = new PrintStream("io.txt");
ps.println("hello");
ps.println(1);
ps.println(1.5);
ps.close();
}
}Scanner类
构造方法
-
Scanner(File source) :构造一个新的 Scanner,它生成的值是从指定文件扫描的。
-
Scanner(File source, String charsetName) :构造一个新的 Scanner,它生成的值是从指定文件扫描的。
-
Scanner(InputStream source) :构造一个新的 Scanner,它生成的值是从指定的输入流扫描的。
-
Scanner(InputStream source, String charsetName) :构造一个新的 Scanner,它生成的值是从指定的输入流扫描的。
常用方法:
-
boolean hasNextXxx(): 如果通过使用nextXxx()方法,此扫描器输入信息中的下一个标记可以解释为默认基数中的一个 Xxx 值,则返回 true。
-
Xxx nextXxx(): 将输入信息的下一个标记扫描为一个Xxx
import org.junit.Test;
import java.io.*;
import java.util.Scanner;
public class TestScanner {
@Test
public void test01() throws IOException {
Scanner input = new Scanner(System.in);
PrintStream ps = new PrintStream("1.txt");
while(true){
System.out.print("请输入一个单词:");
String str = input.nextLine();
if("stop".equals(str)){
break;
}
ps.println(str);
}
input.close();
ps.close();
}
@Test
public void test2() throws IOException {
Scanner input = new Scanner(new FileInputStream("1.txt"));
while(input.hasNextLine()){
String str = input.nextLine();
System.out.println(str);
}
input.close();
}
}网络编程
概述
Java是 Internet 上的语言,它从语言级上提供了对网络应用程序的支持,程序员能够很容易开发常见的网络应用程序。
Java提供的网络类库,可以实现无痛的网络连接,联网的底层细节被隐藏在 Java 的本机安装系统里,由 JVM 进行控制。并且 Java 实现了一个跨平台的网络库,程序员面对的是一个统一的网络编程环境。
软件架构
C/S架构 :全称为Client/Server结构,是指客户端和服务器结构。常见程序有QQ、美团app、360安全卫士等软件。
B/S架构 :全称为Browser/Server结构,是指浏览器和服务器结构。常见浏览器有IE、谷歌、火狐等。
两种架构各有优势,但是无论哪种架构,都离不开网络的支持。网络编程,就是在一定的协议下,实现两台计算机的通信的程序。
网络基础
-
计算机网络: 把分布在不同地理区域的计算机与专门的外部设备用通信线路互连成一个规模大、功能强的网络系统,从而使众多的计算机可以方便地互相传递信息、共享硬件、软件、数据信息等资源。
-
**网络编程的目的:**直接或间接地通过网络协议与其它计算机实现数据交换,进行通讯。
-
网络编程中有三个主要的问题:
-
问题1:如何准确地定位网络上一台或多台主机
-
问题2:如何定位主机上的特定的应用
-
问题3:找到主机后,如何可靠、高效地进行数据传输
网络通讯要素
如何实现网络中的主机相互通信
-
通信双方地址
-
IP
-
端口号
-
一定的规则:不同的硬件、操作系统之间的通信,所有的这一切都需要一种规则。而我们就把这种规则称为协议,即网络通信协议。
IP 地址和域名
IP地址:指互联网协议地址(Internet Protocol Address),俗称IP。IP地址用来给网络中的一台计算机设备做唯一的编号。假如我们把“个人电脑”比作“一台电话”的话,那么“IP地址”就相当于“电话号码”。
IP地址分类方式一:
-
IPv4:是一个32位的二进制数,通常被分为4个字节,表示成a.b.c.d的形式,以点分十进制表示,例如192.168.65.100。其中a、b、c、d都是0~255之间的十进制整数。 -
这种方式最多可以表示42亿个。其中,30亿都在北美,亚洲4亿,中国2.9亿。2011年初已经用尽。
-
IP地址 = 网络地址 +主机地址
-
网络地址:标识计算机或网络设备所在的网段
-
主机地址:标识特定主机或网络设备
-
IPv6:由于互联网的蓬勃发展,IP地址的需求量愈来愈大,但是网络地址资源有限,使得IP的分配越发紧张。 为了扩大地址空间,拟通过IPv6重新定义地址空间,采用128位地址长度,共16个字节,写成8个无符号整数,每个整数用四个十六进制位表示,数之间用冒号(:)分开。比如:ABCD:EF01:2345:6789:ABCD:EF01:2345:6789,按保守方法估算IPv6实际可分配的地址,整个地球的每平方米面积上仍可分配1000多个地址,这样就解决了网络地址资源数量不够的问题。2012年6月6日,国际互联网协会举行了世界IPv6启动纪念日,这一天,全球IPv6网络正式启动。多家知名网站,如Google、Facebook和Yahoo等,于当天全球标准时间0点(北京时间8点整)开始永久性支持IPv6访问。2018年6月,三大运营商联合阿里云宣布,将全面对外提供IPv6服务,并计划在2025年前助推中国互联网真正实现“IPv6 Only”。 在IPv6的设计过程中除了一劳永逸地解决了地址短缺问题以外,还考虑了在IPv4中解决不好的其它问题,主要有端到端IP连接、服务质量(QoS)、安全性、多播、移动性、即插即用等。
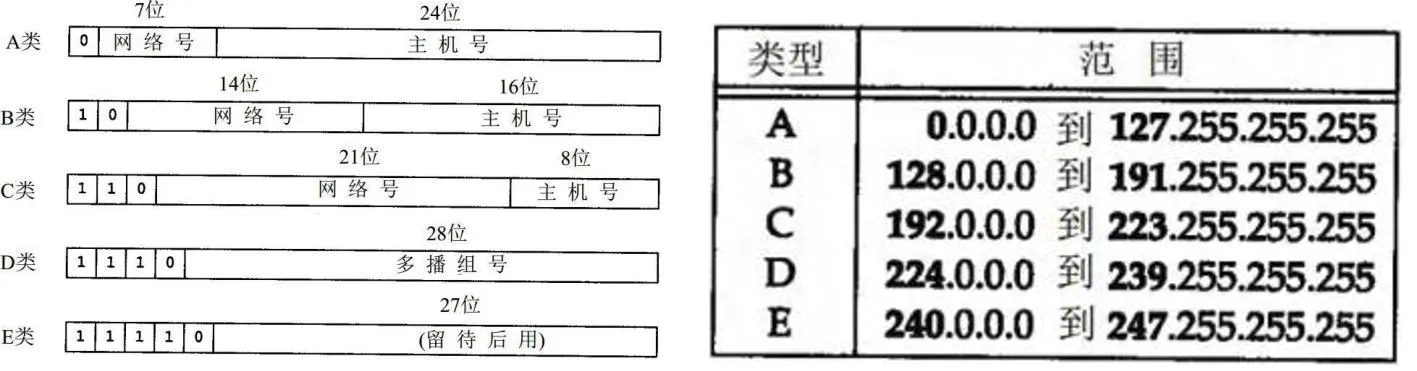
IP地址分类方式二:
公网地址( 万维网使用)和 私有地址( 局域网使用)。192.168.开头的就是私有地址,范围即为192.168.0.0--192.168.255.255,专门为组织机构内部使用。
常用命令:
-
查看本机IP地址,在控制台输入:
ipconfig -
检查网络是否连通,在控制台输入:
ping 空格 IP地址
ping 220.181.57.216特殊的IP地址:
-
本地回环地址(hostAddress):
127.0.0.1 -
主机名(hostName):
localhost
域名
Internet上的主机有两种方式表示地址:
-
域名(hostName):www.atguigu.com
-
IP 地址(hostAddress):202.108.35.210
**域名解析:**因为IP地址数字不便于记忆,因此出现了域名。域名容易记忆,当在连接网络时输入一个主机的域名后,域名服务器(DNS,Domain Name System,域名系统)负责将域名转化成IP地址,这样才能和主机建立连接。
简单理解:
详细理解:
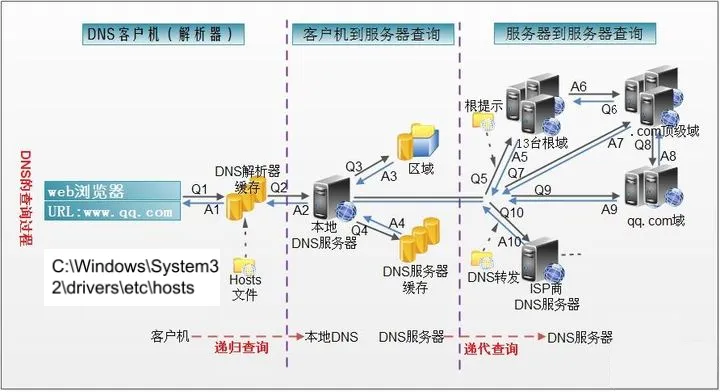
-
在浏览器中输入www . qq .com 域名,操作系统会先检查自己本地的
hosts文件是否有这个网址映射关系,如果有,就先调用这个IP地址映射,完成域名解析。 -
如果hosts里没有这个域名的映射,则查找
本地DNS解析器缓存,是否有这个网址映射关系,如果有,直接返回,完成域名解析。 -
如果hosts与本地DNS解析器缓存都没有相应的网址映射关系,首先会找TCP/IP参数中设置的首选DNS服务器,在此我们叫它
本地DNS服务器,此服务器收到查询时,如果要查询的域名,包含在本地配置区域资源中,则返回解析结果给客户机,完成域名解析,此解析具有权威性。 -
如果要查询的域名,不由本地DNS服务器区域解析,但该服务器已
缓存了此网址映射关系,则调用这个IP地址映射,完成域名解析,此解析不具有权威性。 -
如果本地DNS服务器本地区域文件与缓存解析都失效,则根据本地DNS服务器的设置(是否设置转发器)进行查询,如果未用转发模式,本地DNS就把请求发至13台根DNS,根DNS服务器收到请求后会判断这个域名(.com)是谁来授权管理,并会返回一个负责该顶级域名服务器的一个IP。本地DNS服务器收到IP信息后,将会联系负责.com域的这台服务器。这台负责.com域的服务器收到请求后,如果自己无法解析,它就会找一个管理.com域的下一级DNS服务器地址(http://qq.com)给本地DNS服务器。当本地DNS服务器收到这个地址后,就会找(http://qq.com)域服务器,重复上面的动作,进行查询,直至找到www.qq.com主机。
-
如果用的是转发模式,此DNS服务器就会把请求转发至上一级DNS服务器,由上一级服务器进行解析,上一级服务器如果不能解析,或找根DNS或把转请求转至上上级,以此循环。不管是本地DNS服务器用是是转发,还是根提示,最后都是把结果返回给本地DNS服务器,由此DNS服务器再返回给客户机。
端口号
网络的通信,本质上是两个进程(应用程序)的通信。每台计算机都有很多的进程,那么在网络通信时,如何区分这些进程呢?
如果说IP地址可以唯一标识网络中的设备,那么端口号就可以唯一标识设备中的进程(应用程序)。
不同的进程,设置不同的端口号。
-
端口号:用两个字节表示的整数,它的取值范围是0~65535。
-
公认端口:0~1023。被预先定义的服务通信占用,如:HTTP(80),FTP(21),Telnet(23)
-
注册端口:1024~49151。分配给用户进程或应用程序。如:Tomcat(8080),MySQL(3306),Oracle(1521)。
-
动态/ 私有端口:49152~65535。
如果端口号被另外一个服务或应用所占用,会导致当前程序启动失败。
网络通讯协议
通过计算机网络可以使多台计算机实现连接,位于同一个网络中的计算机在进行连接和通信时需要遵守一定的规则,这就好比在道路中行驶的汽车一定要遵守交通规则一样。
网络通信协议:在计算机网络中,这些连接和通信的规则被称为网络通信协议,它对数据的传输格式、传输速率、传输步骤、出错控制等做了统一规定,通信双方必须同时遵守才能完成数据交换。
新的问题:网络协议涉及内容太多、太复杂。如何解决?
计算机网络通信涉及内容很多,比如指定源地址和目标地址,加密解密,压缩解压缩,差错控制,流量控制,路由控制,如何实现如此复杂的网络协议呢?通信协议分层思想。
在制定协议时,把复杂成份分解成一些简单的成份,再将它们复合起来。最常用的复合方式是层次方式,即同层间可以通信、上一层可以调用下一层,而与再下一层不发生关系。各层互不影响,利于系统的开发和扩展。
这里有两套参考模型
-
OSI参考模型:模型过于理想化,未能在因特网上进行广泛推广
-
TCP/IP参考模型(或TCP/IP协议):事实上的国际标准。
上图中,OSI参考模型:模型过于理想化,未能在因特网上进行广泛推广。 TCP/IP参考模型(或TCP/IP协议):事实上的国际标准。
- TCP/IP协议: 传输控制协议/因特网互联协议( Transmission Control Protocol/Internet Protocol),TCP/IP 以其两个主要协议:传输控制协议(TCP)和网络互联协议(IP)而得名,实际上是一组协议,包括多个具有不同功能且互为关联的协议。是Internet最基本、最广泛的协议。
TCP/IP协议中的四层介绍:
-
应用层:应用层决定了向用户提供应用服务时通信的活动。主要协议有:HTTP协议、FTP协议、SNMP(简单网络管理协议)、SMTP(简单邮件传输协议)和POP3(Post Office Protocol 3的简称,即邮局协议的第3个版)等。 -
传输层:主要使网络程序进行通信,在进行网络通信时,可以采用TCP协议,也可以采用UDP协议。TCP(Transmission Control Protocol)协议,即传输控制协议,是一种面向连接的、可靠的、基于字节流的传输层通信协议。UDP(User Datagram Protocol,用户数据报协议):是一个无连接的传输层协议、提供面向事务的简单不可靠的信息传送服务。 -
网络层:网络层是整个TCP/IP协议的核心,支持网间互连的数据通信。它主要用于将传输的数据进行分组,将分组数据发送到目标计算机或者网络。而IP协议是一种非常重要的协议。IP(internet protocal)又称为互联网协议。IP的责任就是把数据从源传送到目的地。它在源地址和目的地址之间传送一种称之为数据包的东西,它还提供对数据大小的重新组装功能,以适应不同网络对包大小的要求。 -
物理+数据链路层:链路层是用于定义物理传输通道,通常是对某些网络连接设备的驱动协议,例如针对光纤、网线提供的驱动。
TCP 与 UDP
通信的协议还是比较复杂的,java.net 包中包含的类和接口,它们提供低层次的通信细节。我们可以直接使用这些类和接口,来专注于网络程序开发,而不用考虑通信的细节。
java.net 包中提供了两种常见的网络协议的支持:
-
UDP:用户数据报协议(User Datagram Protocol)。
-
TCP:传输控制协议 (Transmission Control Protocol)。
TCP协议与UDP协议
TCP协议:
-
TCP协议进行通信的两个应用进程:客户端、服务端。
-
使用TCP协议前,须先
建立TCP连接,形成基于字节流的传输数据通道 -
传输前,采用“三次握手”方式,点对点通信,是
可靠的 -
TCP协议使用
重发机制,当一个通信实体发送一个消息给另一个通信实体后,需要收到另一个通信实体确认信息,如果没有收到另一个通信实体确认信息,则会再次重复刚才发送的消息。 -
在连接中可进行
大数据量的传输 -
传输完毕,需
释放已建立的连接,效率低
UDP协议:
-
UDP协议进行通信的两个应用进程:发送端、接收端。
-
将数据、源、目的封装成数据包(传输的基本单位),
不需要建立连接 -
发送不管对方是否准备好,接收方收到也不确认,不能保证数据的完整性,故是
不可靠的 -
每个数据报的大小限制在
64K内 -
发送数据结束时
无需释放资源,开销小,通信效率高 -
适用场景:音频、视频和普通数据的传输。例如视频会议
三次握手
TCP协议中,在发送数据的准备阶段,客户端与服务器之间的三次交互,以保证连接的可靠。
-
第一次握手,客户端向服务器端发起TCP连接的请求
-
第二次握手,服务器端发送针对客户端TCP连接请求的确认
-
第三次握手,客户端发送确认的确认
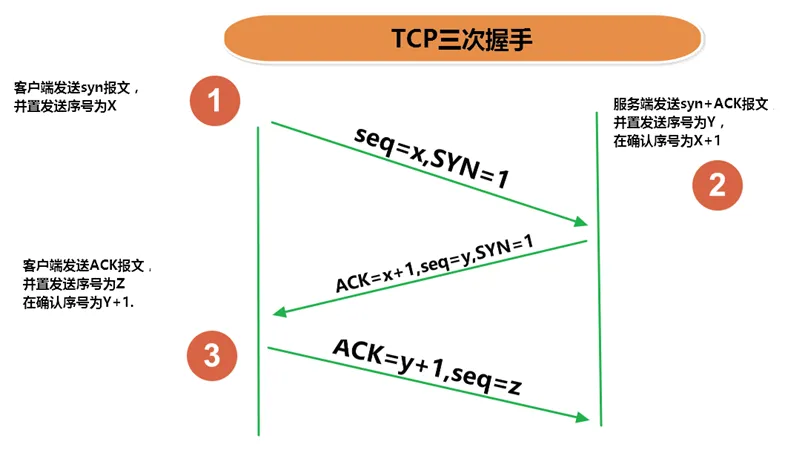
1、客户端会随机一个初始序列号seq=x,设置SYN=1 ,表示这是SYN握手报文。然后就可以把这个 SYN 报文发送给服务端了,表示向服务端发起连接,之后客户端处于
同步已发送状态。2、服务端收到客户端的 SYN 报文后,也随机一个初始序列号(seq=y),设置ack=x+1,表示收到了客户端的x之前的数据,希望客户端下次发送的数据从x+1开始。 设置 SYN=1 和 ACK=1。表示这是一个SYN握手和ACK确认应答报文。最后把该报文发给客户端,该报文也不包含应用层数据,之后服务端处于
同步已接收状态。3、客户端收到服务端报文后,还要向服务端回应最后一个应答报文,将ACK置为 1 ,表示这是一个应答报文 ack=y+1 ,表示收到了服务器的y之前的数据,希望服务器下次发送的数据从y+1开始。 最后把报文发送给服务端,这次报文可以携带数据,之后客户端处于 连接已建立 状态。服务器收到客户端的应答报文后,也进入
连接已建立状态。
完成三次握手,连接建立后,客户端和服务器就可以开始进行数据传输了。由于这种面向连接的特性,TCP协议可以保证传输数据的安全,所以应用十分广泛,例如下载文件、浏览网页等。
四次挥手
TCP协议中,在发送数据结束后,释放连接时需要经过四次挥手。
-
第一次挥手:客户端向服务器端提出结束连接,
让服务器做最后的准备工作。此时,客户端处于半关闭状态,即表示不再向服务器发送数据了,但是还可以接受数据。 -
第二次挥手:服务器接收到客户端释放连接的请求后,
会将最后的数据发给客户端。并告知上层的应用进程不再接收数据。 -
第三次挥手:服务器发送完数据后,会给客户端
发送一个释放连接的报文。那么客户端接收后就知道可以正式释放连接了。 -
第四次挥手:客户端接收到服务器最后的释放连接报文后,要
回复一个彻底断开的报文。这样服务器收到后才会彻底释放连接。这里客户端,发送完最后的报文后,会等待2MSL,因为有可能服务器没有收到最后的报文,那么服务器迟迟没收到,就会再次给客户端发送释放连接的报文,此时客户端在等待时间范围内接收到,会重新发送最后的报文,并重新计时。如果等待2MSL后,没有收到,那么彻底断开。
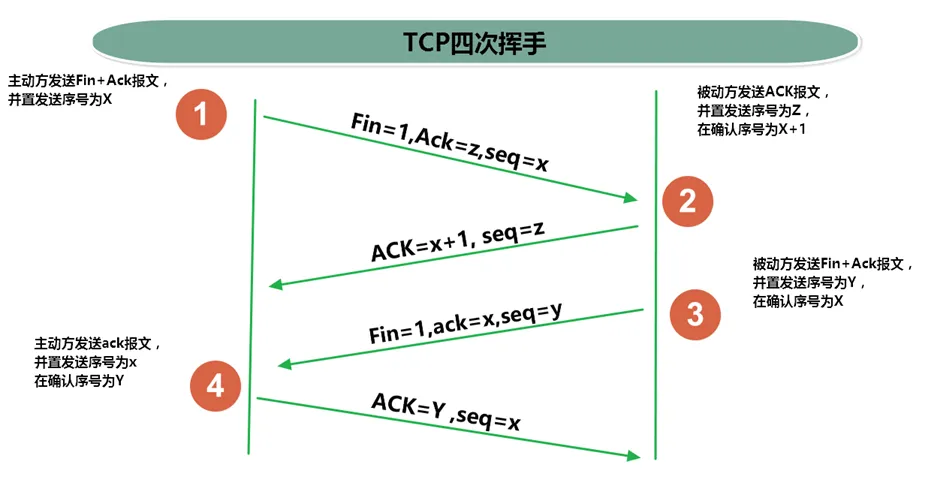
1、客户端打算断开连接,向服务器发送FIN报文(FIN标记位被设置为1,1表示为FIN,0表示不是),FIN报文中会指定一个序列号,之后客户端进入FIN_WAIT_1状态。也就是客户端发出连接释放报文段(FIN报文),指定序列号seq = u,主动关闭TCP连接,等待服务器的确认。
2、服务器收到连接释放报文段(FIN报文)后,就向客户端发送ACK应答报文,以客户端的FIN报文的序列号 seq+1 作为ACK应答报文段的确认序列号ack = seq+1 = u + 1。接着服务器进入CLOSE_WAIT(等待关闭)状态,此时的TCP处于半关闭状态(下面会说什么是半关闭状态),客户端到服务器的连接释放。客户端收到来自服务器的ACK应答报文段后,进入FIN_WAIT_2状态。
3、服务器也打算断开连接,向客户端发送连接释放(FIN)报文段,之后服务器进入LASK_ACK(最后确认)状态,等待客户端的确认。服务器的连接释放(FIN)报文段的FIN=1,ACK=1,序列号seq=m,确认序列号ack=u+1。
4、客户端收到来自服务器的连接释放(FIN)报文段后,会向服务器发送一个ACK应答报文段,以连接释放(FIN)报文段的确认序号 ack 作为ACK应答报文段的序列号 seq,以连接释放(FIN)报文段的序列号 seq+1作为确认序号ack。
之后客户端进入TIME_WAIT(时间等待)状态,服务器收到ACK应答报文段后,服务器就进入CLOSE(关闭)状态,到此服务器的连接已经完成关闭。客户端处于TIME_WAIT状态时,此时的TCP还未释放掉,需要等待2MSL后,客户端才进入CLOSE状态。
网络编程 API
InetAddress 类
InetAddress类主要表示IP地址,两个子类:Inet4Address、Inet6Address。
InetAddress 类没有提供公共的构造器,而是提供 了 如下几个 静态方法来获取InetAddress 实例
-
public static InetAddress getLocalHost()
-
public static InetAddress getByName(String host)
-
public static InetAddress getByAddress(byte[] addr)
InetAddress 提供了如下几个常用的方法
-
public String getHostAddress() :返回 IP 地址字符串(以文本表现形式)
-
public String getHostName() :获取此 IP 地址的主机名
-
public boolean isReachable(int timeout):测试是否可以达到该地址
import java.net.InetAddress;
import java.net.UnknownHostException;
import org.junit.Test;
public class TestInetAddress {
@Test
public void test01() throws UnknownHostException{
InetAddress localHost = InetAddress.getLocalHost();
System.out.println(localHost);
}
@Test
public void test02()throws UnknownHostException{
InetAddress atguigu = InetAddress.getByName("www.atguigu.com");
System.out.println(atguigu);
}
@Test
public void test03()throws UnknownHostException{
// byte[] addr = {112,54,108,98};
byte[] addr = {(byte)192,(byte)168,24,56};
InetAddress atguigu = InetAddress.getByAddress(addr);
System.out.println(atguigu);
}
}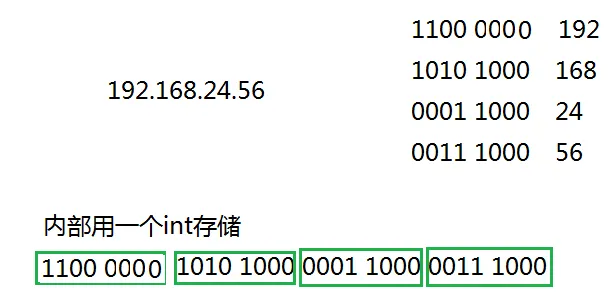
Socket 类
-
网络上具有唯一标识的IP地址和端口号组合在一起构成唯一能识别的标识符套接字(Socket)。
-
利用套接字(Socket)开发网络应用程序早已被广泛的采用,以至于成为事实上的标准。网络通信其实就是Socket间的通信。
-
通信的两端都要有Socket,是两台机器间通信的端点。
-
Socket允许程序把网络连接当成一个流,数据在两个Socket间通过IO传输。
-
一般主动发起通信的应用程序属客户端,等待通信请求的为服务端。
-
Socket分类:
-
流套接字(stream socket):使用TCP提供可依赖的字节流服务
-
ServerSocket:此类实现TCP服务器套接字。服务器套接字等待请求通过网络传入。
-
Socket:此类实现客户端套接字(也可以就叫“套接字”)。套接字是两台机器间通信的端点。
-
数据报套接字(datagram socket):使用UDP提供“尽力而为”的数据报服务
-
DatagramSocket:此类表示用来发送和接收UDP数据报包的套接字。
Socket相关类 API
ServerSocket 类
-
ServerSocket(int port) :创建绑定到特定端口的服务器套接字。
-
Socket accept():侦听并接受到此套接字的连接。
Socket类
Socket类的常用构造方法:
-
public Socket(InetAddress address,int port):创建一个流套接字并将其连接到指定 IP 地址的指定端口号。
-
public Socket(String host,int port):创建一个流套接字并将其连接到指定主机上的指定端口号。
Socket类的常用方法:
-
public InputStream getInputStream():返回此套接字的输入流,可以用于接收消息
-
public OutputStream getOutputStream():返回此套接字的输出流,可以用于发送消息
-
public InetAddress getInetAddress():此套接字连接到的远程 IP 地址;如果套接字是未连接的,则返回 null。
-
public InetAddress getLocalAddress():获取套接字绑定的本地地址。
-
public int getPort():此套接字连接到的远程端口号;如果尚未连接套接字,则返回 0。
-
public int getLocalPort():返回此套接字绑定到的本地端口。如果尚未绑定套接字,则返回 -1。
-
public void close():关闭此套接字。套接字被关闭后,便不可在以后的网络连接中使用(即无法重新连接或重新绑定)。需要创建新的套接字对象。 关闭此套接字也将会关闭该套接字的 InputStream 和 OutputStream。
-
public void shutdownInput():如果在套接字上调用 shutdownInput() 后从套接字输入流读取内容,则流将返回 EOF(文件结束符)。 即不能在从此套接字的输入流中接收任何数据。
-
public void shutdownOutput():禁用此套接字的输出流。对于 TCP 套接字,任何以前写入的数据都将被发送,并且后跟 TCP 的正常连接终止序列。 如果在套接字上调用 shutdownOutput() 后写入套接字输出流,则该流将抛出 IOException。 即不能通过此套接字的输出流发送任何数据。
**注意:**先后调用Socket的shutdownInput()和shutdownOutput()方法,仅仅关闭了输入流和输出流,并不等于调用Socket的close()方法。在通信结束后,仍然要调用Scoket的close()方法,因为只有该方法才会释放Socket占用的资源,比如占用的本地端口号等。
DatagramSocket 类
-
public DatagramSocket(int port)创建数据报套接字并将其绑定到本地主机上的指定端口。套接字将被绑定到通配符地址,IP 地址由内核来选择。
-
public DatagramSocket(int port,InetAddress laddr)创建数据报套接字,将其绑定到指定的本地地址。本地端口必须在 0 到 65535 之间(包括两者)。如果 IP 地址为 0.0.0.0,套接字将被绑定到通配符地址,IP 地址由内核选择。
-
public void close()关闭此数据报套接字。
-
public void send(DatagramPacket p)从此套接字发送数据报包。DatagramPacket 包含的信息指示:将要发送的数据、其长度、远程主机的 IP 地址和远程主机的端口号。
-
public void receive(DatagramPacket p)从此套接字接收数据报包。当此方法返回时,DatagramPacket 的缓冲区填充了接收的数据。数据报包也包含发送方的 IP 地址和发送方机器上的端口号。 此方法在接收到数据报前一直阻塞。数据报包对象的 length 字段包含所接收信息的长度。如果信息比包的长度长,该信息将被截短。
-
public InetAddress getLocalAddress()获取套接字绑定的本地地址。
-
public int getLocalPort()返回此套接字绑定的本地主机上的端口号。
-
public InetAddress getInetAddress()返回此套接字连接的地址。如果套接字未连接,则返回 null。
-
public int getPort()返回此套接字的端口。如果套接字未连接,则返回 -1。
DatagramPacket 类
-
public DatagramPacket(byte[] buf,int length)构造 DatagramPacket,用来接收长度为 length 的数据包。 length 参数必须小于等于 buf.length。
-
public DatagramPacket(byte[] buf,int length,InetAddress address,int port)构造数据报包,用来将长度为 length 的包发送到指定主机上的指定端口号。length 参数必须小于等于 buf.length。
-
public InetAddress getAddress()返回某台机器的 IP 地址,此数据报将要发往该机器或者是从该机器接收到的。
-
public int getPort()返回某台远程主机的端口号,此数据报将要发往该主机或者是从该主机接收到的。
-
public byte[] getData()返回数据缓冲区。接收到的或将要发送的数据从缓冲区中的偏移量 offset 处开始,持续 length 长度。 -
public int getLength()返回将要发送或接收到的数据的长度。
TCP 网络编程
通信模型
Java语言的基于套接字TCP编程分为服务端编程和客户端编程,其通信模型如图所示:
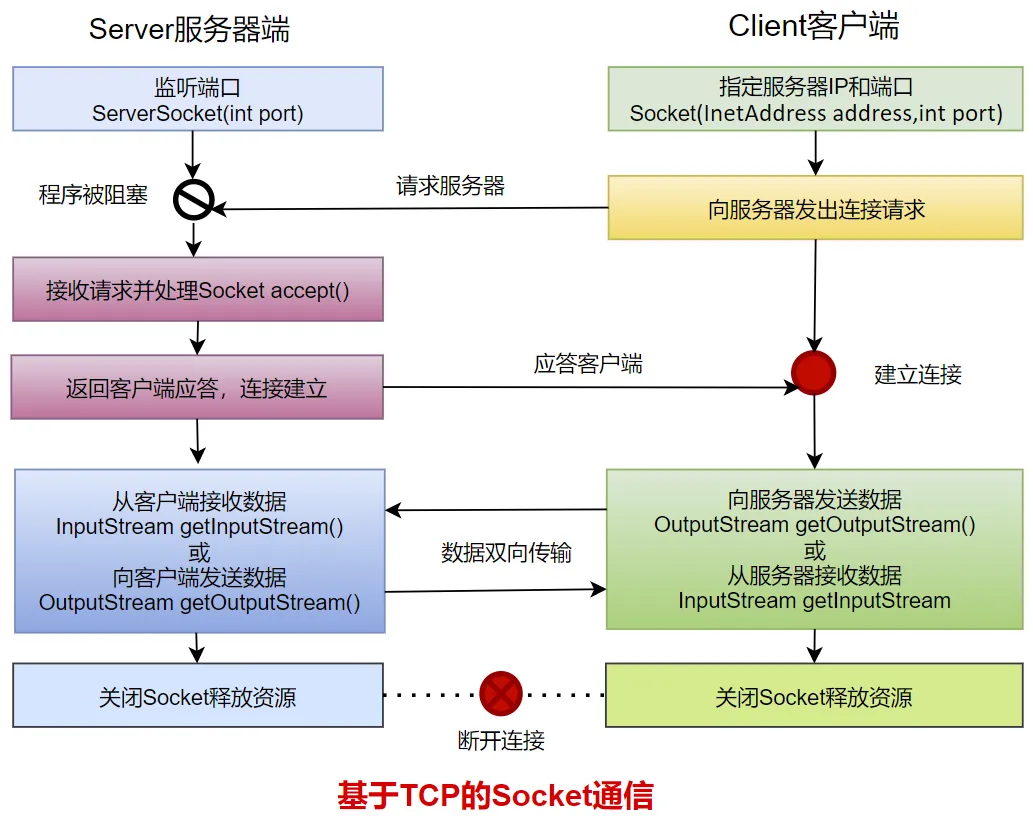
开发步骤
客户端程序包含以下四个基本的步骤 :
-
创建 Socket :根据指定服务端的 IP 地址或端口号构造 Socket 类对象。若服务器端响应,则建立客户端到服务器的通信线路。若连接失败,会出现异常。
-
打开连接到 Socket 的输入/ 出流: 使用 getInputStream()方法获得输入流,使用getOutputStream()方法获得输出流,进行数据传输
-
按照一定的协议对 Socket 进行读/ 写操作:通过输入流读取服务器放入线路的信息(但不能读取自己放入线路的信息),通过输出流将信息写入线路。
-
关闭 Socket :断开客户端到服务器的连接,释放线路
服务器端程序包含以下四个基本的 步骤:
调用 ServerSocket(int port) :创建一个服务器端套接字,并绑定到指定端口上。用于监听客户端的请求。
-
调用 accept() :监听连接请求,如果客户端请求连接,则接受连接,返回通信套接字对象。
-
调用 该Socket 类对象的 getOutputStream() 和 getInputStream () :获取输出流和输入流,开始网络数据的发送和接收。
-
关闭Socket 对象:客户端访问结束,关闭通信套接字。
UDP网络编程
UDP(User Datagram Protocol,用户数据报协议):是一个无连接的传输层协议、提供面向事务的简单不可靠的信息传送服务,类似于短信。
通信模型
UDP协议是一种面向非连接的协议,面向非连接指的是在正式通信前不必与对方先建立连接,不管对方状态就直接发送,至于对方是否可以接收到这些数据内容,UDP协议无法控制,因此说,UDP协议是一种不可靠的协议。无连接的好处就是快,省内存空间和流量,因为维护连接需要创建大量的数据结构。UDP会尽最大努力交付数据,但不保证可靠交付,没有TCP的确认机制、重传机制,如果因为网络原因没有传送到对端,UDP也不会给应用层返回错误信息。
UDP协议是面向数据报文的信息传送服务。UDP在发送端没有缓冲区,对于应用层交付下来的报文在添加了首部之后就直接交付于ip层,不会进行合并,也不会进行拆分,而是一次交付一个完整的报文。比如我们要发送100个字节的报文,我们调用一次send()方法就会发送100字节,接收方也需要用receive()方法一次性接收100字节,不能使用循环每次获取10个字节,获取十次这样的做法。
UDP协议没有拥塞控制,所以当网络出现的拥塞不会导致主机发送数据的速率降低。虽然UDP的接收端有缓冲区,但是这个缓冲区只负责接收,并不会保证UDP报文的到达顺序是否和发送的顺序一致。因为网络传输的时候,由于网络拥塞的存在是很大的可能导致先发的报文比后发的报文晚到达。如果此时缓冲区满了,后面到达的报文将直接被丢弃。这个对实时应用来说很重要,比如:视频通话、直播等应用。
因此UDP适用于一次只传送少量数据、对可靠性要求不高的应用环境,数据报大小限制在64K以下。
类 DatagramSocket 和 DatagramPacket 实现了基于 UDP 协议网络程序。
UDP数据报通过数据报套接字 DatagramSocket 发送和接收,系统不保证 UDP数据报一定能够安全送到目的地,也不能确定什么时候可以抵达。
DatagramPacket 对象封装了UDP数据报,在数据报中包含了发送端的IP地址和端口号以及接收端的IP地址和端口号。
UDP协议中每个数据报都给出了完整的地址信息,因此无须建立发送方和接收方的连接。如同发快递包裹一样。
开发步骤
发送端程序包含以下四个基本的步骤:
-
创建DatagramSocket :默认使用系统随机分配端口号。
-
创建DatagramPacket:将要发送的数据用字节数组表示,并指定要发送的数据长度,接收方的IP地址和端口号。
-
调用 该DatagramSocket 类对象的 send方法 :发送数据报DatagramPacket对象。
-
关闭DatagramSocket 对象:发送端程序结束,关闭通信套接字。
接收端程序包含以下四个基本的步骤 :
-
创建DatagramSocket :指定监听的端口号。
-
创建DatagramPacket:指定接收数据用的字节数组,起到临时数据缓冲区的效果,并指定最大可以接收的数据长度。
-
调用 该DatagramSocket 类对象的receive方法 :接收数据报DatagramPacket对象。。
-
关闭DatagramSocket :接收端程序结束,关闭通信套接字。
URL 编程
URL 类
-
URL(Uniform Resource Locator):统一资源定位符,它表示 Internet 上某一资源的地址。
-
通过 URL 我们可以访问 Internet 上的各种网络资源,比如最常见的 www,ftp 站点。浏览器通过解析给定的 URL 可以在网络上查找相应的文件或其他资源。
-
URL的基本结构由5部分组成:
<传输协议>://<主机名>:<端口号>/<文件名>#片段名?参数列表 -
为了表示URL,java.net 中实现了类 URL。我们可以通过下面的构造器来初始化一个 URL 对象:
-
public URL (String spec):通过一个表示URL地址的字符串可以构造一个URL对象。例如:
URL url = new URL("``http://www``. ``atguigu.com/``"); -
URL类的构造器都声明抛出非运行时异常,必须要对这一异常进行处理,通常是用 try-catch 语句进行捕获。
URL 类常用方法
一个URL对象生成后,其属性是不能被改变的,但可以通过它给定的方法来获取这些属性:
-
public String getProtocol( ) 获取该URL的协议名
-
public String getHost( ) 获取该URL的主机名
-
public String getPort( ) 获取该URL的端口号
-
public String getPath( ) 获取该URL的文件路径
-
public String getFile( ) 获取该URL的文件名
-
public String getQuery( ) 获取该URL的查询名
URL url = new URL("http://localhost:8080/examples/myTest.txt");
System.out.println("getProtocol() :"+url.getProtocol());
System.out.println("getHost() :"+url.getHost());
System.out.println("getPort() :"+url.getPort());
System.out.println("getPath() :"+url.getPath());
System.out.println("getFile() :"+url.getFile());
System.out.println("getQuery() :"+url.getQuery());针对 HTTP协议的 URLConnection 类
-
URL的方法 openStream():能从网络上读取数据
-
若希望输出数据,例如向服务器端的 CGI (公共网关接口-Common Gateway Interface-的简称,是用户浏览器和服务器端的应用程序进行连接的接口)程序发送一些数据,则必须先与URL建立连接,然后才能对其进行读写,此时需要使用 URLConnection 。
-
URLConnection:表示到URL所引用的远程对象的连接。当与一个URL建立连接时,首先要在一个 URL 对象上通过方法 openConnection() 生成对应的 URLConnection 对象。如果连接过程失败,将产生IOException.
-
URL netchinaren = new URL ("http://www.atguigu.com/index.shtml");
-
URLConnectonn u = netchinaren.openConnection( );
-
通过URLConnection对象获取的输入流和输出流,即可以与现有的CGI程序进行交互。
-
public Object getContent( ) throws IOException
-
public int getContentLength( )
-
public String getContentType( )
-
public long getDate( )
-
public long getLastModified( )
-
public InputStream getInputStream ( ) throws IOException
-
public OutputStream getOutputStream( )throws IOException
反射机制
Java程序中,所有的对象都有两种类型:编译时类型和运行时类型,而很多时候对象的编译时类型和运行时类型不一致。 Object obj = new String("hello"); obj.getClass()
例如:某些变量或形参的声明类型是Object类型,但是程序却需要调用该对象运行时类型的方法,该方法不是Object中的方法,那么如何解决呢?
解决这个问题,有两种方案:
方案1:在编译和运行时都完全知道类型的具体信息,在这种情况下,我们可以直接先使用instanceof运算符进行判断,再利用强制类型转换符将其转换成运行时类型的变量即可。
方案2:编译时根本无法预知该对象和类的真实信息,程序只能依靠运行时信息来发现该对象和类的真实信息,这就必须使用反射。
概述
Reflection(反射)是被视为动态语言的关键,反射机制允许程序在运行期间借助于Reflection API取得任何类的内部信息,并能直接操作任意对象的内部属性及方法。
加载完类之后,在堆内存的方法区中就产生了一个Class类型的对象(一个类只有一个Class对象),这个对象就包含了完整的类的结构信息。我们可以通过这个对象看到类的结构。这个对象就像一面镜子,透过这个镜子看到类的结构,所以,我们形象的称之为:反射。
从内存加载上看反射:
Java反射机制提供的功能:
-
在运行时判断任意一个对象所属的类
-
在运行时构造任意一个类的对象
-
在运行时判断任意一个类所具有的成员变量和方法
-
在运行时获取泛型信息
-
在运行时调用任意一个对象的成员变量和方法
-
在运行时处理注解
-
生成动态代理
反射的优缺点
优点:
-
提高了Java程序的灵活性和扩展性,
降低了耦合性,提高自适应能力 -
允许程序创建和控制任何类的对象,无需提前
硬编码目标类
缺点:
-
反射的
性能较低。 -
反射机制主要应用在对灵活性和扩展性要求很高的系统框架上
-
反射会
模糊程序内部逻辑,可读性较差。
理解Class类并获取Class 实例
要想解剖一个类,必须先要获取到该类的Class对象。而剖析一个类或用反射解决具体的问题就是使用相关API:
-
java.lang.Class
-
java.lang.reflect.*
所以,Class对象是反射的根源。
理解Class
在Object类中定义了以下的方法,此方法将被所有子类继承:
public final Class getClass()以上的方法返回值的类型是一个Class类,此类是Java反射的源头,实际上所谓反射从程序的运行结果来看也很好理解,即:可以通过对象反射求出类的名称。
对象照镜子后可以得到的信息:某个类的属性、方法和构造器、某个类到底实现了哪些接口。对于每个类而言,JRE 都为其保留一个不变的 Class 类型的对象。一个 Class 对象包含了特定某个结构(class/interface/enum/annotation/primitive type/void/[])的有关信息。
-
Class本身也是一个类
-
Class 对象只能由系统建立对象
-
一个加载的类在 JVM 中只会有一个Class实例
-
一个Class对象对应的是一个加载到JVM中的一个.class文件
-
每个类的实例都会记得自己是由哪个 Class 实例所生成
-
通过Class可以完整地得到一个类中的所有被加载的结构
-
Class类是Reflection的根源,针对任何你想动态加载、运行的类,唯有先获得相应的Class对象
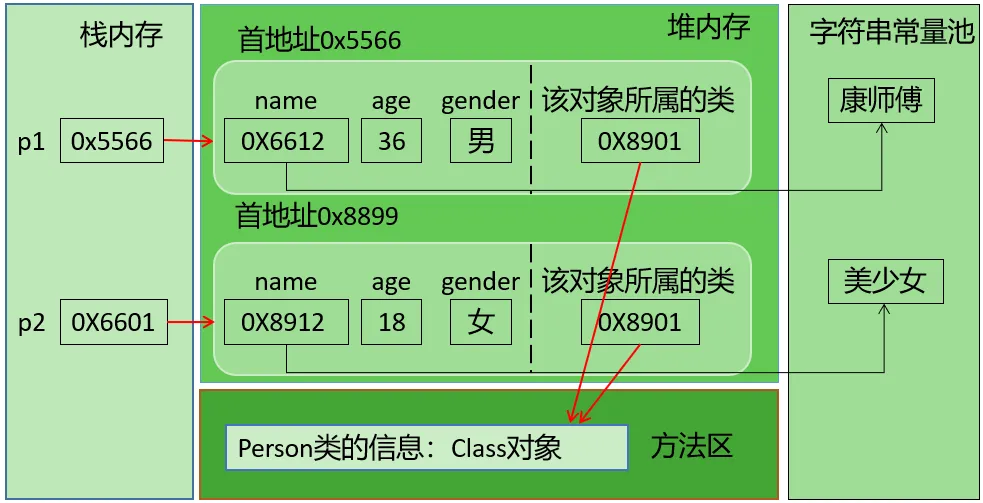
说明:上图中字符串常量池在JDK6中存储在方法区;JDK7及以后,存储在堆空间。
获取Class类的实例
方式1:要求编译期间已知类型
前提:若已知具体的类,通过类的class属性获取,该方法最为安全可靠,程序性能最高
实例:
Class clazz = String.class;方式2:获取对象的运行时类型
前提:已知某个类的实例,调用该实例的getClass()方法获取Class对象
实例:
Class clazz = "www.atguigu.com".getClass();方式3:可以获取编译期间未知的类型
前提:已知一个类的全类名,且该类在类路径下,可通过Class类的静态方法forName()获取,可能抛出ClassNotFoundException
实例:
Class clazz = Class.forName("java.lang.String");方式4:其他方式(不做要求)
前提:可以用系统类加载对象或自定义加载器对象加载指定路径下的类型
实例:
ClassLoader cl = this.getClass().getClassLoader();
Class clazz4 = cl.loadClass("类的全类名");常用方法
| 方法名 | 功能说明 |
|---|---|
| static Class forName(String name) | 返回指定类名 name 的 Class 对象 |
| Object newInstance() | 调用缺省构造函数,返回该Class对象的一个实例 |
| getName() | 返回此Class对象所表示的实体(类、接口、数组类、基本类型或void)名称 |
| Class getSuperClass() | 返回当前Class对象的父类的Class对象 |
| Class [] getInterfaces() | 获取当前Class对象的接口 |
| ClassLoader getClassLoader() | 返回该类的类加载器 |
| Class getSuperclass() | 返回表示此Class所表示的实体的超类的Class |
| Constructor[] getConstructors() | 返回一个包含某些Constructor对象的数组 |
| Field[] getDeclaredFields() | 返回Field对象的一个数组 |
| Method getMethod(String name,Class … paramTypes) | 返回一个Method对象,此对象的形参类型为paramType |
举例:
String str = "test4.Person";
Class clazz = Class.forName(str);
Object obj = clazz.newInstance();
Field field = clazz.getField("name");
field.set(obj, "Peter");
Object name = field.get(obj);
System.out.println(name);
//注:test4.Person是test4包下的Person类类的加载与 ClassLoader的理解
类的声明周期
类在内存中完整的生命周期:加载-->使用-->卸载。其中加载过程又分为:装载、链接、初始化三个阶段。
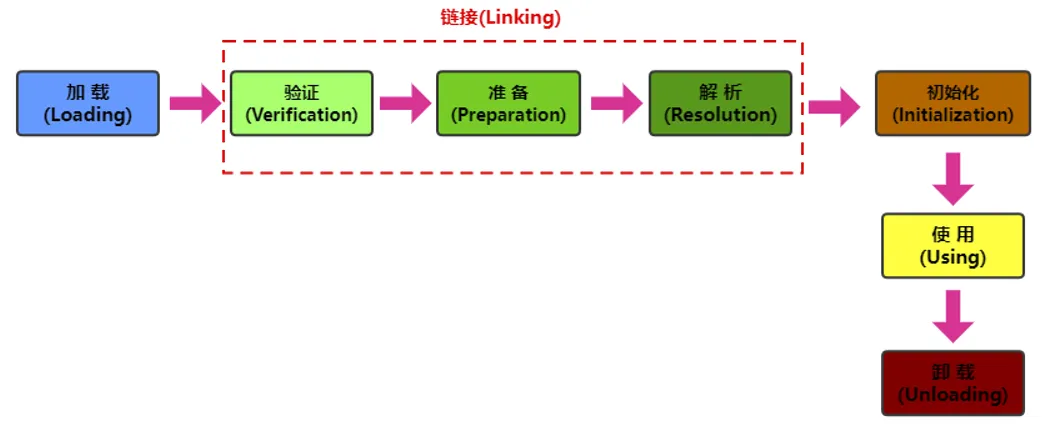
类的加载过程
当程序主动使用某个类时,如果该类还未被加载到内存中,系统会通过加载、链接、初始化三个步骤来对该类进行初始化。如果没有意外,JVM将会连续完成这三个步骤,所以有时也把这三个步骤统称为类加载。
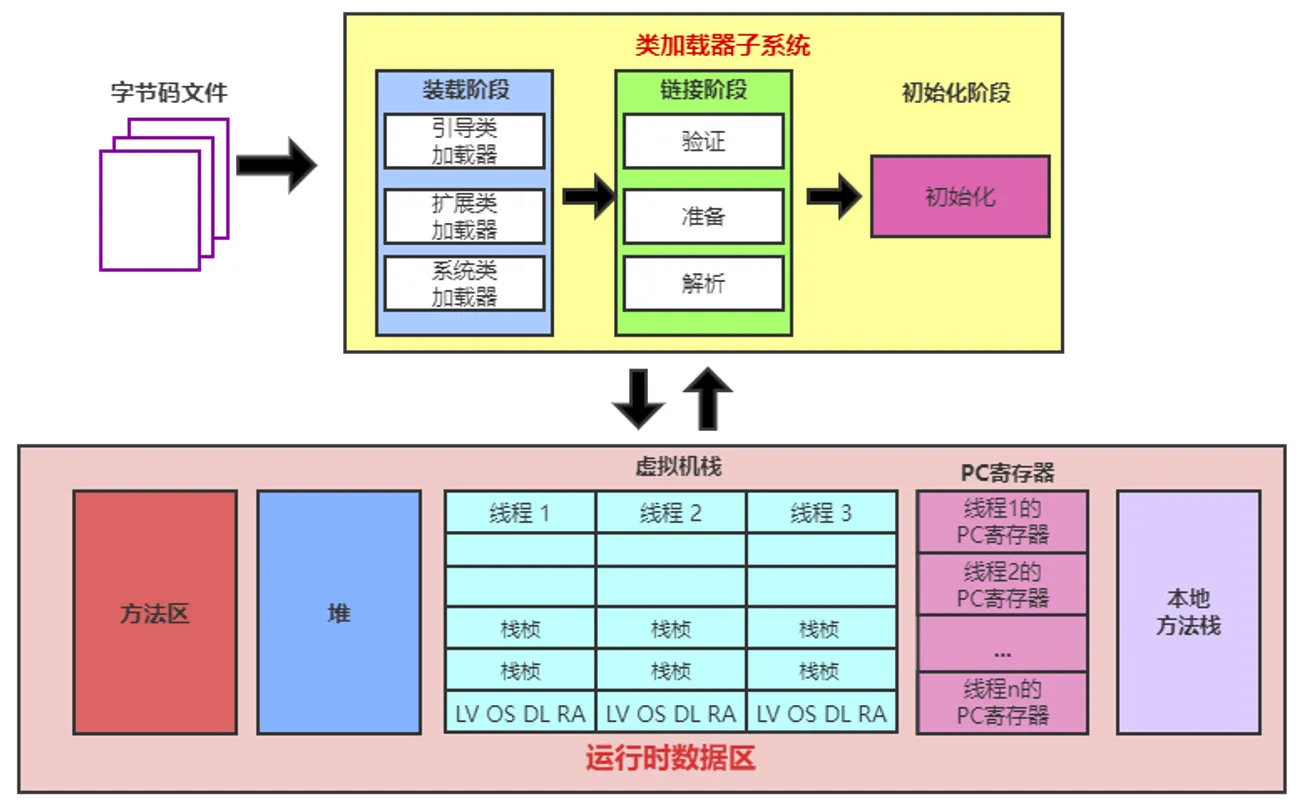
类的加载又分为三个阶段:
(1)装载(Loading)
将类的class文件读入内存,并为之创建一个java.lang.Class对象。此过程由类加载器完成
(2)链接(Linking)
①验证Verify:确保加载的类信息符合JVM规范,例如:以cafebabe开头,没有安全方面的问题。
②准备Prepare:正式为类变量(static)分配内存并设置类变量默认初始值的阶段,这些内存都将在方法区中进行分配。
③解析Resolve:虚拟机常量池内的符号引用(常量名)替换为直接引用(地址)的过程。
(3)初始化(Initialization)
-
执行
类构造器<clinit>()方法的过程。类构造器<clinit>()方法是由编译期自动收集类中所有类变量的赋值动作和静态代码块中的语句合并产生的。(类构造器是构造类信息的,不是构造该类对象的构造器)。 -
当初始化一个类的时候,如果发现其父类还没有进行初始化,则需要先触发其父类的初始化。
-
虚拟机会保证一个
类的<clinit>()方法在多线程环境中被正确加锁和同步。
类加载器(ClassLoader)
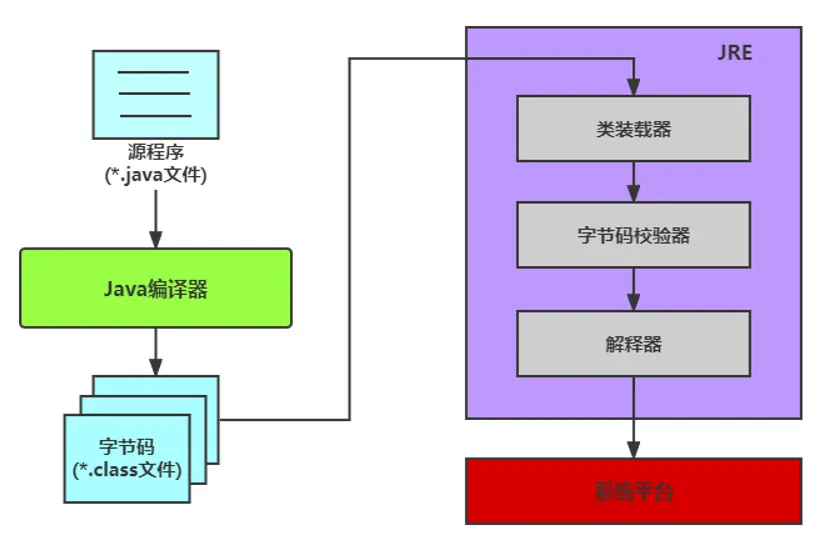
类加载器的作用
将class文件字节码内容加载到内存中,并将这些静态数据转换成方法区的运行时数据结构,然后在堆中生成一个代表这个类的java.lang.Class对象,作为方法区中类数据的访问入口。
类缓存:标准的JavaSE类加载器可以按要求查找类,但一旦某个类被加载到类加载器中,它将维持加载(缓存)一段时间。不过JVM垃圾回收机制可以回收这些Class对象。
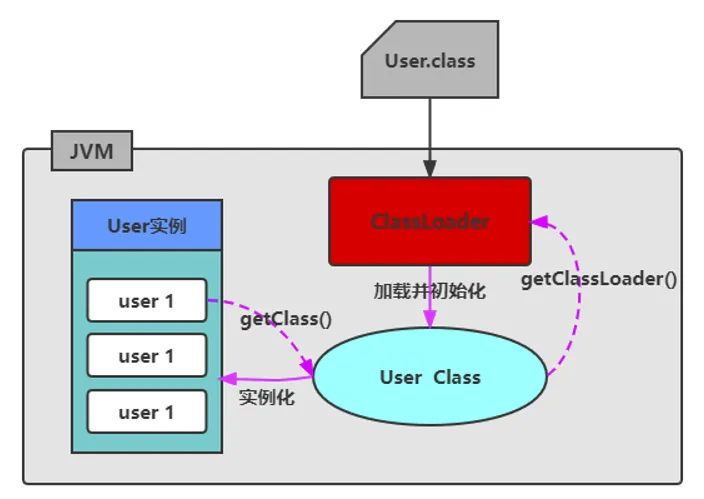
类加载器的分类(JDK8为例)
JVM支持两种类型的类加载器,分别为引导类加载器(Bootstrap ClassLoader)和自定义类加载器(User-Defined ClassLoader)。
从概念上来讲,自定义类加载器一般指的是程序中由开发人员自定义的一类类加载器,但是Java虚拟机规范却没有这么定义,而是将所有派生于抽象类ClassLoader的类加载器都划分为自定义类加载器。无论类加载器的类型如何划分,在程序中我们最常见的类加载器结构主要是如下情况:
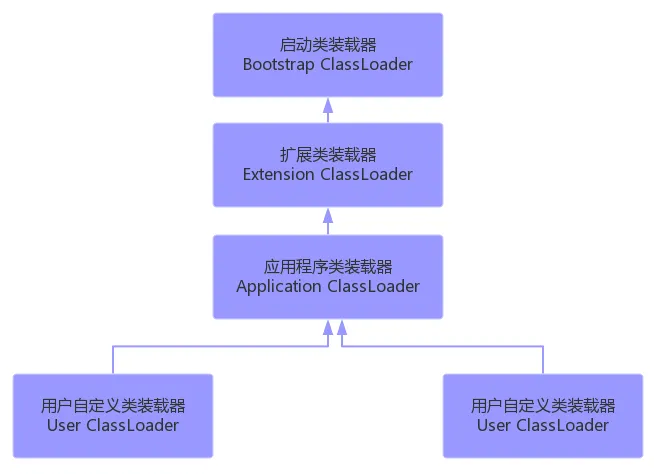
(1)启动类加载器(引导类加载器,Bootstrap ClassLoader)
-
这个类加载使用
C/C++语言实现的,嵌套在JVM内部。获取它的对象时往往返回null -
它用来加载Java的核心库(JAVA_HOME/jre/lib/rt.jar或sun.boot.class.path路径下的内容)。用于提供JVM自身需要的类。
-
并不继承自java.lang.ClassLoader,没有父加载器。
-
出于安全考虑,Bootstrap启动类加载器只加载包名为java、javax、sun等开头的类
-
加载扩展类和应用程序类加载器,并指定为他们的父类加载器。
(2)扩展类加载器(Extension ClassLoader)
-
Java语言编写,由sun.misc.Launcher$ExtClassLoader实现。
-
继承于ClassLoader类
-
父类加载器为启动类加载器
-
从java.ext.dirs系统属性所指定的目录中加载类库,或从JDK的安装目录的jre/lib/ext子目录下加载类库。如果用户创建的JAR放在此目录下,也会自动由扩展类加载器加载。
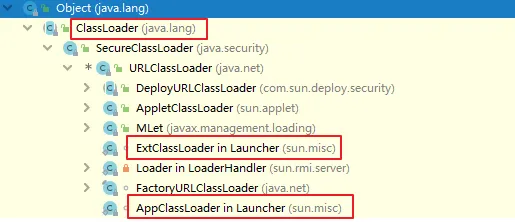
(3)应用程序类加载器(系统类加载器,AppClassLoader)
-
java语言编写,由sun.misc.Launcher$AppClassLoader实现
-
继承于ClassLoader类
-
父类加载器为扩展类加载器
-
它负责加载环境变量classpath或系统属性 java.class.path 指定路径下的类库
-
应用程序中的类加载器默认是系统类加载器。
-
它是用户自定义类加载器的默认父加载器
-
通过ClassLoader的getSystemClassLoader()方法可以获取到该类加载器
(4)用户自定义类加载器(了解)
-
在Java的日常应用程序开发中,类的加载几乎是由上述3种类加载器相互配合执行的。在必要时,我们还可以自定义类加载器,来定制类的加载方式。
-
体现Java语言强大生命力和巨大魅力的关键因素之一便是,Java开发者可以自定义类加载器来实现类库的动态加载,加载源可以是本地的JAR包,也可以是网络上的远程资源。
-
同时,自定义加载器能够实现
应用隔离,例如 Tomcat,Spring等中间件和组件框架都在内部实现了自定义的加载器,并通过自定义加载器隔离不同的组件模块。这种机制比C/C程序要好太多,想不修改C/C程序就能为其新增功能,几乎是不可能的,仅仅一个兼容性便能阻挡住所有美好的设想。 -
自定义类加载器通常需要继承于ClassLoader。
查看某个类的类加载器对象
(1)获取默认的系统类加载器
ClassLoader classloader = ClassLoader.getSystemClassLoader();(2)查看某个类是哪个类加载器加载的
ClassLoader classloader = Class.forName("exer2.ClassloaderDemo").getClassLoader();
//如果是根加载器加载的类,则会得到null
ClassLoader classloader1 = Class.forName("java.lang.Object").getClassLoader();(3)获取某个类加载器的父加载器
ClassLoader parentClassloader = classloader.getParent();示例代码:
import org.junit.Test;
public class TestClassLoader {
@Test
public void test01(){
ClassLoader systemClassLoader = ClassLoader.getSystemClassLoader();
System.out.println("systemClassLoader = " + systemClassLoader);
}
@Test
public void test02()throws Exception{
ClassLoader c1 = String.class.getClassLoader();
System.out.println("加载String类的类加载器:" + c1);
ClassLoader c2 = Class.forName("sun.util.resources.cldr.zh.TimeZoneNames_zh").getClassLoader();
System.out.println("加载sun.util.resources.cldr.zh.TimeZoneNames_zh类的类加载器:" + c2);
ClassLoader c3 = TestClassLoader.class.getClassLoader();
System.out.println("加载当前类的类加载器:" + c3);
}
@Test
public void test03(){
ClassLoader c1 = TestClassLoader.class.getClassLoader();
System.out.println("加载当前类的类加载器c1=" + c1);
ClassLoader c2 = c1.getParent();
System.out.println("c1.parent = " + c2);
ClassLoader c3 = c2.getParent();
System.out.println("c2.parent = " + c3);
}
}使用 ClassLoader获取流
关于类加载器的一个主要方法:getResourceAsStream(String str):获取类路径下的指定文件的输入流
InputStream in = null;
in = this.getClass().getClassLoader().getResourceAsStream("exer2\\test.properties");
System.out.println(in);举例:
//需要掌握如下的代码
@Test
public void test5() throws IOException {
Properties pros = new Properties();
//方式1:此时默认的相对路径是当前的module
// FileInputStream is = new FileInputStream("info.properties");
// FileInputStream is = new FileInputStream("src//info1.properties");
//方式2:使用类的加载器
//此时默认的相对路径是当前module的src目录
InputStream is = ClassLoader.getSystemClassLoader().getResourceAsStream("info1.properties");
pros.load(is);
//获取配置文件中的信息
String name = pros.getProperty("name");
String password = pros.getProperty("password");
System.out.println("name = " + name + ", password = " + password);
}反射的基本应用
创建运行时类的对象
这是反射机制应用最多的地方。创建运行时类的对象有两种方式:
方式1:直接调用Class对象的newInstance()方法
要 求: 1)类必须有一个无参数的构造器。2)类的构造器的访问权限需要足够。
方式2:通过获取构造器对象来进行实例化
方式一的步骤:
1)获取该类型的Class对象 2)调用Class对象的newInstance()方法创建对象
方式二的步骤:
1)通过Class类的getDeclaredConstructor(Class … parameterTypes)取得本类的指定形参类型的构造器
2)向构造器的形参中传递一个对象数组进去,里面包含了构造器中所需的各个参数。
3)通过Constructor实例化对象。
如果构造器的权限修饰符修饰的范围不可见,也可以调用setAccessible(true)
示例代码:
import org.junit.Test;
import java.lang.reflect.Constructor;
public class TestCreateObject {
@Test
public void test1() throws Exception{
// AtGuiguClass obj = new AtGuiguClass();//编译期间无法创建
Class<?> clazz = Class.forName("com.atguigu.ext.demo.AtGuiguClass");
//clazz代表com.atguigu.ext.demo.AtGuiguClass类型
//clazz.newInstance()创建的就是AtGuiguClass的对象
Object obj = clazz.newInstance();
System.out.println(obj);
}
@Test
public void test2()throws Exception{
Class<?> clazz = Class.forName("com.atguigu.ext.demo.AtGuiguDemo");
//java.lang.InstantiationException: com.atguigu.ext.demo.AtGuiguDemo
//Caused by: java.lang.NoSuchMethodException: com.atguigu.ext.demo.AtGuiguDemo.<init>()
//即说明AtGuiguDemo没有无参构造,就没有无参实例初始化方法<init>
Object stu = clazz.newInstance();
System.out.println(stu);
}
@Test
public void test3()throws Exception{
//(1)获取Class对象
Class<?> clazz = Class.forName("com.atguigu.ext.demo.AtGuiguDemo");
/*
* 获取AtGuiguDemo类型中的有参构造
* 如果构造器有多个,我们通常是根据形参【类型】列表来获取指定的一个构造器的
* 例如:public AtGuiguDemo(String title, int num)
*/
//(2)获取构造器对象
Constructor<?> constructor = clazz.getDeclaredConstructor(String.class,int.class);
//(3)创建实例对象
// T newInstance(Object... initargs) 这个Object...是在创建对象时,给有参构造的实参列表
Object obj = constructor.newInstance("尚硅谷",2022);
System.out.println(obj);
}
}获取运行时类的完整结构
可以获取:包、修饰符、类型名、父类(包括泛型父类)、父接口(包括泛型父接口)、成员(属性、构造器、方法)、注解(类上的、方法上的、属性上的)
相关 API
//1.实现的全部接口
public Class<?>[] getInterfaces()
//确定此对象所表示的类或接口实现的接口。
//2.所继承的父类
public Class<? Super T> getSuperclass()
//返回表示此 Class 所表示的实体(类、接口、基本类型)的父类的 Class。
//3.全部的构造器
public Constructor<T>[] getConstructors()
//返回此 Class 对象所表示的类的所有public构造方法。
public Constructor<T>[] getDeclaredConstructors()
//返回此 Class 对象表示的类声明的所有构造方法。
//Constructor类中:
//取得修饰符:
public int getModifiers();
//取得方法名称:
public String getName();
//取得参数的类型:
public Class<?>[] getParameterTypes();
//4.全部的方法
public Method[] getDeclaredMethods()
//返回此Class对象所表示的类或接口的全部方法
public Method[] getMethods()
//返回此Class对象所表示的类或接口的public的方法
//Method类中:
public Class<?> getReturnType()
//取得全部的返回值
public Class<?>[] getParameterTypes()
//取得全部的参数
public int getModifiers()
//取得修饰符
public Class<?>[] getExceptionTypes()
//取得异常信息
//5.全部的Field
public Field[] getFields()
//返回此Class对象所表示的类或接口的public的Field。
public Field[] getDeclaredFields()
//返回此Class对象所表示的类或接口的全部Field。
//Field方法中:
public int getModifiers()
//以整数形式返回此Field的修饰符
public Class<?> getType()
//得到Field的属性类型
public String getName()
//返回Field的名称。
//6. Annotation相关
get Annotation(Class<T> annotationClass)
getDeclaredAnnotations()
//7.泛型相关
//获取父类泛型类型:
Type getGenericSuperclass()
//泛型类型:ParameterizedType
//获取实际的泛型类型参数数组:
getActualTypeArguments()
//8.类所在的包
Package getPackage()获取所有属性和相关细节
import java.lang.reflect.Field;
import java.lang.reflect.Modifier;
import org.junit.Test;
import com.atguigu.java1.Person;
public class FieldTest {
@Test
public void test1(){
Class clazz = Person.class;
//getFields():获取到运行时类本身及其所有的父类中声明为public权限的属性
// Field[] fields = clazz.getFields();
//
// for(Field f : fields){
// System.out.println(f);
// }
//getDeclaredFields():获取当前运行时类中声明的所有属性
Field[] declaredFields = clazz.getDeclaredFields();
for(Field f : declaredFields){
System.out.println(f);
}
}
//权限修饰符 变量类型 变量名
@Test
public void test2(){
Class clazz = Person.class;
Field[] declaredFields = clazz.getDeclaredFields();
for(Field f : declaredFields){
//1.权限修饰符
/*
* 0x是十六进制
* PUBLIC = 0x00000001; 1 1
* PRIVATE = 0x00000002; 2 10
* PROTECTED = 0x00000004; 4 100
* STATIC = 0x00000008; 8 1000
* FINAL = 0x00000010; 16 10000
* ...
*
* 设计的理念,就是用二进制的某一位是1,来代表一种修饰符,整个二进制中只有一位是1,其余都是0
*
* mod = 17 0x00000011
* if ((mod & PUBLIC) != 0) 说明修饰符中有public
* if ((mod & FINAL) != 0) 说明修饰符中有final
*/
int modifier = f.getModifiers();
System.out.print(Modifier.toString(modifier) + "\t");
// //2.数据类型
Class type = f.getType();
System.out.print(type.getName() + "\t");
//
// //3.变量名
String fName = f.getName();
System.out.print(fName);
//
System.out.println();
}
}
}获取所有方法及相关细节
import java.lang.annotation.Annotation;
import java.lang.reflect.Method;
import java.lang.reflect.Modifier;
import org.junit.Test;
import com.atguigu.java1.Person;
public class MethodTest {
@Test
public void test1() {
Class clazz = Person.class;
// getMethods():获取到运行时类本身及其所有的父类中声明为public权限的方法
// Method[] methods = clazz.getMethods();
//
// for(Method m : methods){
// System.out.println(m);
// }
// getDeclaredMethods():获取当前运行时类中声明的所有方法
Method[] declaredMethods = clazz.getDeclaredMethods();
for (Method m : declaredMethods) {
System.out.println(m);
}
//
}
// 注解信息
// 权限修饰符 返回值类型 方法名(形参类型1 参数1,形参类型2 参数2,...) throws 异常类型1,...{}
@Test
public void test2() {
Class clazz = Person.class;
Method[] declaredMethods = clazz.getDeclaredMethods();
for (Method m : declaredMethods) {
// 1.获取方法声明的注解
Annotation[] annos = m.getAnnotations();
for (Annotation a : annos) {
System.out.println(a);
}
// 2.权限修饰符
System.out.print(Modifier.toString(m.getModifiers()) + "\t");
// 3.返回值类型
System.out.print(m.getReturnType().getName() + "\t");
// 4.方法名
System.out.print(m.getName());
System.out.print("(");
// 5.形参列表
Class[] parameterTypes = m.getParameterTypes();
if (!(parameterTypes == null && parameterTypes.length == 0)) {
for (int i = 0; i < parameterTypes.length; i++) {
if (i == parameterTypes.length - 1) {
System.out.print(parameterTypes[i].getName() + " args_" + i);
break;
}
System.out.print(parameterTypes[i].getName() + " args_" + i + ",");
}
}
System.out.print(")");
// 6.抛出的异常
Class[] exceptionTypes = m.getExceptionTypes();
if (exceptionTypes.length > 0) {
System.out.print("throws ");
for (int i = 0; i < exceptionTypes.length; i++) {
if (i == exceptionTypes.length - 1) {
System.out.print(exceptionTypes[i].getName());
break;
}
System.out.print(exceptionTypes[i].getName() + ",");
}
}
System.out.println();
}
}
}获取其他结构(构造器、父类、接口、包、注解等)
package com.atguigu.java2;
import com.atguigu.java1.Person;
import org.junit.Test;
import java.lang.annotation.Annotation;
import java.lang.reflect.Constructor;
import java.lang.reflect.ParameterizedType;
import java.lang.reflect.Type;
/**
* @author 尚硅谷-宋红康
* @create 2020 下午 2:47
*/
public class OtherTest {
/*
获取当前类中的所有的构造器
*/
@Test
public void test1(){
Class clazz = Person.class;
Constructor[] cons = clazz.getDeclaredConstructors();
for(Constructor c :cons){
System.out.println(c);
}
}
/*
获取运行时类的父类
*/
@Test
public void test2(){
Class clazz = Person.class;
Class superclass = clazz.getSuperclass();
System.out.println(superclass);//class com.atguigu.java1.Creature
}
/*
获取运行时类的所在的包
*/
@Test
public void test3(){
Class clazz = Person.class;
Package pack = clazz.getPackage();
System.out.println(pack);
}
/*
获取运行时类的注解
*/
@Test
public void test4(){
Class clazz = Person.class;
Annotation[] annos = clazz.getAnnotations();
for (Annotation anno : annos) {
System.out.println(anno);
}
}
/*
获取运行时类所实现的接口
*/
@Test
public void test5(){
Class clazz = Person.class;
Class[] interfaces = clazz.getInterfaces();
for (Class anInterface : interfaces) {
System.out.println(anInterface);
}
}
/*
获取运行时类的带泛型的父类
*/
@Test
public void test6(){
Class clazz = Person.class;
Type genericSuperclass = clazz.getGenericSuperclass();
System.out.println(genericSuperclass);//com.atguigu.java1.Creature<java.lang.String>
}
}获取泛型父类信息
示例代码获取泛型父类信息:
/* Type:
* (1)Class
* (2)ParameterizedType
* 例如:Father<String,Integer>
* ArrayList<String>
* (3)TypeVariable
* 例如:T,U,E,K,V
* (4)WildcardType
* 例如:
* ArrayList<?>
* ArrayList<? super 下限>
* ArrayList<? extends 上限>
* (5)GenericArrayType
* 例如:T[]
*
*/
public class TestGeneric {
public static void main(String[] args) {
//需求:在运行时,获取Son类型的泛型父类的泛型实参<String,Integer>
//(1)还是先获取Class对象
Class clazz = Son.class;//四种形式任意一种都可以
//(2)获取泛型父类
// Class sc = clazz.getSuperclass();
// System.out.println(sc);
/*
* getSuperclass()只能得到父类名,无法得到父类的泛型实参列表
*/
Type type = clazz.getGenericSuperclass();
// Father<String,Integer>属于ParameterizedType
ParameterizedType pt = (ParameterizedType) type;
//(3)获取泛型父类的泛型实参列表
Type[] typeArray = pt.getActualTypeArguments();
for (Type type2 : typeArray) {
System.out.println(type2);
}
}
}
//泛型形参:<T,U>
class Father<T,U>{
}
//泛型实参:<String,Integer>
class Son extends Father<String,Integer>{
}获取内部类或外部类信息
public Class<?>[] getClasses():返回所有公共内部类和内部接口。包括从超类继承的公共类和接口成员以及该类声明的公共类和接口成员。
public Class<?>[] getDeclaredClasses():返回 Class 对象的一个数组,这些对象反映声明为此 Class 对象所表示的类的成员的所有类和接口。包括该类所声明的公共、保护、默认(包)访问及私有类和接口,但不包括继承的类和接口。
public Class<?> getDeclaringClass():如果此 Class 对象所表示的类或接口是一个内部类或内部接口,则返回它的外部类或外部接口,否则返回null。
Class<?> getEnclosingClass() :返回某个内部类的外部类
@Test
public void test5(){
Class<?> clazz = Map.class;
Class<?>[] inners = clazz.getDeclaredClasses();
for (Class<?> inner : inners) {
System.out.println(inner);
}
Class<?> ec = Map.Entry.class;
Class<?> outer = ec.getDeclaringClass();
System.out.println(outer);
}调用运行时类的指定结构
调用指定的属性
在反射机制中,可以直接通过Field类操作类中的属性,通过Field类提供的set()和get()方法就可以完成设置和取得属性内容的操作。
(1)获取该类型的Class对象
Class clazz = Class.forName("包.类名");
(2)获取属性对象
Field field = clazz.getDeclaredField("属性名");
(3)如果属性的权限修饰符不是public,那么需要设置属性可访问
field.setAccessible(true);
(4)创建实例对象:如果操作的是非静态属性,需要创建实例对象
Object obj = clazz.newInstance(); //有公共的无参构造
Object obj = 构造器对象.newInstance(实参...);//通过特定构造器对象创建实例对象
(4)设置指定对象obj上此Field的属性内容
field.set(obj,"属性值");
如果操作静态变量,那么实例对象可以省略,用null表示
(5)取得指定对象obj上此Field的属性内容
Object value = field.get(obj);
如果操作静态变量,那么实例对象可以省略,用null表示
示例代码:
public class Student {
private int id;
private String name;
public int getId() {
return id;
}
public void setId(int id) {
this.id = id;
}
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
@Override
public String toString() {
return "Student{" +
"id=" + id +
", name='" + name + '\'' +
'}';
}
}import java.lang.reflect.Field;
public class TestField {
public static void main(String[] args)throws Exception {
//1、获取Student的Class对象
Class clazz = Class.forName("com.atguigu.reflect.Student");
//2、获取属性对象,例如:id属性
Field idField = clazz.getDeclaredField("id");
//3、如果id是私有的等在当前类中不可访问access的,我们需要做如下操作
idField.setAccessible(true);
//4、创建实例对象,即,创建Student对象
Object stu = clazz.newInstance();
//5、获取属性值
/*
* 以前:int 变量= 学生对象.getId()
* 现在:Object id属性对象.get(学生对象)
*/
Object value = idField.get(stu);
System.out.println("id = "+ value);
//6、设置属性值
/*
* 以前:学生对象.setId(值)
* 现在:id属性对象.set(学生对象,值)
*/
idField.set(stu, 2);
value = idField.get(stu);
System.out.println("id = "+ value);
}
}关于setAccessible方法的使用:
-
Method和Field、Constructor对象都有setAccessible()方法。
-
setAccessible启动和禁用访问安全检查的开关。
-
参数值为true则指示反射的对象在使用时应该取消Java语言访问检查。
-
提高反射的效率。如果代码中必须用反射,而该句代码需要频繁的被调用,那么请设置为true。
-
使得原本无法访问的私有成员也可以访问
-
参数值为false则指示反射的对象应该实施Java语言访问检查。
调用指定的方法
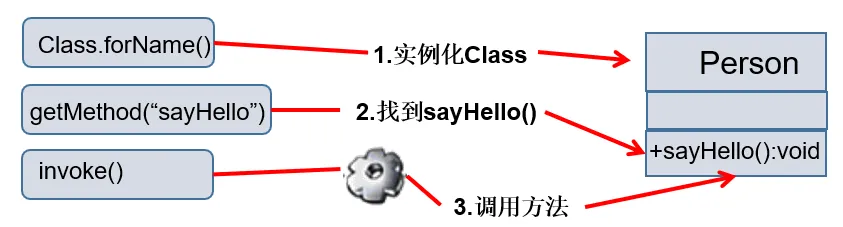
(1)获取该类型的Class对象
Class clazz = Class.forName("包.类名");
(2)获取方法对象
Method method = clazz.getDeclaredMethod("方法名",方法的形参类型列表);
(3)创建实例对象
Object obj = clazz.newInstance();
(4)调用方法
Object result = method.invoke(obj, 方法的实参值列表);
如果方法的权限修饰符修饰的范围不可见,也可以调用setAccessible(true)
如果方法是静态方法,实例对象也可以省略,用null代替
示例代码:
import org.junit.Test;
import java.lang.reflect.Method;
public class TestMethod {
@Test
public void test()throws Exception {
// 1、获取Student的Class对象
Class<?> clazz = Class.forName("com.atguigu.reflect.Student");
//2、获取方法对象
/*
* 在一个类中,唯一定位到一个方法,需要:(1)方法名(2)形参列表,因为方法可能重载
*
* 例如:void setName(String name)
*/
Method setNameMethod = clazz.getDeclaredMethod("setName", String.class);
//3、创建实例对象
Object stu = clazz.newInstance();
//4、调用方法
/*
* 以前:学生对象.setName(值)
* 现在:方法对象.invoke(学生对象,值)
*/
Object setNameMethodReturnValue = setNameMethod.invoke(stu, "张三");
System.out.println("stu = " + stu);
//setName方法返回值类型void,没有返回值,所以setNameMethodReturnValue为null
System.out.println("setNameMethodReturnValue = " + setNameMethodReturnValue);
Method getNameMethod = clazz.getDeclaredMethod("getName");
Object getNameMethodReturnValue = getNameMethod.invoke(stu);
//getName方法返回值类型String,有返回值,getNameMethod.invoke的返回值就是getName方法的返回值
System.out.println("getNameMethodReturnValue = " + getNameMethodReturnValue);//张三
}
@Test
public void test02()throws Exception{
Class<?> clazz = Class.forName("com.atguigu.ext.demo.AtGuiguClass");
Method printInfoMethod = clazz.getMethod("printInfo", String.class);
//printInfo方法是静态方法
printInfoMethod.invoke(null,"尚硅谷");
}
}读取注解信息
一个完整的注解应该包含三个部分:
(1)声明
(2)使用
(3)读取
声明自定义注解
package com.atguigu.annotation;
import java.lang.annotation.*;
@Inherited
@Target(ElementType.TYPE)
@Retention(RetentionPolicy.RUNTIME)
public @interface Table {
String value();
}import java.lang.annotation.*;
@Inherited
@Target(ElementType.FIELD)
@Retention(RetentionPolicy.RUNTIME)
public @interface Column {
String columnName();
String columnType();
}-
自定义注解可以通过四个元注解@Retention,@Target,@Inherited,@Documented,分别说明它的声明周期,使用位置,是否被继承,是否被生成到API文档中。
-
Annotation 的成员在 Annotation 定义中以无参数有返回值的抽象方法的形式来声明,我们又称为配置参数。返回值类型只能是八种基本数据类型、String类型、Class类型、enum类型、Annotation类型、以上所有类型的数组
-
可以使用 default 关键字为抽象方法指定默认返回值
-
如果定义的注解含有抽象方法,那么使用时必须指定返回值,除非它有默认值。格式是“方法名 = 返回值”,如果只有一个抽象方法需要赋值,且方法名为value,可以省略“value=”,所以如果注解只有一个抽象方法成员,建议使用方法名value。
使用自定义注解
package com.atguigu.annotation;
@Table("t_stu")
public class Student {
@Column(columnName = "sid",columnType = "int")
private int id;
@Column(columnName = "sname",columnType = "varchar(20)")
private String name;
public int getId() {
return id;
}
public void setId(int id) {
this.id = id;
}
public String getName() {
return name;
}
public void setName(String name) {
this.name = name;
}
@Override
public String toString() {
return "Student{" +
"id=" + id +
", name='" + name + '\'' +
'}';
}
} 读取和处理自定义注解
自定义注解必须配上注解的信息处理流程才有意义。
我们自己定义的注解,只能使用反射的代码读取。所以自定义注解的声明周期必须是RetentionPolicy.RUNTIME。
import java.lang.reflect.Field;
public class TestAnnotation {
public static void main(String[] args) {
Class studentClass = Student.class;
Table tableAnnotation = (Table) studentClass.getAnnotation(Table.class);
String tableName = "";
if(tableAnnotation != null){
tableName = tableAnnotation.value();
}
Field[] declaredFields = studentClass.getDeclaredFields();
String[] columns = new String[declaredFields.length];
int index = 0;
for (Field declaredField : declaredFields) {
Column column = declaredField.getAnnotation(Column.class);
if(column!= null) {
columns[index++] = column.columnName();
}
}
String sql = "select ";
for (int i=0; i<index; i++) {
sql += columns[i];
if(i<index-1){
sql += ",";
}
}
sql += " from " + tableName;
System.out.println("sql = " + sql);
}
}体会反射的动态性
public class ReflectionTest {
//体会反射的动态性:动态的创建给定字符串对应的类的对象
public <T> T getInstance(String className) throws Exception {
Class clazz = Class.forName(className);
Constructor constructor = clazz.getDeclaredConstructor();
constructor.setAccessible(true);
return (T) constructor.newInstance();
}
@Test
public void test1() throws Exception {
String className = "com.atguigu.java1.Person";
Person p1 = getInstance(className);
System.out.println(p1);
}
}public class ReflectionTest {
//体会反射的动态性:动态的创建指定字符串对应类的对象,并调用指定的方法
public Object invoke(String className,String methodName) throws Exception {
Class clazz = Class.forName(className);
Constructor constructor = clazz.getDeclaredConstructor();
constructor.setAccessible(true);
//动态的创建指定字符串对应类的对象
Object obj = constructor.newInstance();
Method method = clazz.getDeclaredMethod(methodName);
method.setAccessible(true);
return method.invoke(obj);
}
@Test
public void test2() throws Exception {
String info = (String) invoke("com.atguigu.java1.Person", "show");
System.out.println("返回值为:" + info);
}
}public class ReflectionTest {
@Test
public void test1() throws Exception {
//1.加载配置文件,并获取指定的fruitName值
Properties pros = new Properties();
InputStream is = ClassLoader.getSystemClassLoader().getResourceAsStream("config.properties");
pros.load(is);
String fruitStr = pros.getProperty("fruitName");
//2.创建指定全类名对应类的实例
Class clazz = Class.forName(fruitStr);
Constructor constructor = clazz.getDeclaredConstructor();
constructor.setAccessible(true);
Fruit fruit = (Fruit) constructor.newInstance();
//3. 调用相关方法,进行测试
Juicer juicer = new Juicer();
juicer.run(fruit);
}
}
interface Fruit {
public void squeeze();
}
class Apple implements Fruit {
public void squeeze() {
System.out.println("榨出一杯苹果汁儿");
}
}
class Orange implements Fruit {
public void squeeze() {
System.out.println("榨出一杯桔子汁儿");
}
}
class Juicer {
public void run(Fruit f) {
f.squeeze();
}
}新特性
Lambda表达式
Lambda 是一个匿名函数,我们可以把 Lambda 表达式理解为是一段可以传递的代码(将代码像数据一样进行传递)。使用它可以写出更简洁、更灵活的代码。作为一种更紧凑的代码风格,使 Java 的语言表达能力得到了提升
语法
Lambda 表达式:在 Java8 语言中引入的一种新的语法元素和操作符。这个操作符为 “->” , 该操作符被称为 Lambda 操作符或箭头操作符。它将 Lambda 分为两个部分:
-
左侧:指定了 Lambda 表达式需要的参数列表
-
右侧:指定了 Lambda 体,是抽象方法的实现逻辑,也即 Lambda 表达式要执行的功能
**语法格式一:**无参,无返回值
@Test
public void test1(){
//未使用Lambda表达式
Runnable r1 = new Runnable() {
@Override
public void run() {
System.out.println("我爱北京天安门");
}
};
r1.run();
System.out.println("***********************");
//使用Lambda表达式
Runnable r2 = () -> {
System.out.println("我爱北京故宫");
};
r2.run();
}**语法格式二:**Lambda 需要一个参数,但是没有返回值
@Test
public void test2(){
//未使用Lambda表达式
Consumer<String> con = new Consumer<String>() {
@Override
public void accept(String s) {
System.out.println(s);
}
};
con.accept("谎言和誓言的区别是什么?");
System.out.println("*******************");
//使用Lambda表达式
Consumer<String> con1 = (String s) -> {
System.out.println(s);
};
con1.accept("一个是听得人当真了,一个是说的人当真了");
}**语法格式三:**数据类型可以省略,因为可由编译器推断得出,称为“类型推断”
@Test
public void test3(){
//语法格式三使用前
Consumer<String> con1 = (String s) -> {
System.out.println(s);
};
con1.accept("一个是听得人当真了,一个是说的人当真了");
System.out.println("*******************");
//语法格式三使用后
Consumer<String> con2 = (s) -> {
System.out.println(s);
};
con2.accept("一个是听得人当真了,一个是说的人当真了");
}**语法格式四:**Lambda 若只需要一个参数时,参数的小括号可以省略
@Test
public void test4(){
//语法格式四使用前
Consumer<String> con1 = (s) -> {
System.out.println(s);
};
con1.accept("一个是听得人当真了,一个是说的人当真了");
System.out.println("*******************");
//语法格式四使用后
Consumer<String> con2 = s -> {
System.out.println(s);
};
con2.accept("一个是听得人当真了,一个是说的人当真了");
}**语法格式五:**Lambda 需要两个或以上的参数,多条执行语句,并且可以有返回值
@Test
public void test5(){
//语法格式五使用前
Comparator<Integer> com1 = new Comparator<Integer>() {
@Override
public int compare(Integer o1, Integer o2) {
System.out.println(o1);
System.out.println(o2);
return o1.compareTo(o2);
}
};
System.out.println(com1.compare(12,21));
System.out.println("*****************************");
//语法格式五使用后
Comparator<Integer> com2 = (o1,o2) -> {
System.out.println(o1);
System.out.println(o2);
return o1.compareTo(o2);
};
System.out.println(com2.compare(12,6));
}**语法格式六:**当 Lambda 体只有一条语句时,return 与大括号若有,都可以省略
@Test
public void test6(){
//语法格式六使用前
Comparator<Integer> com1 = (o1,o2) -> {
return o1.compareTo(o2);
};
System.out.println(com1.compare(12,6));
System.out.println("*****************************");
//语法格式六使用后
Comparator<Integer> com2 = (o1,o2) -> o1.compareTo(o2);
System.out.println(com2.compare(12,21));
}
@Test
public void test7(){
//语法格式六使用前
Consumer<String> con1 = s -> {
System.out.println(s);
};
con1.accept("一个是听得人当真了,一个是说的人当真了");
System.out.println("*****************************");
//语法格式六使用后
Consumer<String> con2 = s -> System.out.println(s);
con2.accept("一个是听得人当真了,一个是说的人当真了");
}关于类型推断
在语法格式三 Lambda 表达式中的参数类型都是由编译器推断得出的。Lambda 表达式中无需指定类型,程序依然可以编译,这是因为 javac 根据程序的上下文,在后台推断出了参数的类型。Lambda 表达式的类型依赖于上下文环境,是由编译器推断出来的。这就是所谓的“类型推断”
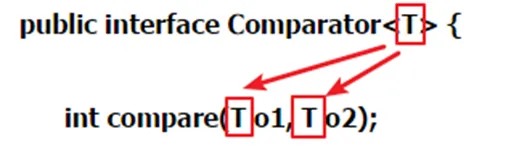
@Test
public void test() {
//类型推断1
ArrayList<String> list = new ArrayList<>();
//类型推断2
int[] arr = {1, 2, 3};
}函数式接口
什么是函数式
-
只包含
一个抽象方法(Single Abstract Method,简称SAM)的接口,称为函数式接口。当然该接口可以包含其他非抽象方法 -
你可以通过 Lambda 表达式来创建该接口的对象。(若 Lambda 表达式抛出一个受检异常(即:非运行时异常),那么该异常需要在目标接口的抽象方法上进行声明)
-
我们可以在一个接口上使用
@FunctionalInterface注解,这样做可以检查它是否是一个函数式接口。同时 javadoc 也会包含一条声明,说明这个接口是一个函数式接口 -
在
java.util.function包下定义了Java 8 的丰富的函数式接口
举例
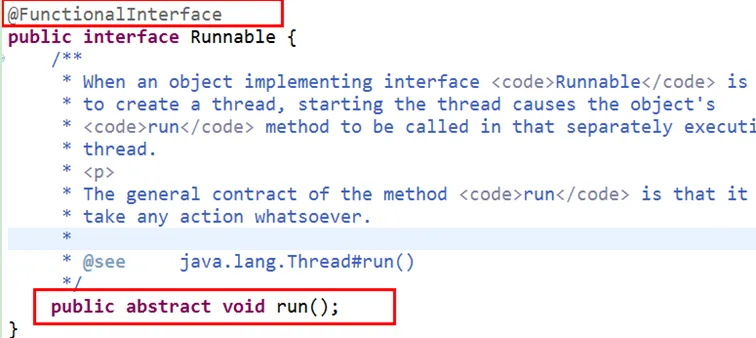
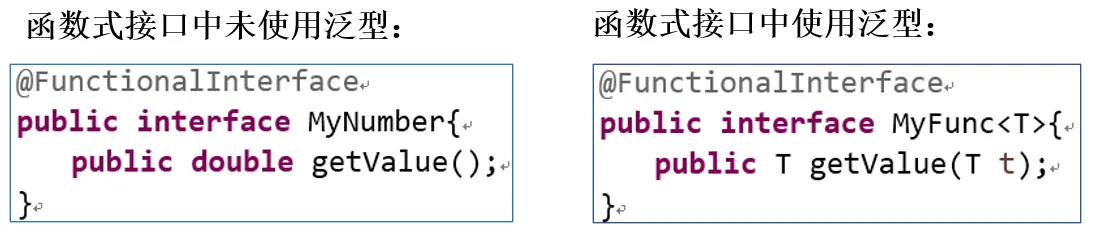
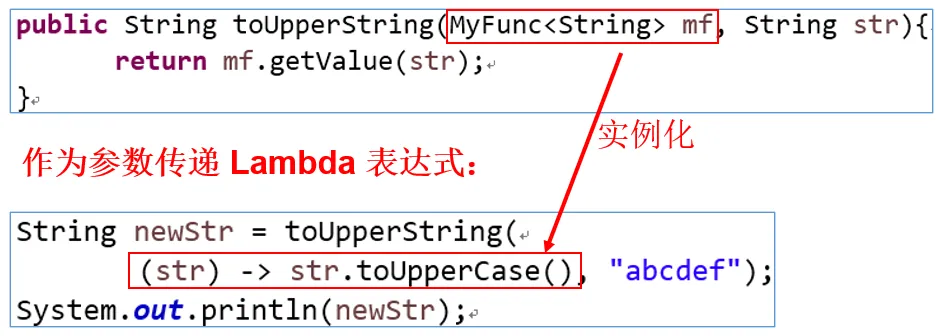
作为参数传递 Lambda 表达式:为了将 Lambda 表达式作为参数传递,接收Lambda 表达式的参数类型必须是与该 Lambda 表达式兼容的函数式接口的类型
方法引用与构造器引用
方法引用
-
格式:使用方法引用操作符 “
::” 将类(或对象) 与 方法名分隔开来。 -
两个:中间不能有空格,而且必须英文状态下半角输入
-
如下三种主要使用情况:
-
情况1:
对象 :: 实例方法名 -
情况2:
类 :: 静态方法名 -
情况3:
类 :: 实例方法名
使用前提
**要求1:**Lambda 体只有一句语句,并且是通过调用一个对象的/类现有的方法来完成的
例如:System.out对象,调用println()方法来完成 Lambda 体
Math 类,调用random()静态方法来完成 Lambda 体
要求2:
针对情况1:函数式接口中的抽象方法a在被重写时使用了某一个对象的方法b。如果方法a的形参列表、返回值类型与方法b的形参列表、返回值类型都相同,则我们可以使用方法b实现对方法a的重写、替换
针对情况2:函数式接口中的抽象方法a在被重写时使用了某一个类的静态方法b。如果方法a的形参列表、返回值类型与方法b的形参列表、返回值类型都相同,则我们可以使用方法b实现对方法a的重写、替换
针对情况3:函数式接口中的抽象方法a在被重写时使用了某一个对象的方法b。如果方法a的返回值类型与方法b的返回值类型相同,同时方法a的形参列表中有n个参数,方法b的形参列表有n-1个参数,且方法a的第1个参数作为方法b的调用者,且方法a的后 n-1 参数与方法b的n-1参数匹配(类型相同或满足多态场景也可以)
例如:t->System.out.println(t)
() -> Math.random() 都是无参
例子
public class MethodRefTest {
// 情况一:对象 :: 实例方法
//Consumer中的void accept(T t)
//PrintStream中的void println(T t)
@Test
public void test1() {
Consumer<String> con1 = str -> System.out.println(str);
con1.accept("北京");
System.out.println("*******************");
PrintStream ps = System.out;
Consumer<String> con2 = ps::println;
con2.accept("beijing");
}
//Supplier中的T get()
//Employee中的String getName()
@Test
public void test2() {
Employee emp = new Employee(1001,"Tom",23,5600);
Supplier<String> sup1 = () -> emp.getName();
System.out.println(sup1.get());
System.out.println("*******************");
Supplier<String> sup2 = emp::getName;
System.out.println(sup2.get());
}
// 情况二:类 :: 静态方法
//Comparator中的int compare(T t1,T t2)
//Integer中的int compare(T t1,T t2)
@Test
public void test3() {
Comparator<Integer> com1 = (t1,t2) -> Integer.compare(t1,t2);
System.out.println(com1.compare(12,21));
System.out.println("*******************");
Comparator<Integer> com2 = Integer::compare;
System.out.println(com2.compare(12,3));
}
//Function中的R apply(T t)
//Math中的Long round(Double d)
@Test
public void test4() {
Function<Double,Long> func = new Function<Double, Long>() {
@Override
public Long apply(Double d) {
return Math.round(d);
}
};
System.out.println("*******************");
Function<Double,Long> func1 = d -> Math.round(d);
System.out.println(func1.apply(12.3));
System.out.println("*******************");
Function<Double,Long> func2 = Math::round;
System.out.println(func2.apply(12.6));
}
// 情况三:类 :: 实例方法 (有难度)
// Comparator中的int comapre(T t1,T t2)
// String中的int t1.compareTo(t2)
@Test
public void test5() {
Comparator<String> com1 = (s1,s2) -> s1.compareTo(s2);
System.out.println(com1.compare("abc","abd"));
System.out.println("*******************");
Comparator<String> com2 = String :: compareTo;
System.out.println(com2.compare("abd","abm"));
}
//BiPredicate中的boolean test(T t1, T t2);
//String中的boolean t1.equals(t2)
@Test
public void test6() {
BiPredicate<String,String> pre1 = (s1,s2) -> s1.equals(s2);
System.out.println(pre1.test("abc","abc"));
System.out.println("*******************");
BiPredicate<String,String> pre2 = String :: equals;
System.out.println(pre2.test("abc","abd"));
}
// Function中的R apply(T t)
// Employee中的String getName();
@Test
public void test7() {
Employee employee = new Employee(1001, "Jerry", 23, 6000);
Function<Employee,String> func1 = e -> e.getName();
System.out.println(func1.apply(employee));
System.out.println("*******************");
Function<Employee,String> func2 = Employee::getName;
System.out.println(func2.apply(employee));
}
}构造器引用
当Lambda表达式是创建一个对象,并且满足Lambda表达式形参,正好是给创建这个对象的构造器的实参列表,就可以使用构造器引用
格式:类名::new
例子
public class ConstructorRefTest {
//构造器引用
//Supplier中的T get()
//Employee的空参构造器:Employee()
@Test
public void test1(){
Supplier<Employee> sup = new Supplier<Employee>() {
@Override
public Employee get() {
return new Employee();
}
};
System.out.println("*******************");
Supplier<Employee> sup1 = () -> new Employee();
System.out.println(sup1.get());
System.out.println("*******************");
Supplier<Employee> sup2 = Employee :: new;
System.out.println(sup2.get());
}
//Function中的R apply(T t)
@Test
public void test2(){
Function<Integer,Employee> func1 = id -> new Employee(id);
Employee employee = func1.apply(1001);
System.out.println(employee);
System.out.println("*******************");
Function<Integer,Employee> func2 = Employee :: new;
Employee employee1 = func2.apply(1002);
System.out.println(employee1);
}
//BiFunction中的R apply(T t,U u)
@Test
public void test3(){
BiFunction<Integer,String,Employee> func1 = (id,name) -> new Employee(id,name);
System.out.println(func1.apply(1001,"Tom"));
System.out.println("*******************");
BiFunction<Integer,String,Employee> func2 = Employee :: new;
System.out.println(func2.apply(1002,"Tom"));
}
}数组构造引用
当 Lambda 表达式是创建一个数组对象,并且满足 Lambda 表达式形参,正好是给创建这个数组对象的长度,就可以数组构造引用
格式:数组类型名::new
例子:
//数组引用
//Function中的R apply(T t)
@Test
public void test4(){
Function<Integer,String[]> func1 = length -> new String[length];
String[] arr1 = func1.apply(5);
System.out.println(Arrays.toString(arr1));
System.out.println("*******************");
Function<Integer,String[]> func2 = String[] :: new;
String[] arr2 = func2.apply(10);
System.out.println(Arrays.toString(arr2));
}Stream API
Stream 是 Java8 中处理集合的关键抽象概念,它可以指定你希望对集合进行的操作,可以执行非常复杂的查找、过滤和映射数据等操作。 **使用Stream API 对集合数据进行操作,就类似于使用 SQL 执行的数据库查询。**也可以使用 Stream API 来并行执行操作。简言之,Stream API 提供了一种高效且易于使用的处理数据的方式
实际开发中,项目中多数数据源都来自于 MySQL、Oracle 等。但现在数据源可以更多了,有 MongoDB,Redis 等,而这些 NoSQL 的数据就需要 Java 层面去处理
Stream 是数据渠道,用于操作数据源(集合、数组等)所生成的元素序列
Stream 和 Collection 集合的区别:**Collection 是一种静态的内存数据结构,讲的是数据,而 Stream 是有关计算的,讲的是计算。**前者是主要面向内存,存储在内存中,后者主要是面向 CPU,通过 CPU 实现计算
注意:
①Stream 自己不会存储元素
②Stream 不会改变源对象。相反,他们会返回一个持有结果的新Stream
③Stream 操作是延迟执行的。这意味着他们会等到需要结果的时候才执行。即一旦执行终止操作,就执行中间操作链,并产生结果
④ Stream一旦执行了终止操作,就不能再调用其它中间操作或终止操作了
Stream 操作的三个步骤
1- 创建 Stream一个数据源(如:集合、数组),获取一个流
2- 中间操作每次处理都会返回一个持有结果的新 Stream,即中间操作的方法返回值仍然是 Stream 类型的对象。因此中间操作可以是个操作链,可对数据源的数据进行 n 次处理,但是在终结操作前,并不会真正执行
**3- 终止操作(终端操作)**终止操作的方法返回值类型就不再是 Stream 了,因此一旦执行终止操作,就结束整个 Stream 操作了。一旦执行终止操作,就执行中间操作链,最终产生结果并结束 Stream
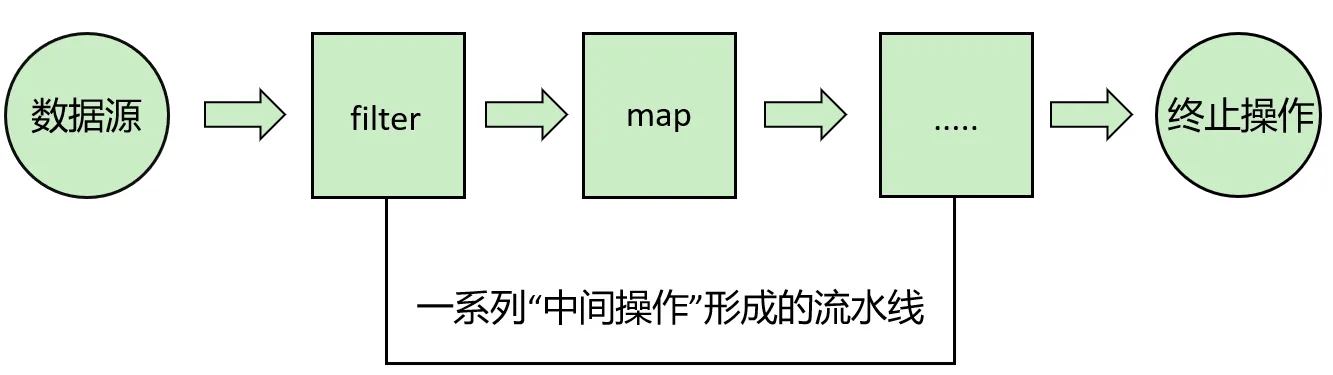
创建 Stream 实例
方式一:通过集合
Java8 中的 Collection 接口被扩展,提供了两个获取流的方法:
-
default Stream stream(): 返回一个顺序流 -
default Stream parallelStream(): 返回一个并行流
@Test
public void test01(){
List<Integer> list = Arrays.asList(1,2,3,4,5);
//JDK1.8中,Collection系列集合增加了方法
Stream<Integer> stream = list.stream();
}方式二:通过数组
Java8 中的 Arrays 的静态方法 stream() 可以获取数组流:
-
static Stream stream(T[] array): 返回一个流 -
public static IntStream stream(int[] array) -
public static LongStream stream(long[] array) -
public static DoubleStream stream(double[] array)
@Test
public void test02(){
String[] arr = {"hello","world"};
Stream<String> stream = Arrays.stream(arr);
}
@Test
public void test03(){
int[] arr = {1,2,3,4,5};
IntStream stream = Arrays.stream(arr);
}方式三:通过Stream的of()
可以调用 Stream 类静态方法 of(), 通过显示值创建一个流。它可以接收任意数量的参数
public static Stream of(T... values): 返回一个流
@Test
public void test04(){
Stream<Integer> stream = Stream.of(1,2,3,4,5);
stream.forEach(System.out::println);
}方式四:创建无限流(了解)
可以使用静态方法 Stream.iterate() 和 Stream.generate(), 创建无限流
-
迭代
public static Stream iterate(final T seed, final UnaryOperator f) -
生成
public static Stream generate(Supplier s)
// 方式四:创建无限流
@Test
public void test05() {
// 迭代
// public static<T> Stream<T> iterate(final T seed, final
// UnaryOperator<T> f)
Stream<Integer> stream = Stream.iterate(0, x -> x + 2);
stream.limit(10).forEach(System.out::println);
// 生成
// public static<T> Stream<T> generate(Supplier<T> s)
Stream<Double> stream1 = Stream.generate(Math::random);
stream1.limit(10).forEach(System.out::println);
}一系列中间操作
多个中间操作可以连接起来形成一个流水线,除非流水线上触发终止操作,否则中间操作不会执行任何的处理!而在终止操作时一次性全部处理,称为“惰性求值”
1-筛选与切片
| 方 法 | 描 述 |
|---|---|
| filter(Predicatep) | 接收 Lambda , 从流中排除某些元素 |
| distinct() | 筛选,通过流所生成元素的 hashCode() 和 equals() 去除重复元素 |
| limit(long maxSize) | 截断流,使其元素不超过给定数量 |
| skip(long n) | 跳过元素,返回一个扔掉了前 n 个元素的流。 若流中元素不足 n 个,则返回一个空流。与 limit(n) 互补 |
2-映射
| 方法 | 描述 |
|---|---|
| map(Function f) | 接收一个函数作为参数,该函数会被应用到每个元素上,并将其映射成一个新的元素。 |
| mapToDouble(ToDoubleFunction f) | 接收一个函数作为参数,该函数会被应用到每个元素上,产生一个新的 DoubleStream。 |
| mapToInt(ToIntFunction f) | 接收一个函数作为参数,该函数会被应用到每个元素上,产生一个新的 IntStream。 |
| mapToLong(ToLongFunction f) | 接收一个函数作为参数,该函数会被应用到每个元素上,产生一个新的 LongStream。 |
| flatMap(Function f) | 接收一个函数作为参数,将流中的每个值都换成另一个流,然后把所有流连接成一个流 |
3-排序
| 方法 | 描述 |
|---|---|
| sorted() | 产生一个新流,其中按自然顺序排序 |
| sorted(Comparatorcom) | 产生一个新流,其中按比较器顺序排序 |
代码示例:
package com.atguigu.stream;
import org.junit.Test;
import java.util.Arrays;
import java.util.stream.Stream;
public class StreamMiddleOperate {
@Test
public void test01(){
//1、创建Stream
Stream<Integer> stream = Stream.of(1,2,3,4,5,6);
//2、加工处理
//过滤:filter(Predicate p)
//把里面的偶数拿出来
/*
* filter(Predicate p)
* Predicate是函数式接口,抽象方法:boolean test(T t)
*/
stream = stream.filter(t -> t%2==0);
//3、终结操作:例如:遍历
stream.forEach(System.out::println);
}
@Test
public void test02(){
Stream.of(1,2,3,4,5,6)
.filter(t -> t%2==0)
.forEach(System.out::println);
}
@Test
public void test03(){
Stream.of(1,2,3,4,5,6,2,2,3,3,4,4,5)
.distinct()
.forEach(System.out::println);
}
@Test
public void test04(){
Stream.of(1,2,3,4,5,6,2,2,3,3,4,4,5)
.limit(3)
.forEach(System.out::println);
}
@Test
public void test05(){
Stream.of(1,2,2,3,3,4,4,5,2,3,4,5,6,7)
.distinct() //(1,2,3,4,5,6,7)
.filter(t -> t%2!=0) //(1,3,5,7)
.limit(3)
.forEach(System.out::println);
}
@Test
public void test06(){
Stream.of(1,2,3,4,5,6,2,2,3,3,4,4,5)
.skip(5)
.forEach(System.out::println);
}
@Test
public void test07(){
Stream.of(1,2,3,4,5,6,2,2,3,3,4,4,5)
.skip(5)
.distinct()
.filter(t -> t%3==0)
.forEach(System.out::println);
}
@Test
public void test08(){
long count = Stream.of(1,2,3,4,5,6,2,2,3,3,4,4,5)
.distinct()
.peek(System.out::println) //Consumer接口的抽象方法 void accept(T t)
.count();
System.out.println("count="+count);
}
@Test
public void test09(){
//希望能够找出前三个最大值,前三名最大的,不重复
Stream.of(11,2,39,4,54,6,2,22,3,3,4,54,54)
.distinct()
.sorted((t1,t2) -> -Integer.compare(t1, t2))//Comparator接口 int compare(T t1, T t2)
.limit(3)
.forEach(System.out::println);
}
@Test
public void test10(){
Stream.of(1,2,3,4,5)
.map(t -> t+=1)//Function<T,R>接口抽象方法 R apply(T t)
.forEach(System.out::println);
}
@Test
public void test11(){
String[] arr = {"hello","world","java"};
Arrays.stream(arr)
.map(t->t.toUpperCase())
.forEach(System.out::println);
}
@Test
public void test12(){
String[] arr = {"hello","world","java"};
Arrays.stream(arr)
.flatMap(t -> Stream.of(t.split("|")))//Function<T,R>接口抽象方法 R apply(T t) 现在的R是一个Stream
.forEach(System.out::println);
}
}终止操作
-
终端操作会从流的流水线生成结果。其结果可以是任何不是流的值,例如:List、Integer,甚至是 void
-
流进行了终止操作后,不能再次使用
1-匹配与查找
| 方法 | 描述 |
|---|---|
| allMatch(Predicate p) | 检查是否匹配所有元素 |
| anyMatch(Predicate p) | 检查是否至少匹配一个元素 |
| noneMatch(Predicatep) | 检查是否没有匹配所有元素 |
| findFirst() | 返回第一个元素 |
| findAny() | 返回当前流中的任意元素 |
| count() | 返回流中元素总数 |
| max(Comparator c) | 返回流中最大值 |
| min(Comparator c) | 返回流中最小值 |
| forEach(Consumer c) | 内部迭代(使用 Collection 接口需要用户去做迭代,称为外部迭代。 相反,Stream API 使用内部迭代——它帮你把迭代做了) |
2-归约
| 方法 | 描述 |
|---|---|
| reduce(T identity, BinaryOperator b) | 可以将流中元素反复结合起来,得到一个值。返回 T |
| reduce(BinaryOperator b) | 可以将流中元素反复结合起来,得到一个值。返回 Optional |
备注:map 和 reduce 的连接通常称为 map-reduce 模式,因 Google 用它来进行网络搜索而出名
3-收集
| 方 法 | 描 述 |
|---|---|
| collect(Collector c) | 将流转换为其他形式。接收一个 Collector接口的实现, 用于给Stream中元素做汇总的方法 |
Collector 接口中方法的实现决定了如何对流执行收集的操作(如收集到 List、Set、Map)
另外, Collectors 实用类提供了很多静态方法,可以方便地创建常见收集器实例,具体方法与实例如下表:
| 方法 | 返回类型 | 作用 |
|---|---|---|
| toList | Collector<T, ?, List> | 把流中元素收集到List |
List<Employee> emps= list.stream().collect(Collectors.toList());| 方法 | 返回类型 | 作用 |
|---|---|---|
| toSet | Collector<T, ?, Set> | 把流中元素收集到Set |
Set<Employee> emps= list.stream().collect(Collectors.toSet());| 方法 | 返回类型 | 作用 |
|---|---|---|
| toCollection | Collector<T, ?, C> | 把流中元素收集到创建的集合 |
Collection<Employee> emps =list.stream().collect(Collectors.toCollection(ArrayList::new));| 方法 | 返回类型 | 作用 |
|---|---|---|
| counting | Collector<T, ?, Long> | 计算流中元素的个数 |
long count = list.stream().collect(Collectors.counting());| 方法 | 返回类型 | 作用 |
|---|---|---|
| summingInt | Collector<T, ?, Integer> | 对流中元素的整数属性求和 |
int total=list.stream().collect(Collectors.summingInt(Employee::getSalary));| 方法 | 返回类型 | 作用 |
|---|---|---|
| averagingInt | Collector<T, ?, Double> | 计算流中元素Integer属性的平均值 |
double avg = list.stream().collect(Collectors.averagingInt(Employee::getSalary));| 方法 | 返回类型 | 作用 |
|---|---|---|
| summarizingInt | Collector<T, ?, IntSummaryStatistics> | 收集流中Integer属性的统计值。如:平均值 |
int SummaryStatisticsiss= list.stream().collect(Collectors.summarizingInt(Employee::getSalary));| 方法 | 返回类型 | 作用 |
|---|---|---|
| joining | Collector<CharSequence, ?, String> | 连接流中每个字符串 |
String str= list.stream().map(Employee::getName).collect(Collectors.joining());| 方法 | 返回类型 | 作用 |
|---|---|---|
| maxBy | Collector<T, ?, Optional> | 根据比较器选择最大值 |
Optional<Emp>max= list.stream().collect(Collectors.maxBy(comparingInt(Employee::getSalary)));| 方法 | 返回类型 | 作用 |
|---|---|---|
| minBy | Collector<T, ?, Optional> | 根据比较器选择最小值 |
Optional<Emp> min = list.stream().collect(Collectors.minBy(comparingInt(Employee::getSalary)));| 方法 | 返回类型 | 作用 |
|---|---|---|
| collectingAndThen | Collector<T,A,RR> | 包裹另一个收集器,对其结果转换函数 |
int how= list.stream().collect(Collectors.collectingAndThen(Collectors.toList(), List::size));| 方法 | 返回类型 | 作用 |
|---|---|---|
| groupingBy | Collector<T, ?, Map<K, List>> | 根据某属性值对流分组,属性为K,结果为V |
Map<Emp.Status, List<Emp>> map= list.stream().collect(Collectors.groupingBy(Employee::getStatus));| 方法 | 返回类型 | 作用 |
|---|---|---|
| partitioningBy | Collector<T, ?, Map<Boolean, List>> | 根据true或false进行分区 |
Map<Boolean,List<Emp>> vd = list.stream().collect(Collectors.partitioningBy(Employee::getManage));举例:
import java.util.List;
import java.util.Optional;
import java.util.stream.Collectors;
import java.util.stream.Stream;
import org.junit.Test;
public class StreamEndding {
@Test
public void test01(){
Stream.of(1,2,3,4,5)
.forEach(System.out::println);
}
@Test
public void test02(){
long count = Stream.of(1,2,3,4,5)
.count();
System.out.println("count = " + count);
}
@Test
public void test03(){
boolean result = Stream.of(1,3,5,7,9)
.allMatch(t -> t%2!=0);
System.out.println(result);
}
@Test
public void test04(){
boolean result = Stream.of(1,3,5,7,9)
.anyMatch(t -> t%2==0);
System.out.println(result);
}
@Test
public void test05(){
Optional<Integer> opt = Stream.of(1,3,5,7,9).findFirst();
System.out.println(opt);
}
@Test
public void test06(){
Optional<Integer> opt = Stream.of(1,2,3,4,5,7,9)
.filter(t -> t%3==0)
.findFirst();
System.out.println(opt);
}
@Test
public void test07(){
Optional<Integer> opt = Stream.of(1,2,4,5,7,8)
.filter(t -> t%3==0)
.findFirst();
System.out.println(opt);
}
@Test
public void test08(){
Optional<Integer> max = Stream.of(1,2,4,5,7,8)
.max((t1,t2) -> Integer.compare(t1, t2));
System.out.println(max);
}
@Test
public void test09(){
Integer reduce = Stream.of(1,2,4,5,7,8)
.reduce(0, (t1,t2) -> t1+t2);//BinaryOperator接口 T apply(T t1, T t2)
System.out.println(reduce);
}
@Test
public void test10(){
Optional<Integer> max = Stream.of(1,2,4,5,7,8)
.reduce((t1,t2) -> t1>t2?t1:t2);//BinaryOperator接口 T apply(T t1, T t2)
System.out.println(max);
}
@Test
public void test11(){
List<Integer> list = Stream.of(1,2,4,5,7,8)
.filter(t -> t%2==0)
.collect(Collectors.toList());
System.out.println(list);
}
}